Kling AI · MCP + CLI 0.2.1
Gere vídeos e imagens no Kling por comando
O Kling AI dentro do seu terminal e do seu assistente de IA: texto→vídeo, imagem→vídeo, geração em lote e dublagem com voz clonada.
O Kling AI dentro do seu terminal e do seu assistente de IA: texto→vídeo, imagem→vídeo, geração em lote e dublagem com voz clonada.
A documentação da CLI 0.2.1 (28/09) já traz a 4.0. Em 09/10 ela ainda não estava liberada em todas as contas: a liberação é conta por conta. Confira na sua com kling who_am_i (não gasta crédito).
Vídeos de 3 a 30 s (antes 15 s), 720p/1080p, até 10 quadros-chave (primeiro, intermediários e último). Texto→vídeo, imagem→vídeo e Omni-Ref.
De 3 a 20 s, só 720p. Imagem→vídeo só com o primeiro quadro: o último quadro (--tailImage) é recusado.
Mistura até 10 imagens, 5 vídeos e 7 Elements numa geração. Cobrado por segundo, contando também o vídeo de entrada.
A Kling ainda não publicou o custo da 4.0. Como referência, a 3.0 vai de ~6 créditos/s (720p sem som) a ~30 créditos/s (4K). Pela CLI/MCP o consumo é o mesmo do site: sem geração grátis fora do pico e sem créditos bônus.
--model agora é obrigatório e usa o nome completo do who_am_i (ex.: kling-video-v3_0_turbo); --omni/--flash saíram. Novos: omni_ref_video, Elements, Motion Control, --input por quadro e feedback.
# atualizar e ver se a sua conta já tem a 4.0
npm i -g @klingai/cli-global@latest
kling who_am_i | grep -o 'kling-video-v4_0[a-z_]*' | sort -u

# primeiro + meio + último quadro (quando liberada)
kling image_to_video --model kling-video-v4_0 \
  --input first_image=./first.jpg --input keyframe_1=./meio.jpg \
  --input tail_image=./last.jpg --poll 300
O Kling oferece duas portas oficiais de automação — o MCP (para assistentes como Claude e Cursor) e o CLI (para terminal, scripts e CI). Este projeto documenta as duas e o pipeline completo de produção de vídeo.
text_to_video, image_to_video, text_to_image e image_to_image — os modelos Kling 3.0 (até 4K, multi-shot, áudio nativo), a 4.0 em preview e também Nano Banana 2/Pro e GPT-Image-2 na mesma CLI.
Jobs assíncronos com generation_id, poll por status, lote de até 4 variações por request e integração em scripts, Makefiles e pipelines de CI.
Receita completa para trocar o áudio nativo por uma voz clonada mantendo o lip-sync: transcrição com timestamps, TTS multi-tomada e alinhamento por compasso.
O fluxo de produção que o guia ensina, de ponta a ponta:
Conta no Kling AI (créditos pagos — sem geração off-peak grátis via MCP/CLI), Node.js e ffmpeg para a pós-produção.
Instala global via npm e autentica por OAuth no navegador.
# instalar + login
npm i -g @klingai/cli-global
kling login
Para usar direto no Claude ou Cursor, sem terminal (instale um OU outro, nunca os dois).
# conector MCP
"klingai": {"url": "https://kling.ai/mcp"}
Concat, troca de áudio e montagem de trilha de dublagem.
# checar
ffmpeg -version
Comandos reais — cada geração retorna um generation_id; o resultado sai como URL que expira em 24h.
Sempre chame primeiro — retorna os modelos disponíveis e os parâmetros exatos de cada um. Desde a CLI 0.2.1 todo comando de geração exige --model com um nome desta lista.
kling who_am_i   # modelos, durações, resoluções, parâmetros
kling account    # plano e créditos
720p/1k gasta menos créditos; suba a resolução só quando o resultado valer.
kling text_to_image --model kling-image-v3_0 "cidade futurista ao entardecer, luz dourada, cinematográfico" --poll
Para 1 imagem, o kling3.0-turbo é o melhor custo-benefício. Fala em PT? Escreva o prompt inteiro em português, com a fala entre aspas.
kling image_to_video --image cena.png --model kling-video-v3_0_turbo \
  --resolution 720p "câmera avança lentamente, atmosfera cinematográfica" --poll
Jobs não podem ser cancelados e as URLs de resultado expiram em 24 horas — salve o generation_id e baixe assim que completar.
kling query_tasks <generation_id>   # status + works[].url
curl -o video.mp4 "<works[].url>"
Clipes com specs iguais concatenam sem re-encode. Para voz própria, use a receita de dublagem do guia (transcrição com timestamps + TTS por frase + alinhamento por compasso).
# concatenar clipes
printf "file 'c1.mp4'\nfile 'c2.mp4'\n" > lista.txt
ffmpeg -f concat -safe 0 -i lista.txt -c copy final.mp4
# trocar o áudio pela narração dublada
ffmpeg -i final.mp4 -i narracao.wav -map 0:v -map 1:a -c:v copy saida.mp4
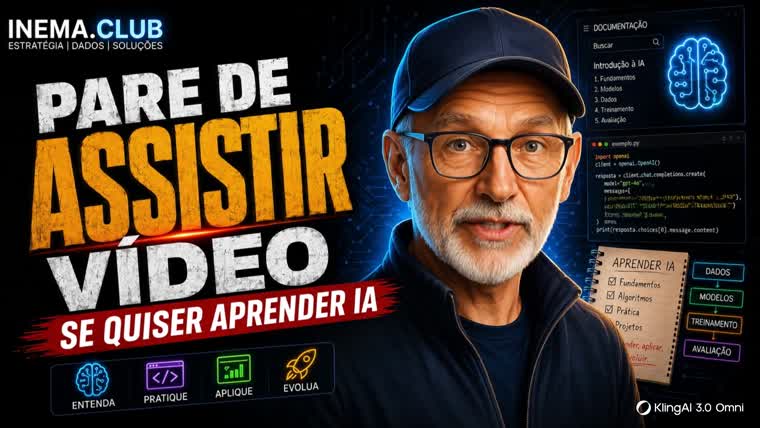
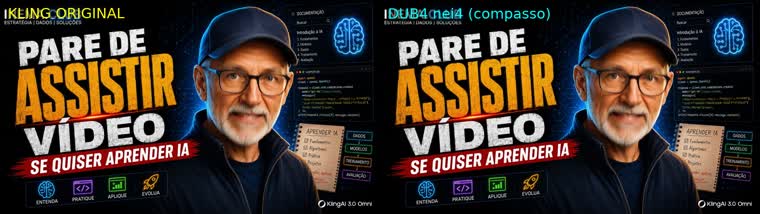
Avatar falante gerado do zero: thumbnail estática → image_to_video com prompt em PT-BR → dublagem com voz clonada alinhada por compasso.
O que já funciona e o que vem por aí.
--model obrigatório documentados.