📖 Glosario vivo (lee antes — vuelve siempre que lo necesites)
En el módulo 1.1 fijaste el vocabulario básico (modelo, prompt, agente, skill, codebase, harness). Aquí entran los términos nuevos de este módulo. Fija estos antes de seguir:
⏳ Qué es la Bitter Lesson
🧠 Imagínalo así: dos equipos de ajedrez. El equipo A pasa años enseñando a mano reglas ingeniosas ("en esta posición, haz esto"). El equipo B simplemente enciende una computadora gigante que juega millones de partidas contra sí misma. Al principio gana el equipo A. Pero la computadora se vuelve más fuerte cada año y, con el tiempo, arrasa con todas las reglas humanas. Esa es la lección amarga.
En 2019, el investigador Rich Sutton escribió un breve ensayo llamado "The Bitter Lesson" (la Lección Amarga). La tesis: a lo largo de décadas de machine learning (ML), siempre que los investigadores intentaron integrar el «conocimiento humano inteligente» en el sistema, perdieron —a largo plazo— frente a enfoques sencillos que solo añadían más compute en el problema. Ajedrez, Go, reconocimiento de voz, visión: en todos, la fuerza bruta de cálculo superó las optimizaciones artesanales.
¿Por qué «amarga»? Porque es humillante para alguien inteligente. Nosotros quiere que la astucia humana prevalezca. Pero el motor detrás de la lección es simple e implacable: el cómputo crece muy rápido y se vuelve más barato año tras año. Sus optimizaciones manuales son fijas; el compute es una marea que no deja de subir. Como resume Pocock en el video, la lección es «confía en que lo que hay debajo va a mejorar" — el modelo se volverá más potente por sí solo, así que no vale tanto la pena adornarlo a mano. Error común: creer que la Lección Amarga es una ley mágica que se aplica a todo, siempre y sin límites. No lo es: habla de una dimensión (el cerebro del modelo). Guarda esta salvedad: el resto del módulo trata precisamente sobre dónde ella no se aplica.
La astucia humana es casi una línea recta. El compute es una curva ascendente, y tarde o temprano la supera.
⚠️ Error común de principiante
Leer The Bitter Lesson y concluir "por lo tanto, cualquier esfuerzo humano es un desperdicio". Eso es estar a medio camino de caer en la trampa. La lección se aplica a entrenamiento del modelo (lo que hacen OpenAI/Anthropic) — no en tu harness, que controlas y que no mejora por sí solo con más GPU.
En 1 frase: la Lección Amarga dice que, en el entrenamiento de IA, más capacidad de cómputo supera a la inteligencia humana — porque la capacidad de cómputo crece y la inteligencia, no.
Profundiza (opcional): ¿quién es Rich Sutton y por qué importa?
Rich Sutton es uno de los padres del reinforcement learning (aprendizaje por refuerzo), la técnica que enseñó a las máquinas a vencer a los humanos en Go y en videojuegos. Vivió la lección en carne propia: vio cómo métodos artesanales brillantes eran reemplazados por modelos más grandes. Su ensayo casi se convirtió en un meme de la industria — todo inversor ya citó "Bitter Lesson" para justificar "solo hay que esperar a que el modelo mejore". Nuestro curso no niega la lección; muestra los límites de ella para quienes usan IA en el día a día.
🛋️ La tentación de esperar a la AGI
🧠 Imagínalo así: quieres hablar inglés. Alguien te dice: «no estudies; dentro de unos años tendrás un traductor perfecto en el oído, espéralo». Pasan los años y el traductor mágico nunca llega tan perfecto así, y sigues sin hablar inglés. Quien estudió un poco cada día ya está conversando.
De la Lección Amarga nace una tentación peligrosa: «si el modelo va a mejorar por sí solo, ¿para qué esforzarme? Basta con esperar a AGI llegar y resolver todo en mi lugar». Pocock es directo al respecto en el video: "quedarse esperando a la AGI sin hacer nada fue una idea muy tonta." La frase es contundente a propósito: él mismo confiesa que coqueteó con esa actitud y se dio cuenta de que estaba perdiendo tiempo.
El problema de la espera tiene tres capas. Primera: la AGI puede que no llegue cuando lo prometen — las promesas de IA se retrasan todo el tiempo. Segundo: aunque llegue un modelo mucho mejor, él no arregla tu codebase desordenado ni tu prompt vago — esas partes (el harness) siguen siendo tu responsabilidad. Tercera, y la más cruel: mientras esperas, tú no desarrolla ninguna habilidad. Quien actuó durante la espera llega al «futuro» con los fundamentos afilados; quien solo esperó, llega en cero. Esperar parece la opción inteligente (dejar que la máquina lo haga), pero es la que más cuesta.
Recuperación rápida: según Pocock, ¿cuál es el problema de "solo esperar a la AGI"?
En 1 frase: esperar a que la AGI "lo haga por ti" es, en palabras de Pocock, "una idea muy tonta" — la IA ya está aquí; el juego es ahora.
⚡ El cómputo supera a la optimización (y el límite)
🧠 Imagínalo así: echarle más compute al modelo es como ponerle un motor más potente al auto: mejora todo el auto de una vez. Pero el motor potente no estaciona solo, no elige el camino ni cambia una llanta. Hay partes del problema que ninguno compute lo resuelve: son las tuyas, fuera del motor.
Dónde está la Lección Amarga verdadera: en el cerebro del modelo. Entrenar un modelo más grande, con más datos y más GPUs, realmente ofrece mejoras que ningún ajuste manual puede alcanzar. Por eso David, en la entrevista, hace la pregunta obvia: "¿por qué no ambas cosas? Cambiar el motor mejora todo al instante." Él tiene razón: un modelo mejor sube toda la marea: cada tarea se vuelve un poco más fácil sin que muevas un dedo. Negarlo sería una tontería.
Dónde ella tiene límite: el compute mejora lo que está dentro del modelo. Él no mejora lo que está fuera: tu prompt impreciso, tu codebase laberíntico, la falta de una skill, los permisos incorrectos. Esas partes del harness no reciben GPU; solo mejoran cuando tú los mejora. Y hay un detalle que cambia todo, que Pocock usa todo el tiempo: un harness bien hecho hace que un modelo más barato entregar el mismo trabajo — "ten un codebase más fácil de modificar y podrás usar un modelo menos inteligente para hacer el mismo trabajo". Es decir: mejorar el harness es la forma de recopilar el beneficio del compute sin pagar por el modelo más caro. Ambos lados se suman; no compiten.
🔬 Ejemplo resuelto: el mismo bug, dos caminos
Pocock cuenta en el video que el modelo Fable encontró bugs de seguridad profundos que otros no detectaron. La tentación: "¿ves? solo hay que esperar a que el modelo sea más potente". Su respuesta es la Bitter Lesson aplicada con límites:
Camino «esperar al modelo»
"Solo Fable encuentra estos bugs. Esperaré a que todos los modelos sean así." → Quedas atado a UN modelo caro y no cambias nada de tu lado.
Camino «mejorar el harness»
Pocock: "encontrarías estos errores con modelos más baratos si buscaras en los lugares correctos y dieras el prompt/harness adecuado." → Un cron diario de revisión de seguridad, con un modelo sencillo, que revisa una parte nueva del repo cada día. El mismo resultado, menor costo, y tu.
En 1 frase: el compute mejora el cerebro del modelo, pero todo lo que está FUERA de él (su harness) solo mejora con tus manos, y un buen harness permite que un modelo barato rinda como uno caro.
🏗️ Por qué actuar ahora
🧠 Imagínalo así: un gimnasio. Esperar «el mejor equipo del mundo» para recién entonces entrenar es una excusa. Quien entra hoy y entrena con el equipo que tiene ya se está poniendo fuerte; cuando llegue el nuevo, lo aprovechará mucho mejor que quien se quedó esperando en la recepción.
La salida de la trampa tiene nombre: fundamentos. Pocock insiste: "las personas se enfocan en lo equivocado —el juguete nuevo y brillante— cuando deberían enfocarse en lo que ha funcionado durante 30-40 años." Organizar el código, escribir una solicitud clara, escribir pruebas y documentar bien: nada de eso queda obsoleto cuando sale un modelo nuevo. Al contrario: cuanto mejor es el modelo, más aprovecha un harness bien cuidado. Los fundamentos son el activo que se valoriza; la moda del modelo de la semana es lo que se evapora.
Hay otro motivo práctico y poderoso para actuar ahora: el setup agent-agnostic. Si construyes tus prompts, skills y base de código de forma que no lo ata a un solo modelo, así que —cuando el modelo mejore— tu trabajo de hoy sigue siendo válido y hasta mejora. Es lo mejor de ambos mundos: obtienes la ventaja de Bitter Lesson (llega un modelo más potente) sin haber estado esperando sin hacer nada. Pocock termina con humildad: "no soy un gurú/comentarista: estoy haciendo lo mejor que puedo con lo que tengo ahora." Este es el espíritu: trabajar con lo que existe hoy, en vez de apostarlo todo a un mañana incierto.
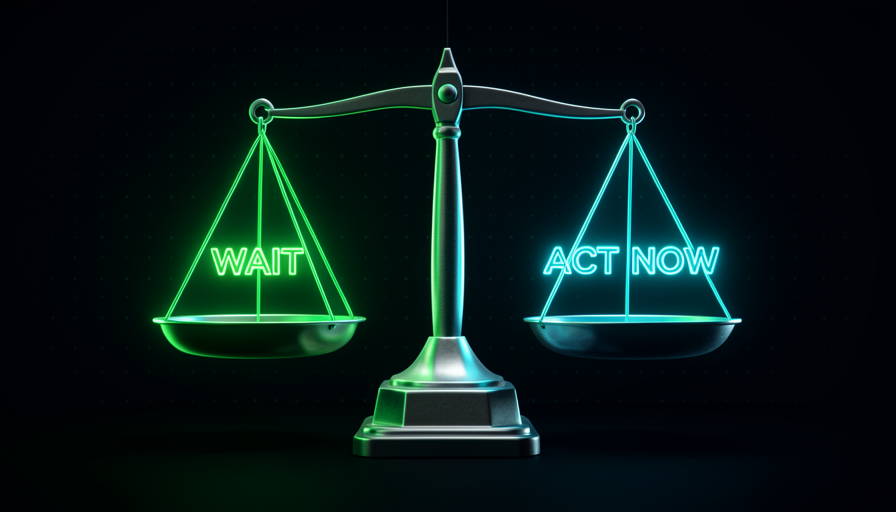
✓ Actuar ahora (fundamentos)
- • Mejorar la configuración un poco cada día.
- • Aprender lo que durará 30-40 años.
- • Mantener todo agent-agnostic.
- • Usar el mejor modelo disponible hoy.
✗ Esperar (la trampa)
- • "Dentro de poco la AGI lo resolverá."
- • No tocar el codebase ni el prompt.
- • Apostarlo todo a un único modelo futuro.
- • Llegar al futuro sin ninguna habilidad.
En 1 frase: actúa ahora sobre los fundamentos y mantén todo agnóstico del agente; así aprovecharás el mejor modelo del futuro sin haber desperdiciado el presente.
⚖️ El equilibrio de Pocock
🧠 Imagínalo así: un corredor que cambia de zapatillas nuevas cada semana buscando las "zapatillas perfectas" y nunca corre — frente a un corredor que entrena todos los días Y compra unas buenas zapatillas cuando las encuentra. El segundo gana el maratón. Pocock no es "anti-modelo"; es "buen modelo + entrenamiento constante".
Aquí está el corazón del módulo y el punto en que mucha gente malinterpreta a Pocock. Él no dice "ignora el modelo, solo modifica el harness". Dice que es 50/50 (y no 90% modelo / 10% optimización, como piensa la mayoría). Cuando David provoca — "usa los dos: el mejor modelo Y el mejor harness" — Pocock termina estando de acuerdo: "es 50/50; el problema es pensar primero por el modelo." El orden importa. Si empiezas por el modelo, pierdes de vista los fundamentos: "si me enfoco demasiado en optimizar para un modelo, pierdo de vista los fundamentos."
Fíjate en el matiz: Pocock admite que él mismo puede que estés cayendo en la Lección Amarga al gastar tanta energía en el harness en vez de confiar simplemente en que el modelo mejorará. No oculta ese riesgo, y esa honestidad es lo que hace que el equilibrio sea confiable. La síntesis práctica que se desprende de ahí: mejora tu harness ahora (tú tienes el control, es la mitad del juego) y usa el mejor modelo disponible (es la otra mitad, y la obtienes gratis como beneficio cuando cambias). David describe exactamente esa postura: mejora activamente la configuración todos los días e usa el modelo más potente que existe. No es «o», es «y». Caer en la trampa es tratarlo como un «o».
En 1 frase: es 50/50: usa el mejor modelo Y mejora el harness; el error es pensar primero en el modelo.
🎯 Aplicar sin caer en la trampa
🧠 Imagínalo así: cada vez que pienses "voy a esperar a que el modelo nuevo resuelva esto", cambia la frase por una pregunta: "qué puedo ajustar de mi lado hoy?". Este simple reflejo ya te saca de la trampa de Bitter Lesson.
Al cerrar el módulo de forma práctica: la Lección Amarga es real, pero como principio de entrenamiento de IA — no como excusa para quedarte quieto. Siempre que te tiente «esperar», pasa la decisión por el filtro de abajo. Convierte el miedo a «¿estoy cayendo en la Bitter Lesson?» en una comprobación objetiva. Copia y pega esto cuando te descubras esperando:
Peguei-me "esperando o modelo melhorar"? Rode o filtro:
[ ] É treino de modelo (interno)? -> ok, isso melhora sozinho; nao e minha tarefa.
[ ] E harness (prompt/skill/codebase/permissao)? -> NAO espera; e comigo, agir HOJE.
[ ] Meu setup esta agent-agnostic? -> se sim, o ganho do modelo futuro ja esta garantido.
[ ] Estou usando o MELHOR modelo disponivel agora? -> use; e a outra metade (50/50).
Regra: pense pelo HARNESS primeiro. E "E" (modelo + harness), nunca "so esperar".
Recuperación rápida: ¿cuál es el equilibrio que defiende Pocock?
Para profundizar (opcional): «compra el candado» — la Bitter Lesson aplicada
Pocock usa una analogía excelente: "si alguien te roba la bicicleta, quizá deberías comprar un candado." Dicho de otro modo: cuando el modelo encontró un error que no viste, la lección no es «espera a que el modelo se vuelva más inteligente», sino «construye un sistema que continúa encontrando estos bugs en el futuro" (p. ej., una revisión de seguridad diaria programada con un modelo sencillo). Eso es actuar sobre el harness en vez de esperar al compute; verás esto en detalle en la Ruta 4 (Sistemas que se mejoran a sí mismos).
En 1 frase: siempre que pienses "voy a esperar al modelo", pregúntate "¿qué puedo ajustar hoy en mi harness?" y actúa.
🧾 Resumen del módulo
Próximo módulo:
1.3 — Configuración agnóstica al agente: cómo blindar tu harness para que sobreviva al cambio de modelo.