🛋️ Rendición cognitiva
El primer peligro es el más seductor. Addy Osmani lo llama rendición cognitiva (rendición cognitiva): entregar el control TOTAL al loop y dejar de leer lo que produce. Tú sigues siendo quien revisa, sobre todo al principio, cuando todavía no sabes dónde suele equivocarse el loop.
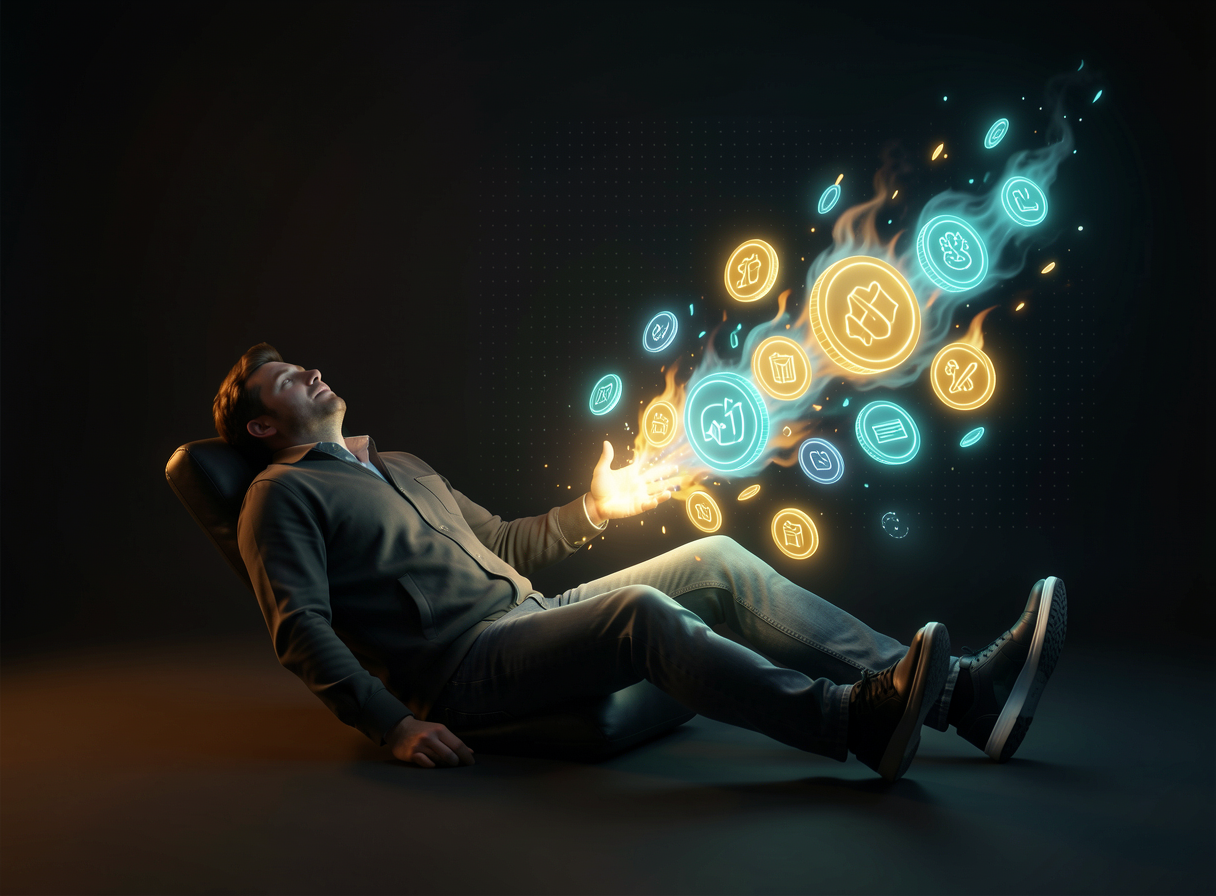
Qué ver: la tentación es recostarse y dejar que la máquina funcione. Pero el panel de alerta sigue parpadeando y el costo sigue subiendo. El loop no percibe cuándo se dirige al lugar equivocado; tú eres el sensor que falta.
✓ Delegar con revisión
El loop actúa; tú lees la salida, sobre todo al principio. Poco a poco aprendes dónde falla y revisas con menos detalle, pero nunca a ciegas.
✗ Rendirse
Dejas de leer. El loop se desvía, acumula errores y consume tokens; solo te enteras cuando el daño ya es costoso o está en producción.
💸 Costo y comprehension debt
Los loops autónomos tienen dos costos. El obvio: dinero — Firecrawl advierte que ejecutar loops consume tokens rápidamente. Lo menos obvio y más peligroso: deuda de comprensión (deuda de comprensión): código que existe en tu proyecto y que ya nadie entiende.
✗ "tokenmaxxing inference looping"
Rhys Sullivan rechaza ejecutar loops grandes solo por ejecutarlos: gastar inferencia como un fin en sí mismo no produce valor, solo una factura de API.
✗ "promptchud" (solo escribir prompts)
Sullivan también rechaza el extremo opuesto: limitarse a escribir prompts a mano, sin automatizar nunca. Ambos extremos desperdician.
🎯 El punto medio de Sullivan
Ni tokenmaxxing ni promptchud. El valor está en el medio: agentes que reproducen problemas REALES de tu producto — un loop con un objetivo concreto (reproducir un bug que sienten tus usuarios), verificable y de alto valor. El loop no es el objetivo; resolver el problema sí.
⏳ Loops de 12h que no sirven
Más tiempo de loop no significa más valor. Nate Herk cuenta que ya tuvo loops de 12h+ que no eran útiles. El punto ideal suele ser mucho más breve, y hay un límite a partir del cual deja de dar resultados.
Lee la escala: lo útil suele durar de ~35 min a unas pocas horas. Un «chunky loop» de 4–8h que se ejecuta mientras duermes puede dar resultados. Pero un loop de 12h+ o de 4 días casi nunca compensa: más tiempo significa más desviación, no más resultados.
💡 La regla práctica
Empieza con poco. Si un loop de 35 min a 2h no converge, extenderlo a 12h rara vez lo soluciona: el problema suele ser el objetivo o la verificación, no la falta de tiempo. El «chunky loop nocturno» es un límite razonable; más allá, solo pagas para que el loop se desvíe.
📈 La curva calidad × intentos
Después de los riesgos, viene el motivo por el que todo esto vale la pena. La IA nunca acierta a la primera. Cuando delegas el ciclo de retroalimentación e iteración a la propia IA, la calidad mejora mucho antes que si revisaras cada vuelta: es el mismo gráfico de la Ruta 1, ahora desde la perspectiva de quien diseña.
Qué ver: las dos líneas llegan al mismo nivel (90–95%), pero el loop llega mucho antes. La diferencia no es "la IA es mejor"; es que cumple el papel de revisor humano en cada vuelta, sin esperar a que tú entres en la conversación.
🧠 Por qué esto cierra el argumento
Todos los riesgos de las secciones anteriores (rendición, costo, deriva) son el precio de entrada. Los pagas porque la curva vale la pena: delegar la iteración a la IA permite llegar pronto a algo "lo bastante bueno". La ingeniería de la ruta —guardrails, verificación, cadencia— es lo que mantiene la curva subiendo sin que caigas en los riesgos.
🔬 Estudio de caso: cómo se realizó la auditoría de las 45 fuentes
Este es el estudio de caso más honesto posible: este curso surgió de un loop maker/checker. Las 45 fuentes que viste citadas en la Ruta 1 no fueron leídas por una sola persona: las procesó un pipeline de agentes con una separación estricta de funciones. El principio: el modelo que ENCUENTRA la fuente nunca la EVALÚA.
Lee el pipeline: es el maker/checker adversarial de la 4.2 aplicado a la investigación. La separación de roles es lo que genera confianza: un agente optimista que solo busca, uno pesimista que solo verifica y ninguno de los dos cierra el ciclo por sí solo.
DISCOVER — investigadores en paralelo recorren docs, frameworks, papers, practicantes, YouTube y X en busca de definiciones de «loop».
EXTRACT (maker) — un agente copia la FRASE EXACTA donde la fuente define el loop. Sin parafrasear ni inventar.
VERIFY (checker) — un agente SEPARADO y adversarial vuelve a buscar la URL y marca: confirmado, parcial o no verificable.
SINTETIZAR — se redacta una síntesis y luego OTRO agente la critica de forma adversarial antes de convertirla en contenido.
🧩 Por qué importa la separación
Si el mismo modelo encontrara Y evaluara la fuente, aprobaría su propio hallazgo: el sesgo de 4.2 en forma de investigación. Separar los roles fue lo que transformó «la IA dijo que había una cita» en «una cita que sobrevivió a un segundo agente que intentó refutarla». Ese fue el loop que produjo el curso que estás leyendo.
🎨 Ejemplos del mundo real (del video)
Cuatro loops reales, del video fuente, para aterrizar la teoría. Fíjate en que en TODOS el cuello de botella es el mismo: cómo hacer que la verificación sea lo bastante objetiva para que el loop sepa cuándo detenerse.
🖼️ (a) Miniaturas
Genera 10 conceptos, califica cada uno con una rúbrica (claridad en tamaño pequeño, curiosidad, contraste) e itera sobre el mejor.
El problema: "hasta que estés satisfecho" es subjetivo. La mejora: un subagente «scorer» dedicado y evaluado.
✈️ (b) Avión en 3JS
Build del avión en Three.js + verificar en el navegador (girar, ver el render), iterar.
Tiempo: ~37 min. Verificación: mirar el render real, no suponer que compiló.
🛣️ (c) Abbey Road en CSS
Screenshot de cada versión; detente cuando el promedio sea ≥ 9 O llegues al límite de 8 pasadas.
Se detuvo en V7. La doble condición de parada (nota + límite) es la barrera de seguridad que impide que el loop sea infinito.
🎬 (d) Edición de video (HyperFrames)
Tomar la transcripción, recortar errores y pausas, crear y sincronizar los beats, y MUCHAS verificaciones.
Verificación: todos los beats dentro de los límites y alineados con la transcripción — la parte más pesada del ciclo.
El hilo conductor: cada ejemplo solo se convirtió en un loop útil cuando tuvo una verificación concreta: una rúbrica, un render, una nota con límite, beats comprobados. Sin eso, sería "iterar hasta que te guste", algo que nunca termina.
Objetivo del prompt de abajo
Convertir "iterar hasta que te guste" en una parada objetiva: un verificador adversarial puntúa el trabajo según una rúbrica y solo lo aprueba con una nota alta O al alcanzar un límite de iteraciones —exactamente el patrón de Abbey Road.
# Cole como o prompt do agente VERIFICADOR (separado do que produz)

Seu papel é CRITICAR, não criar. Receba o artefato e tente reprová-lo.
Pontue de 0 a 10 cada critério da rubrica:
-
-
-

Regras de parada (aplique sem exceção):
- APROVE só se a média for >= 9.
- Se ainda < 9, escreva o defeito mais grave e devolva para refazer.
- PARE de qualquer jeito ao atingir 8 passes — entregue o melhor até aqui.

Nunca aprove o que você mesmo produziu. Justifique cada nota.
Cómo verificar: ejecuta el productor y el verificador en loop sobre un artefacto sencillo (ej.: un diseño CSS). Comprueba que el loop SE DETUVO por uno de los dos disparadores — promedio ≥ 9 o 8 pasadas — y no «porque te pareció bien». Si se ejecutó para siempre, no se están respetando la rúbrica o el límite; ajusta el prompt.
🧰 Cuándo vale la pena (síntesis)
La síntesis de todo el curso, en una regla. Pon en loop lo que es repetitivo, revisable, de alto valor y con un checker integrado. Para todo lo demás, escribe el prompt una sola vez. Y ejecuta loops con la frecuencia adecuada para TU caso, no 24/7 para aparentar actividad.
✅ Haz esto (ponlo en loop)
- •Tareas repetitivas que vuelven una y otra vez.
- •Trabajo revisable — se puede verificar que está «listo».
- •Alto valor — compensa el costo de tokens.
- •Tiene checker integrado (prueba, rúbrica, evaluador).
⛔ Sáltate esto (escribe un prompt una vez)
- •Tarea de una sola respuesta, sin repetición.
- •Sin cómo verificar el resultado de forma objetiva.
- •Valor bajo: el costo del loop no se compensa.
- •24/7 por estado, "porque los expertos lo hacen".
🎯 La frase que cierra el curso
Loop solo con verificación. Sin un checker, un loop no es ingeniería: es una forma costosa de equivocarse con confianza. Toda la Ruta 4 (arquitecto, flota, guardrails, adversarial) existe para sostener una sola cosa: la verificación que le indica al loop cuándo realmente terminó.
¿Qué tarea es la MEJOR candidata para convertirse en un loop?
🧾 Resumen del módulo y del curso
🏁 Llegaste al final del curso
Desde la Trilha 1 (el esqueleto reason→act→observe) hasta aquí, una idea atraviesa todo: un ciclo solo es ingeniería cuando tiene verificación. Llévate esta frase. Vuelve a la página de inicio para revisar cualquier ruta, o abre "Mi jornada" para ver qué te falta marcar como leído.