PTENES
Skill de Claude Code · triage

El modelo y el esfuerzo no se convierten

Antes de delegar un subagente o workflow, el maestro enrutador decide por separado qué modelo (haiku/sonnet/opus/fable) y cuánto esfuerzo (low→max) lo que la tarea merece, en lugar de reducir todo a "sonnet+medium".

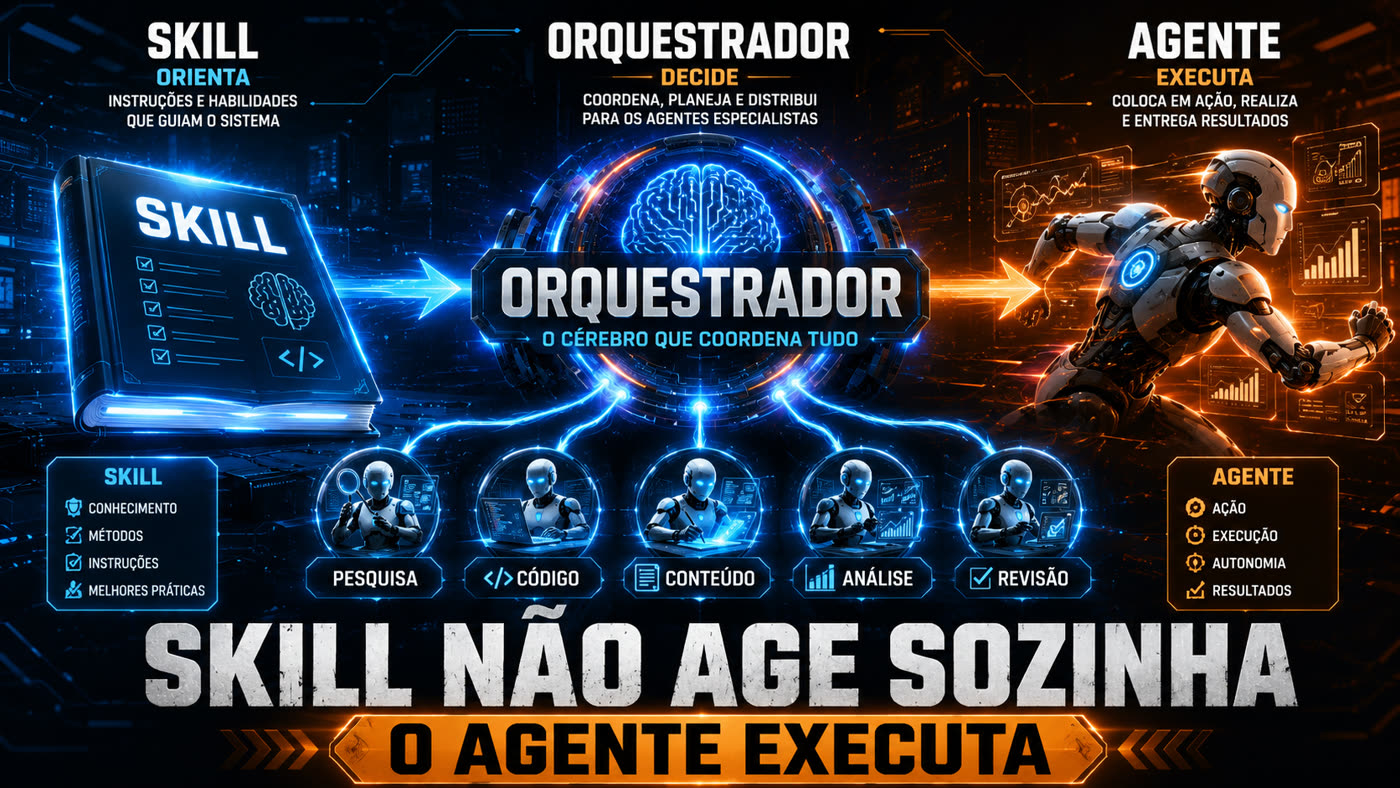
La skill orienta, el orquestador decide, el agente ejecuta: la skill no actúa sola, el agente la ejecuta
Qué es

Dos ejes, dos preguntas, nunca un punto medio

maestro-roteador es una skill de Claude Code: recibe un problema sin procesar y decide, antes de asignar el trabajo, qué modelo y qué nivel de esfuerzo merece cada parte.

🎯 Modelo = repertorio

Responde una sola pregunta: ¿qué nivel de criterio peor paso ¿La tarea lo exige? Se elige el modelo más pequeño que resuelva bien ese paso, nunca «por si acaso».

⚙️ Esfuerzo = deliberación

Suma ambigüedad + costo del error. Solución única y error barato → low. Varios caminos plausibles o error costoso (producción, datos perdidos) → high o más.

⚖️ El error no se negocia, la eficiencia sí

Cuando el riesgo afecta a la corrección, no hay una opción barata. Cuando solo se trata de acabado/gusto, la skill ofrece elegir entre costo y calidad, y el usuario decide.

📊 Referencia: el esfuerzo en la práctica →

Datos de terceros sobre Opus 5.5 y GPT-6 Astra en todos los niveles de esfuerzo. En ambos casos, el nivel máximo no fue el preferido, lo que refuerza la escala: empieza bajo y sube solo con evidencia. La página también incluye la opinión de Nei: medium por defecto, high cuando necesites más razonamiento, xhigh solo en casos extremos. Es una referencia y no cambia el procedimiento de la skill. (EN · ES)

Cómo funciona

Procedimiento, siempre en este orden

La skill se ejecuta inline en el turno principal — nunca en un subagente — y sigue cuatro pasos fijos antes de delegar cualquier trabajo.

1. Aísla el peor paso→ 2. Modelo = el más pequeño que resuelve→ 3. Esfuerzo = ambigüedad + costo del error→ 4. Volumen: prueba 1 elemento antes del lote

🪤 Anti-overhead

Las tareas más baratas que el propio triaje no reciben triaje. «Corrige este typo» va directamente con el valor predeterminado del turno.

🚨 Riesgo identificado = high

Si tú mismo mencionaste un riesgo de producción/pérdida en la justificación, el esfuerzo mínimo es high. «Medium con cuidado» no existe.

🪜 Escalera con evidencia

¿El error es barato y reversible? Empieza con el menor esfuerzo plausible y solo súbelo si hay evidencia de resultados insuficientes; nunca "high por si acaso". La escala NO se aplica a riesgos irreversibles.

🎭 Empate de gustos

Cuando la estructura ya está garantizada por una plantilla/skill y solo falta el acabado, el triage presenta el equilibrio entre costo y calidad y deja que el usuario elija.

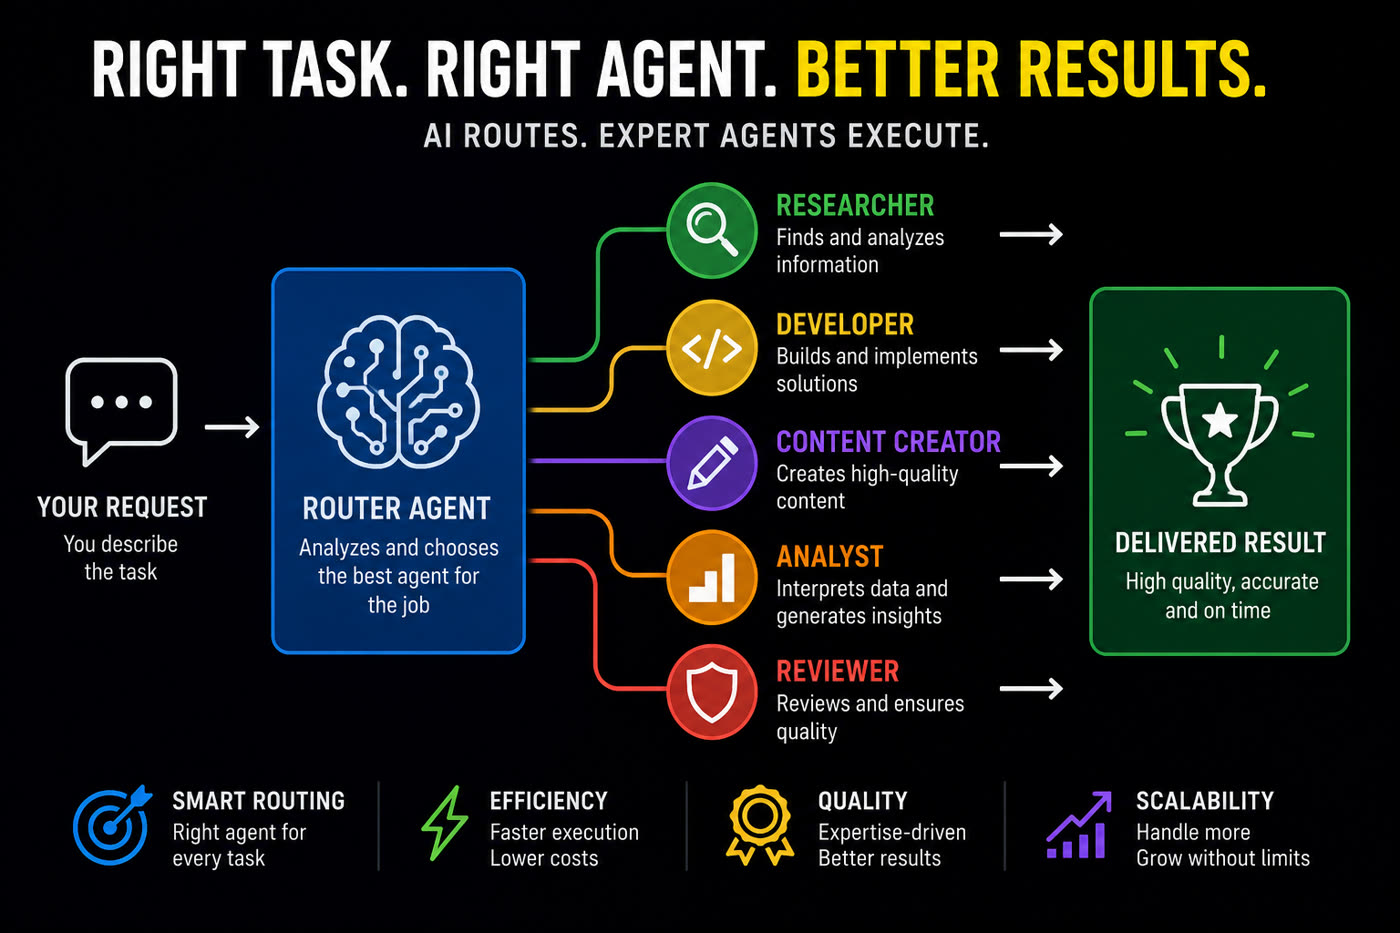
Flujo del enrutador: llega tu solicitud, el agente enrutador la analiza y elige al agente adecuado (investigación, código, contenido, análisis, revisión) y entrega el resultado
Ahorro

Caché: el costo oculto del cambio de modelo

La caché de prompts depende del modelo y del prefijo del contexto. Perder la caché de un contexto de 100k tokens hace que la siguiente entrada cueste ~12,5× más (escritura 1,25× frente a lectura 0,1×). La matriz de triage debe tener esto en cuenta.

🧱 Cambia solo en los límites

Cambiar el /model del turno principal descarta la caché acumulada. Cambia solo en los límites del trabajo (fin de fase, handoff), nunca a mitad de un bloque. En un contexto grande, el cambio puede costar más que lo que ahorras con el modelo más pequeño.

🤖 El subagente no cuesta caché

Cada Agent/Workflow tiene su propio contexto: enrutar una parte a un modelo más pequeño mediante un subagente NO toca el caché principal. Es la opción preferida para aplicar la matriz sin costo de cambio.

🚫 Sin keepalive artificial

Nunca mandes «¿sigues ahí?» solo para mantener la caché: Claude Code gestiona la caché por sí solo y el ping cuesta más de lo que ahorra. ¿Pausa larga? Haz un handoff conciso y deja que expire.

📋 Rutina que preserva la caché

Trabaja en bloques continuos (planificar → ejecutar → probar → documentar), mantén estable el inicio del contexto (no actives ni desactives herramientas y MCP a mitad del bloque) y concentra las tareas relacionadas en la misma sesión.

⏸️ Pausas

Pausa corta: continúa con normalidad. Pausa larga o cambio de tarea: handoff breve (objetivo, estado, decisiones, siguiente paso) + contexto nuevo. En la API directa, las llamadas espaciadas por 10–50 min aprovechan la caché con TTL de 1h (escritura 2×).

Perspectiva

Harness > esfuerzo: dónde nace realmente el resultado

En una prueba real con la misma tarea en 12 niveles de esfuerzo y 2 proveedores, los resultados funcionales fueron casi idénticos: los niveles altos añadieron un favicon y sombras, por 2–5× los tokens. Lo que cambia el resultado no es el control de esfuerzo.

📝 Una especificación clara supera un esfuerzo alto

Un prompt que dice exactamente qué significa «listo» ofrece con low lo que el esfuerzo max intenta adivinar. El esfuerzo no compensa una especificación vaga.

🛠️ El modelo es un cerebro en un frasco

Las herramientas, los archivos, el terminal, las skills y las instrucciones — el harness — son los brazos del modelo. Invertir en el harness rinde más que subir el esfuerzo.

🧠 Demasiado esfuerzo estorba

Overthinking es el exceso en el propio eje de esfuerzo: deliberar de más en una tarea sencilla vuelve a explorar caminos ya decididos y puede empeorar el resultado, no solo encarecerlo. El esfuerzo adecuado es el mínimo que cubre el riesgo; por encima de eso compras ruido, no seguridad.

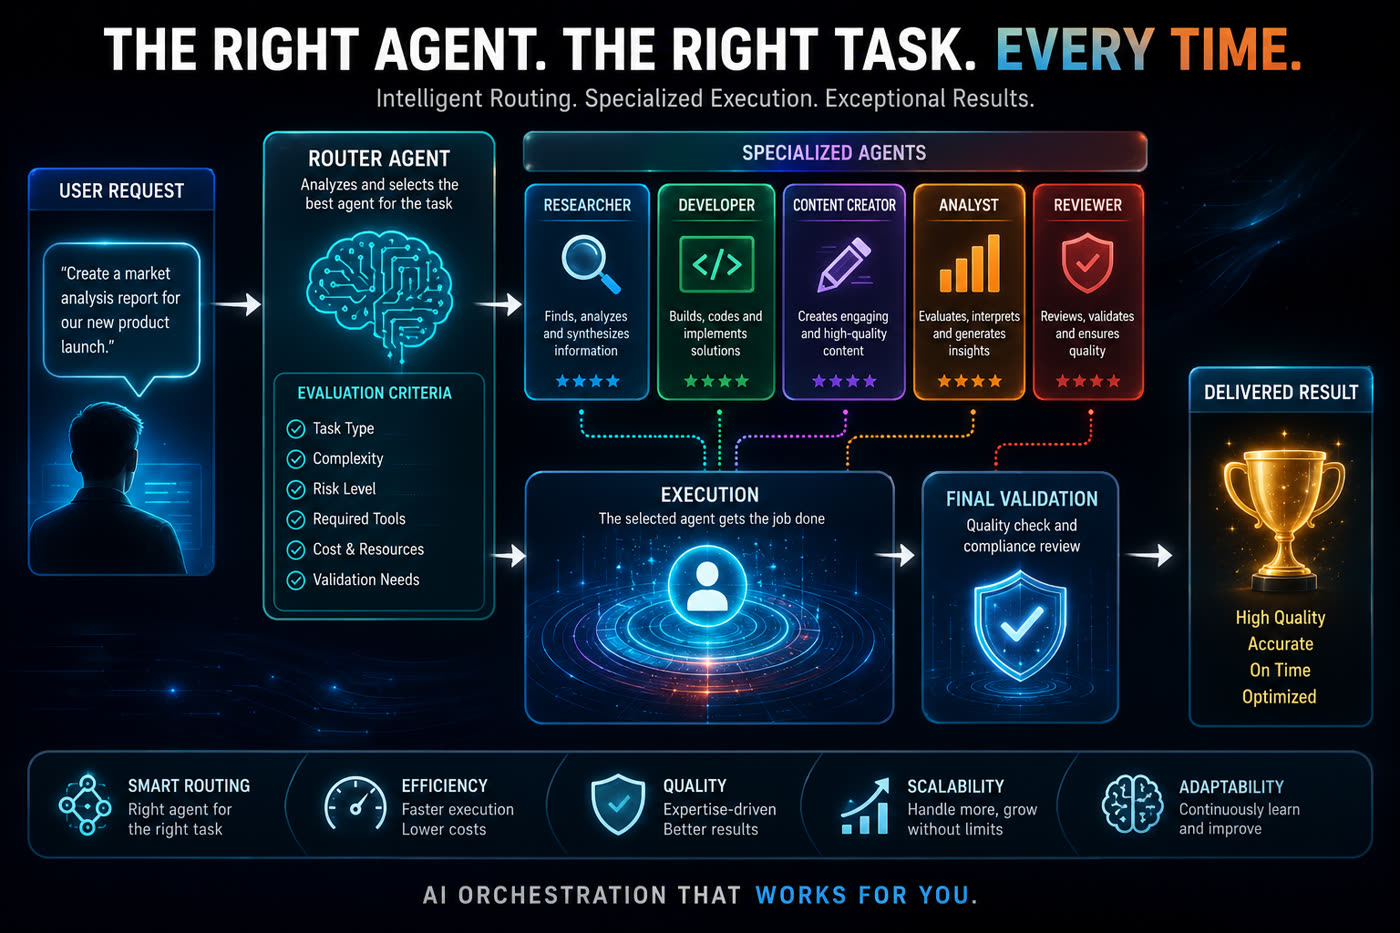
El agente adecuado para cada tarea, siempre: el enrutador analiza el tipo, la complejidad, el riesgo, las herramientas y el costo antes de asignar agentes especializados
Requisitos previos

Lo que debe estar en línea

Solo eso: Claude Code instalado y la skill disponible en ~/.claude/skills/ (usuario) o .claude/skills/ (proyecto).

Claude Code

CLI compatible con skills y llamadas a Agent/Workflow con parámetros model/effort.

# confirma instalación
claude --version

Git

Para clonar el repo y crear el symlink de instalación.

# confirma git
git --version

Ninguna dependencia adicional

Sin servicio externo, sin clave de API y sin build. Es Markdown puro que lee Claude Code.

# contenido de la skill
skills/maestro-roteador/SKILL.md
Guía de uso · paso a paso

Instalar y usar el triage

Instalación mediante symlink (para recibir actualizaciones del repo automáticamente) y tres formas de activar el triage.

1

Clona el repo

Descarga la skill.

git clone https://github.com/inematds/maestro-roteador.git
2

Instala mediante symlink (usuario)

Está disponible en cualquier proyecto y recibe actualizaciones del repo sin necesidad de reinstalarla.

ln -sfn "$(pwd)/maestro-roteador/skills/maestro-roteador" ~/.claude/skills/maestro-roteador  # symlink de usuario
3

O copia solo a un proyecto

Sin symlink, directamente en la carpeta de skills del proyecto (no recibe actualizaciones automáticas).

cp -r maestro-roteador/skills/maestro-roteador .claude/skills/  # skill solo de este proyecto
4

Pide el triage directamente

Frases desencadenantes: "qué modelo", "cuánto esfuerzo", "haz la clasificación de esto".

"Faz a triagem disso: renomear 80 arquivos em lote seguindo um padrão."  # -> haiku + low
5

O simplemente pide el trabajo como siempre

Al delegar subagentes/workflows, la skill aplica la matriz por sí sola y distribuye cada parte con model e effort correctos, sin que tengas que pedir el triaje por separado.

"Migra esses dados de produção pro schema novo."  # -> sonnet + high (riesgo identificado)
6

Lee el plan de despacho

La salida siempre viene en el mismo formato YAML, con el peor paso y el riesgo explicitados por parte.

tarefa: <resumo>
partes:
  - o_que: <subtarefa>
    pior_passo: <qual e por quê>
    modelo: haiku|sonnet|opus|fable
    esforco: low|medium|high|xhigh|max
    risco: <custo do erro em 1 linha>
turno_principal: <recomendação de /model, se valer trocar>
Validación

TDD de skills: línea base vs. con la skill

La skill se escribió a partir de una línea base medida: sin ella, los agentes reducen cualquier tarea a "sonnet + medium". Con ella, los tres escenarios de prueba quedaron en el lugar correcto de la matriz.

EscenarioSin skillCon skill
Renombrar 80 archivos en lotesonnet + mediumhaiku + low
Guion con voz de marcasonnet + mediumfable + low
Migración de datos con producción en riesgosonnet + mediumsonnet + high

💡 Por qué esto importa

La opción genérica intermedia «sonnet+medium para todo» cuesta de más en tareas mecánicas y de menos en tareas con riesgo real: los tres escenarios muestran ambos errores a la vez.

🧪 Cómo probarlo tú mismo

Ejecuta «sin skill» (desactívala) y «con skill» con la misma solicitud sin procesar y compara el modelo/esfuerzo elegido: esa es exactamente la prueba que validó los tres escenarios anteriores.

Roadmap

Estado actual y límite conocido

Proyecto de investigación/educación INEMA: sin roadmap formal de funcionalidades; lo que existe hoy y el límite documentado de la skill.

Hoy
Skill funcional, validada frente a la línea baseLas reglas de decisión, la tabla rápida, las trampas comunes y el formato de salida están definidos en SKILL.md y se probaron en los tres escenarios anteriores.
Automático
Subagentes y workflowsPara las llamadas Agent/Workflow, la decisión de modelo/esfuerzo es automática: la skill aplica la matriz sin necesidad de invocarla explícitamente.
Límite
La conversación principal solo recomiendaPara el modelo del turno principal, la skill solo hace una sugerencia: el usuario siempre realiza el cambio con /model.