Claude · GPT-6 · Grok — setembro de 2026
O modelo certo para cada tarefa
Muitos modelos chegaram ao mesmo tempo. A resposta prática é simples: use o melhor modelo para cada tarefa, sem lealdade a nenhuma plataforma.
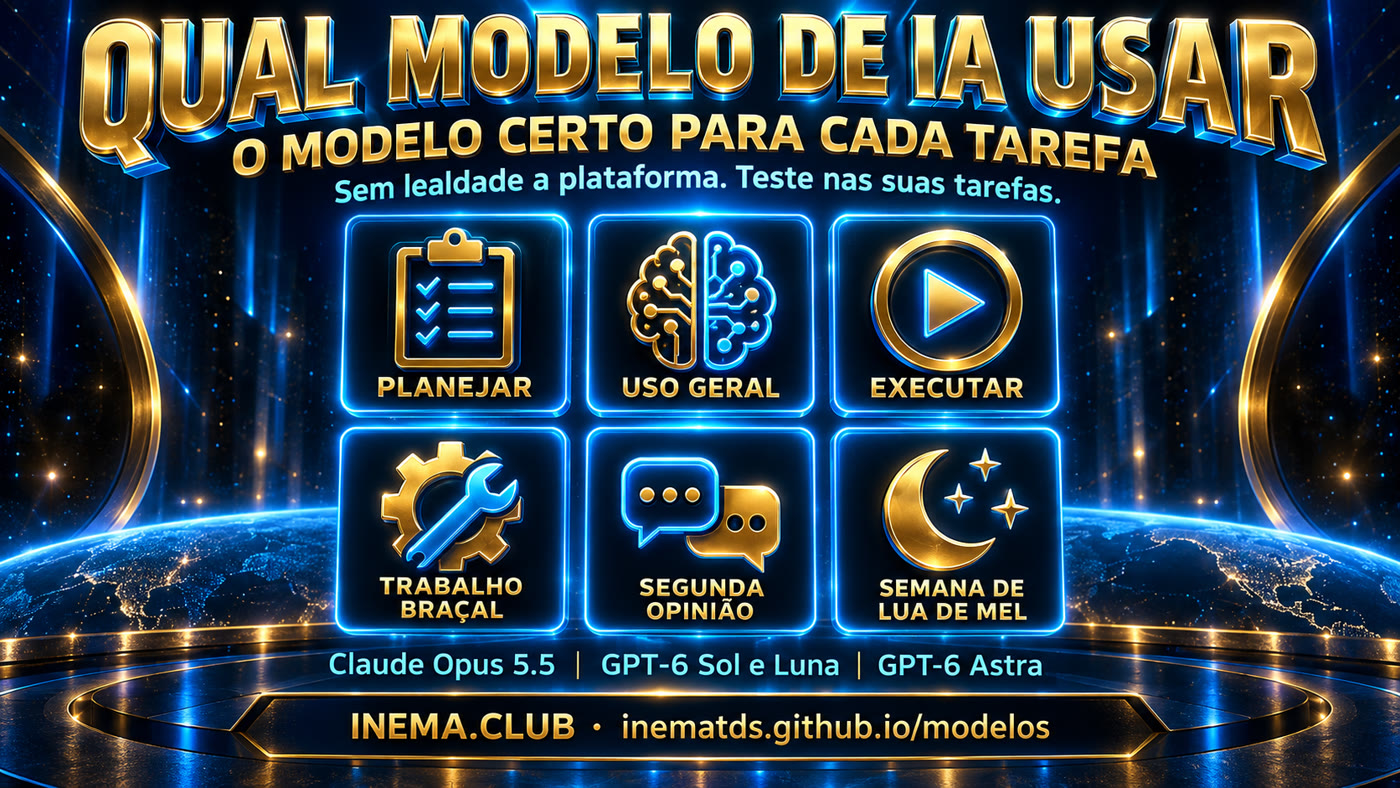
Muitos modelos chegaram ao mesmo tempo. A resposta prática é simples: use o melhor modelo para cada tarefa, sem lealdade a nenhuma plataforma.
Clique em um modelo para a explicação completa, em linguagem simples.
O melhor para o dia a dia: rápido, direto, econômico em tokens e excelente em projetos complexos.
🔷 GPT-6 AstraPlanejamento e problemas difíceisO modelo para pensar antes de fazer: planejar, decidir arquitetura e atacar o que é realmente difícil.
☀️ GPT-6 SolExecução com bom custoBom e econômico em tokens, mas abaixo do Astra no que é exigente. Brilha quando a tarefa já está bem definida.
🌙 GPT-6 LunaTrabalho braçalO executor para tarefas repetitivas, claras e sem ambiguidade. Tem dois ritmos: leve e pesado.
💎 Claude Fable 5.1Perdeu espaçoMuito capaz, mas consome muitos tokens — e o Opus 5.5 passou a entregar o mesmo ou mais por bem menos.
✖️ Grok 4.7RebaixamentoExperiência ruim nos testes de uso e inferior à versão anterior (4.6).
➖ Claude Sonnet 5 · Haiku 4.5Pular na pilha ClaudeO Sonnet 5 gasta demais por tarefa; o Haiku atual é fraco. Dentro do Claude, use o Opus 5.5 em esforço baixo.
Teste os modelos nas suas próprias tarefas.
Cuidado com o efeito lua de mel: modelos novos parecem incríveis nos primeiros dias. Espere uma semana, observe estabilidade, qualidade e custo antes de mudar toda a sua pilha.
Uso via assinaturas (plano Claude + plano Codex). “Custo” aqui é quanto da cota cada modelo consome.
GPT-6 Astra · esforço médio–alto. Arquitetura, simular cenários, casos exigentes.
Claude Opus 5.5 · esforço baixo. Rápido, direto, econômico, pede pouca instrução.
Claude Opus 5.5 · baixo–médio. Acerta de primeira onde o gosto importa.
GPT-6 Sol · médio–alto. Bom custo quando a tarefa já está bem definida.
GPT-6 Sol · médio–alto. Forte quando há critério claro (testes que passam ou falham).
GPT-6 Luna · Low para o simples e rápido; High / X-High para o pesado. Só tarefa sem ambiguidade.
Opus 5.5 orquestra, Sol ou Luna executam. Julgamento uma vez, execução barata várias vezes.
Astra propõe, Opus 5.5 revisa. Duas visões baratas valem mais que uma cara.
Grok 4.7 (pior que o 4.6) · Fable 5.1 (caro, superado pelo Opus 5.5) · Sonnet 5 e Haiku 4.5 (custo-benefício fraco).
Olhe para o passo mais difícil da tarefa, não para a tarefa inteira.
Vá para onde você é melhor atendido — time Claude ou time Codex, tanto faz.
Acima do nível “alto” de esforço não houve ganho real. Suba só com evidência.
Todo modelo novo parece ótimo nos primeiros dias. Espere uma semana antes de trocar a pilha.
O modelo que gasta mais cota mas acerta de primeira pode sair mais barato que quatro tentativas no econômico.
Dois agentes no mesmo repositório se atropelam. Isole cada um e diga no prompt onde ele pode escrever.
Três tarefas reais, dois modelos, mesmo prompt. Trinta minutos valem mais que qualquer benchmark.
Nada para instalar além das ferramentas que você já usa.
Claude Code ou Claude Desktop, para o Opus 5.5.
# ver consumo da cota
/usage
Codex CLI ou Codex Desktop, para GPT-6 Astra, Sol e Luna.
codex # abre a sessão
Fichas, regras e prompts em Markdown.
git clone https://github.com/inematds/modelos
Da consulta rápida até transformar o catálogo numa skill.
A tabela do README é a orientação rápida. Na dúvida, abra a ficha do modelo.
cat README.md               # pilha por tarefa + regras
cat modelos/opus-5-5.md     # ficha: melhor para, evitar para, esforço
Para fluxos com mais de um modelo, copie o prompt correspondente.
prompts/planejar-executar.md     # Astra planeja → Sol executa
prompts/segunda-opiniao.md       # Astra propõe → Opus 5.5 revisa
prompts/orquestrador-workers.md  # Opus 5.5 distribui → Sol/Luna fazem
prompts/tarefa-bracal.md         # Luna em lote, sem ambiguidade
Uma linha por observação, mais recente no topo. É isso que torna a regra da lua de mel prática.
# log.md
| data | modelo | tarefa | resultado | fonte |Três tarefas reais (simples, média, difícil), mesmo prompt no modelo atual e no candidato. Repita a difícil depois de uma semana.
regras.md             # protocolo de 30 minutos
avaliacao/bateria.md  # 8 casos reais, nota 0–3, cota gasta
Há um rascunho pronto que responde “qual modelo uso pra isso?”.
cp -r skills/escolher-modelo ~/.claude/skills/A parte cara (julgamento) acontece uma vez; a parte longa (execução) sai barata.
Astra escreve um plano com passos verificáveis; Sol executa sem mudar o plano e para se algo sair do roteiro.
Astra propõe; Opus 5.5 revisa como cético. Se concordam, siga. Se discordam, a divergência é o que você decide.
Opus 5.5 quebra o trabalho e revisa; Sol ou Luna fazem cada parte na sua própria pasta.
Dados do Opus 5.5 e do GPT-6 Astra em todos os níveis de esforço, com gráficos. Na opinião do Nei: medium por padrão, high quando precisar de mais raciocínio, xhigh só em caso extremo.
A pilha é um ponto de partida e será revista com uso real.