Claude · GPT-6 · Grok — septiembre de 2026
El modelo correcto para cada tarea
Muchos modelos llegaron al mismo tiempo. La respuesta práctica es simple: usa el mejor modelo para cada tarea, sin lealtad a ninguna plataforma.
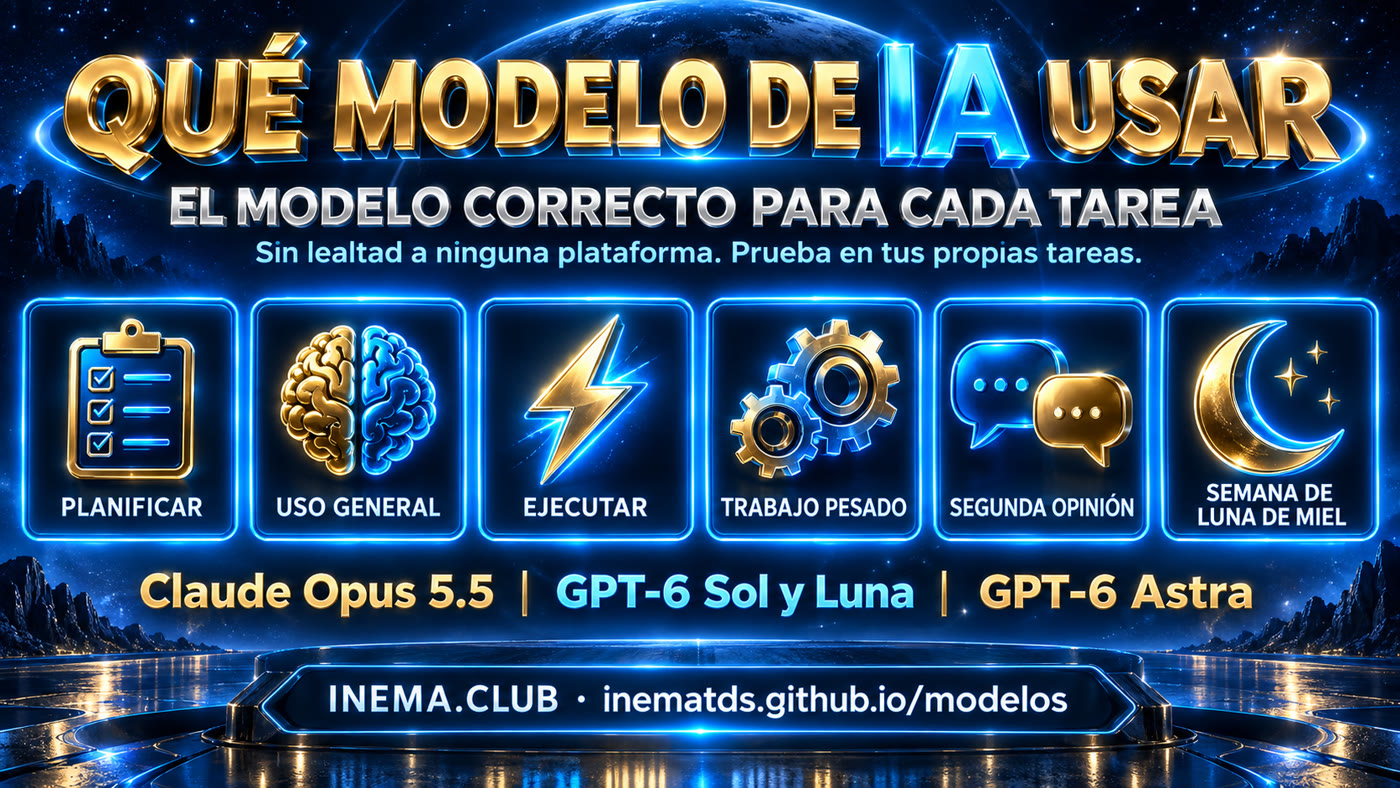
Muchos modelos llegaron al mismo tiempo. La respuesta práctica es simple: usa el mejor modelo para cada tarea, sin lealtad a ninguna plataforma.
Haz clic en un modelo para ver la explicación completa, en lenguaje simple.
El mejor para el día a día: rápido, directo, económico en tokens y excelente en proyectos complejos.
🔷 GPT-6 AstraPlanificación y problemas difícilesEl modelo para pensar antes de hacer: planificar, decidir arquitectura y atacar lo realmente difícil.
☀️ GPT-6 SolEjecución con buen costoBueno y económico en tokens, pero por debajo de Astra en lo exigente. Brilla cuando la tarea ya está bien definida.
🌙 GPT-6 LunaTrabajo pesadoEl ejecutor para tareas repetitivas, claras y sin ambigüedad. Tiene dos ritmos: ligero y pesado.
💎 Claude Fable 5.1Perdió espacioMuy capaz, pero consume muchos tokens — y Opus 5.5 ahora entrega lo mismo o más por mucho menos.
✖️ Grok 4.7Un paso atrásMala experiencia en el uso y peor que la versión anterior (4.6).
➖ Claude Sonnet 5 · Haiku 4.5Saltar en el stack de ClaudeSonnet 5 gasta demasiado por tarea; el Haiku actual es débil. Dentro de Claude, usa Opus 5.5 con esfuerzo bajo.
Prueba los modelos en tus propias tareas.
Cuidado con el efecto luna de miel: los modelos nuevos parecen increíbles los primeros días. Espera una semana y observa estabilidad, calidad y costo antes de cambiar todo tu stack.
Uso mediante suscripciones (plan Claude + plan Codex). “Costo” aquí es cuánto de la cuota consume cada modelo.
GPT-6 Astra · esfuerzo medio–alto. Arquitectura, simular escenarios, casos exigentes.
Claude Opus 5.5 · esfuerzo bajo. Rápido, directo, económico, pide pocas instrucciones.
Claude Opus 5.5 · bajo–medio. Acierta a la primera donde el gusto importa.
GPT-6 Sol · medio–alto. Buen costo cuando la tarea ya está bien definida.
GPT-6 Sol · medio–alto. Fuerte cuando hay un criterio claro (pruebas que pasan o fallan).
GPT-6 Luna · Low para lo simple y rápido; High / X-High para lo pesado. Solo tareas sin ambigüedad.
Opus 5.5 orquesta, Sol o Luna ejecutan. Juicio una vez, ejecución barata muchas veces.
Astra propone, Opus 5.5 revisa. Dos visiones baratas valen más que una cara.
Grok 4.7 (peor que el 4.6) · Fable 5.1 (caro, superado por Opus 5.5) · Sonnet 5 y Haiku 4.5 (costo-beneficio débil).
Mira el paso más difícil de la tarea, no la tarea entera.
Ve a donde mejor te atiendan — equipo Claude o equipo Codex, da igual.
Por encima del nivel “alto” de esfuerzo no hubo ganancia real. Súbelo solo con evidencia.
Todo modelo nuevo parece genial los primeros días. Espera una semana antes de cambiar el stack.
El modelo que gasta más cuota pero acierta a la primera puede salir más barato que cuatro intentos con el económico.
Dos agentes en el mismo repositorio se pisan. Aísla a cada uno y dile en el prompt dónde puede escribir.
Tres tareas reales, dos modelos, el mismo prompt. Treinta minutos valen más que cualquier benchmark.
Nada que instalar además de las herramientas que ya usas.
Claude Code o Claude Desktop, para Opus 5.5.
# ver consumo de la cuota
/usage
Codex CLI o Codex Desktop, para GPT-6 Astra, Sol y Luna.
codex # abre la sesión
Fichas, reglas y prompts en Markdown (escritos en portugués).
git clone https://github.com/inematds/modelos
De la consulta rápida a convertir el catálogo en una skill.
La tabla del README es la orientación rápida. Ante la duda, abre la ficha del modelo.
cat README.md               # stack por tarea + reglas
cat modelos/opus-5-5.md     # ficha: mejor para, evitar para, esfuerzo
Para flujos con más de un modelo, copia el prompt correspondiente.
prompts/planejar-executar.md     # Astra planifica → Sol ejecuta
prompts/segunda-opiniao.md       # Astra propone → Opus 5.5 revisa
prompts/orquestrador-workers.md  # Opus 5.5 reparte → Sol/Luna ejecutan
prompts/tarefa-bracal.md         # Luna en lote, sin ambigüedad
Una línea por observación, la más reciente arriba. Eso hace práctica la regla de la luna de miel.
# log.md
| fecha | modelo | tarea | resultado | fuente |Tres tareas reales (fácil, media, difícil), el mismo prompt en el modelo actual y en el candidato. Repite la difícil después de una semana.
regras.md             # protocolo de 30 minutos
avaliacao/bateria.md  # 8 casos reales, nota 0–3, cuota gastada
Hay un borrador listo que responde “¿qué modelo uso para esto?”.
cp -r skills/escolher-modelo ~/.claude/skills/La parte cara (el juicio) ocurre una vez; la parte larga (la ejecución) sale barata.
Astra escribe un plan con pasos verificables; Sol lo ejecuta sin cambiarlo y se detiene si algo se sale del guion.
Astra propone; Opus 5.5 revisa como escéptico. Si coinciden, adelante. Si no, la diferencia es lo que decides tú.
Opus 5.5 divide el trabajo y lo revisa; Sol o Luna hacen cada parte en su propia carpeta.
Datos de Opus 5.5 y GPT-6 Astra en todos los niveles de esfuerzo, con gráficos. Opinión de Nei: medium por defecto, high cuando haga falta más razonamiento, xhigh solo en casos extremos.
El stack es un punto de partida y se revisará con uso real.