Arma apps de IA en las que el LLM corre dentro de un workflow fijo, una persona aprueba cada acción y la política de la empresa se vuelve código probado.

agentic-app es un framework en Python para que las empresas construyan apps de IA a partir de un resultado de negocio, y no a partir del agente. Sirve para quien necesita poner IA dentro de un proceso real (RR. HH., gestión de personas, atención) con control: el LLM corre dentro de un workflow fijo, toda acción externa espera aprobación humana, las reglas con números se vuelven código probado y cada ejecución queda registrada. Incluye una app de ejemplo completa (coaching para gerentes) y funciona solo con Python 3 instalado, sin clave y sin internet.
La pregunta de partida no es "¿qué agente vamos a crear?". Es "¿quién decide qué, y cómo medimos si mejoró?". El agente entra después, como una pieza del proceso.
Cada uso de LLM es un nodo entre otros cuatro: contexto, código, condición y formato. Misma entrada, misma salida.
El workflow solo propone. El correo queda en la cola hasta que la persona lo lea, edite y apruebe. Todo va al audit log.
El manual de vacaciones se vuelve funciones con entrada estricta y 13 pruebas de política. Si cambia un número, una prueba se rompe.
Cada pilar tiene un archivo y al menos una prueba. Usa la lista para revisar cualquier app de IA de tu empresa, aunque no uses este código.
Canvas con persona usuaria, decisión y métrica de éxito antes de pensar en el agente.
templates/canvas-resultado.md
Nodos contexto → código → condición → LLM → formato. El modelo se elige por la tarea, no por gusto.
workflow.py · config.py
El botón del panel envía la entrada al workflow y el resultado vuelve en la propia pantalla, como borrador editable.
painel.html · serve.py
Toda acción externa pasa por revisión, edición y aprobación. Los campos sensibles, como el destinatario, quedan bloqueados.
acoes.py
Observan los datos (meta vencida, 1:1 atrasado, compromiso en caída) y sugieren próximos pasos con un botón de ejecutar.
workflow proximos_passos
Clasifica la pregunta, carga solo la política correcta y le da al agente solo las herramientas de esa política. La búsqueda queda para preguntas abiertas.
policies/ferias.py
Roles que pueden ejecutar, identidad de servicio con alcance mínimo y audit log con hash encadenado.
seguranca.py
Manual, programado (lunes 08:00) y por evento (correo recibido), declarados en el propio JSON del workflow.
gatilhos.py
Informe en HTML y PDF, generado por workflow, en lugar de una pared de texto.
relatorio.py
El motor verifica quién lo pidió, asume la identidad del workflow, valida la entrada y corre los nodos en orden. La salida es JSON validado. Las acciones se vuelven propuestas. Una línea de auditoría por ejecución.
perfil (contexto, identidad svc-rh) → categoría (el LLM clasifica: vacaciones, licencia parental u otro) → condición → datos (el código extrae los números de la pregunta) → agente (el LLM elige entre las herramientas SOLO de esa política) → explicación (código) → formato.
equipo (contexto) → metas vencidas (código) → ¿hay pendientes? (condición) → borradores (el LLM redacta uno por persona) → el formato valida y propone 6 correos. Ninguno sale antes de la aprobación.
Nada que instalar con pip. Ninguna clave de API. Las pruebas bloquean la red a propósito.
Linux, Mac o Windows.
# verificar python3 --version
Para descargar el repositorio.
git --versionSolo si quieres cambiar el LLM falso por un modelo local.
# opcional ollama list
Los cuatro primeros pasos ejecutan el ejemplo. Los demás muestran lo que cambias para tu empresa. La guía completa, con checklist de implementación, está en docs/PASSO-A-PASSO.md (en portugués).
104 checks, sin red. La última línea tiene que ser OK.
git clone https://github.com/inematds/agentic-app cd agentic-app bash tests/run.sh # 104 checks, 0 fallas → OK
Ejecuta los 5 workflows: RBAC denegando, borradores, aprobación con edición, asistente de RR. HH., programado de lunes 08:00, evento de correo recibido e informe.
python3 -m agentic_app.demo # genera saida/relatorio.html, saida/relatorio.pdf, saida/audit.jsonl
Cambia de persona arriba (gerente, RR. HH., colaborador) y mira qué puede hacer cada rol.
python3 -m agentic_app.serve --porta 8765 # http://127.0.0.1:8765 (solo en tu máquina)
El script cambia nueve números del manual, uno a la vez, y verifica que alguna prueba se rompa.
bash tests/prova_mutacao.sh # 9× "quebrou (bom)" → OK
Persona usuaria, decisión, costo de hoy y un número de éxito con plazo. Sin métrica, no empieces.
cp templates/canvas-resultado.md docs/meu-canvas.md
Una constante por cada número del documento, una prueba por límite (el valor exacto y el vecino).
cp templates/politica_modelo.py agentic_app/policies/reembolso.py cp templates/test_politica_modelo.py tests/test_reembolso.py
Contexto → código → condición → LLM → formato. La acción externa va en propor_acao, con los campos editables. Muévelo a la carpeta workflows/ de tu app solo después de registrar el contexto y la función que usa.
cp templates/workflow-modelo.json meu_workflow.json python3 -c "from agentic_app.workflow import carregar_spec as c; c('meu_workflow.json')"
Quién ejecuta cada workflow, con qué cuenta de servicio actúa y quién aprueba lo que propone.
cat templates/permissoes.json
El falso se queda en las pruebas. Para un modelo local, una variable. Para otro proveedor, una subclase de LLM.
AGENTIC_LLM=ollama python3 -m agentic_app.demo
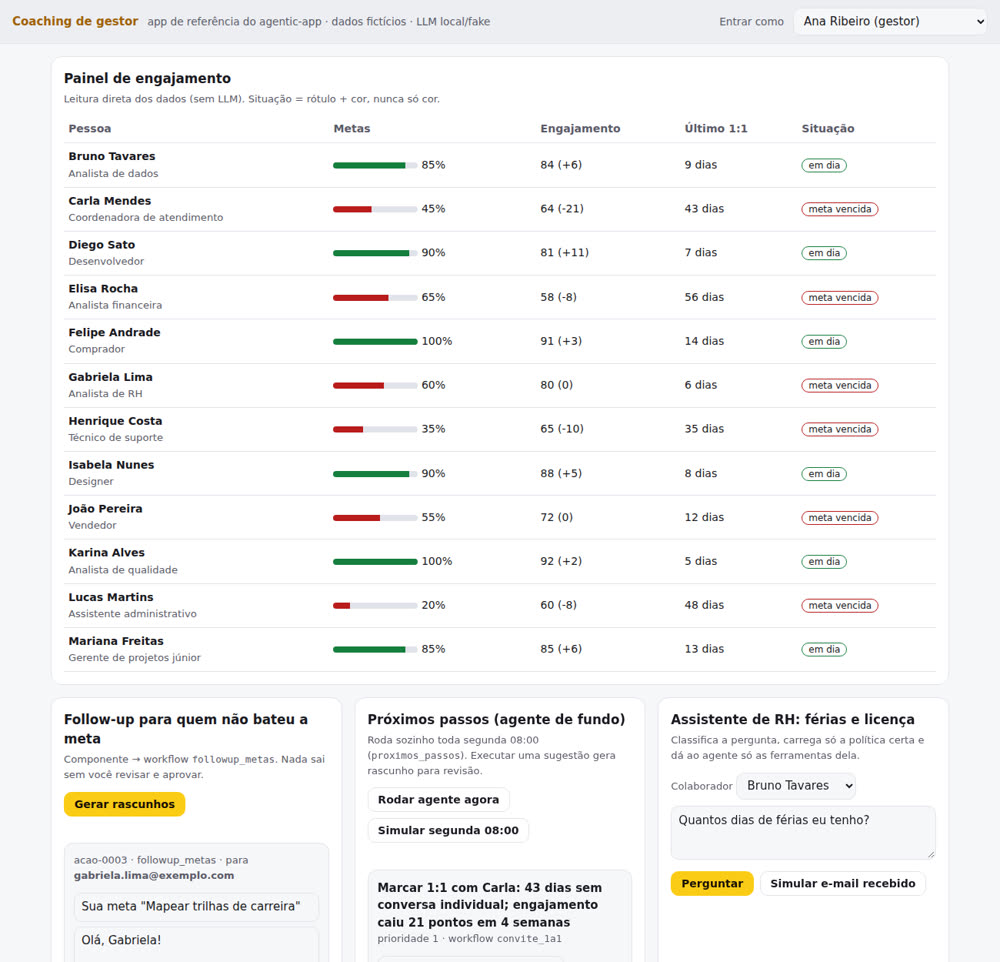
Datos ficticios. La gerente ve al equipo, genera seguimientos para quienes no alcanzaron la meta, recibe sugerencias del agente de fondo y responde dudas de vacaciones con la política codificada.


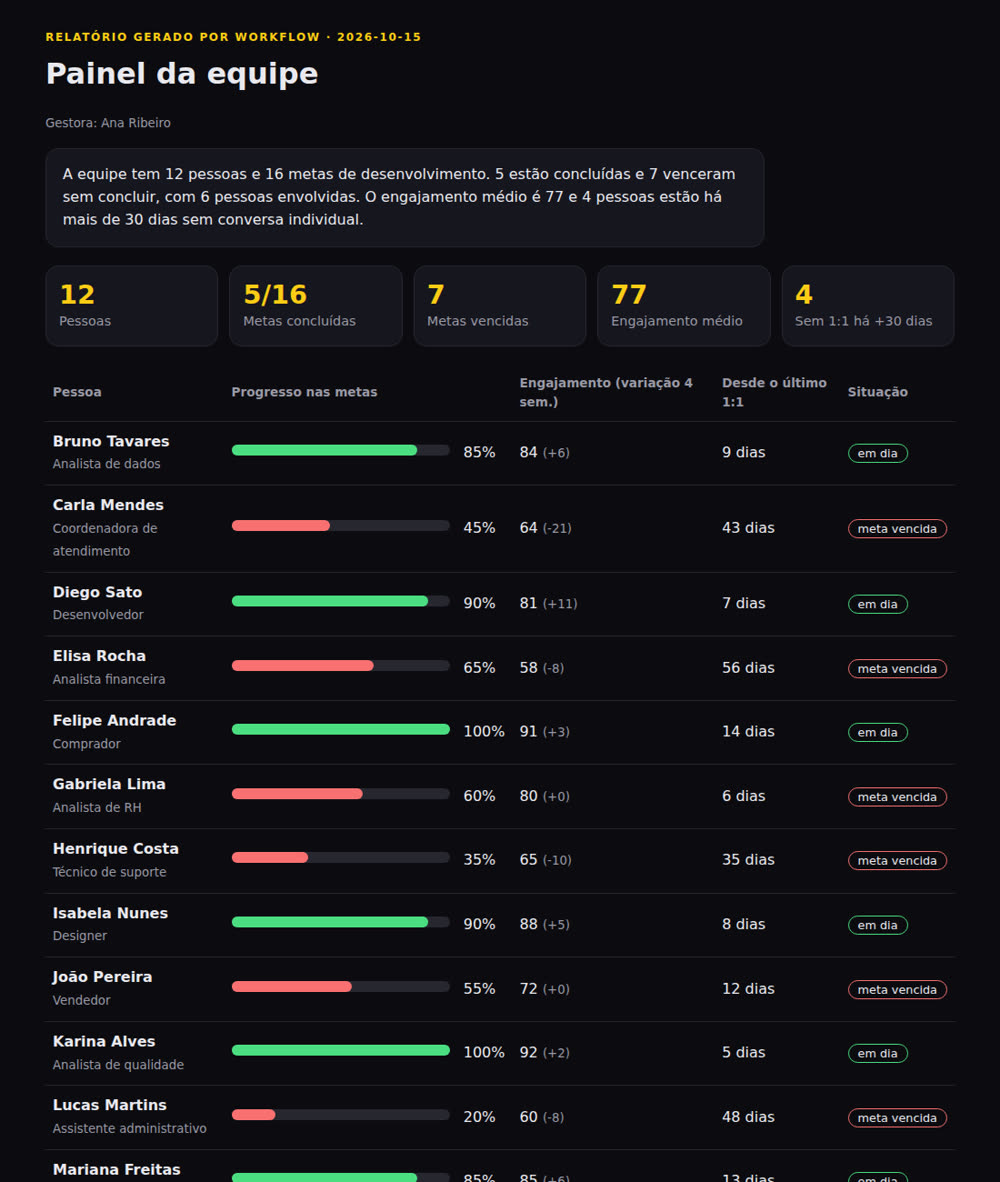
relatorio_equipe: 12 personas, 16 metas, 7 vencidas. También sale en PDF.| Componente | Workflow | Nodos | Quién ejecuta | Actúa como |
|---|---|---|---|---|
| Seguimiento de metas | followup_metas | 6 | gestor, sistema | svc-coaching |
| Próximos pasos | proximos_passos | 6 | sistema, gestor | svc-coaching |
| Invitación a 1:1 | convite_1a1 | 4 | gestor | svc-coaching |
| Asistente de RR. HH. | assistente_rh | 10 | colaborador, gestor, rh, sistema | svc-rh |
| Informe | relatorio_equipe | 4 | gestor, rh, sistema | svc-coaching |
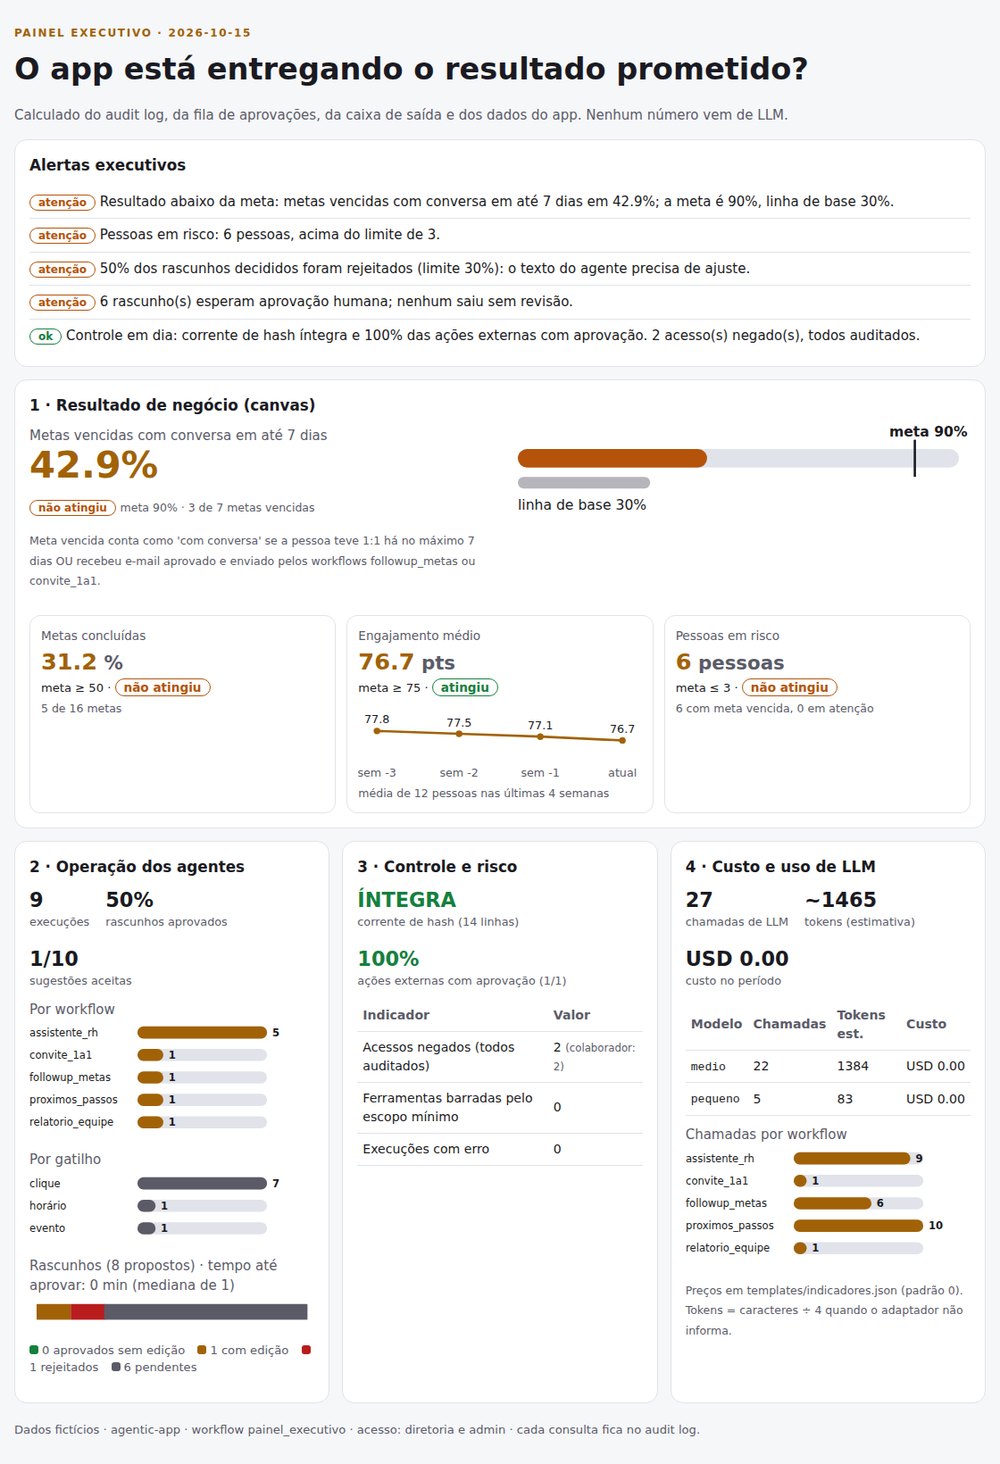
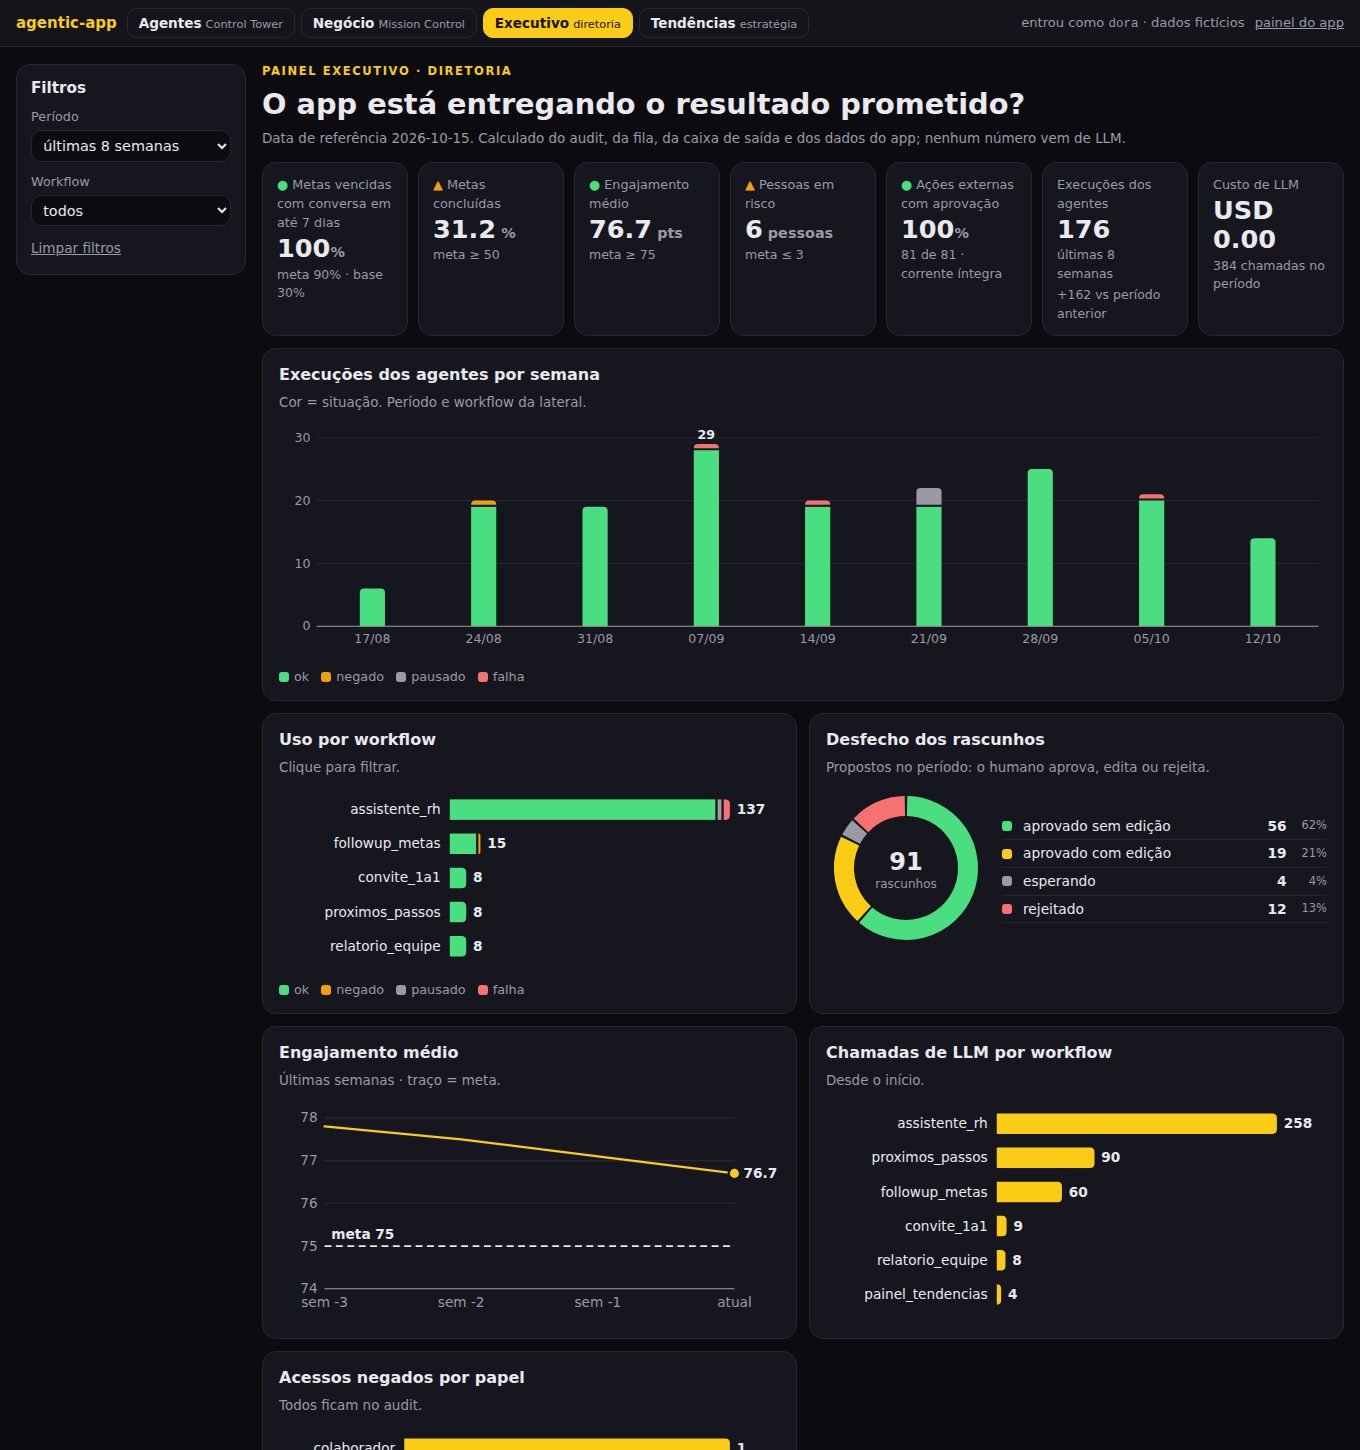
El panel del gerente es la pantalla de trabajo. El panel ejecutivo le responde a quien patrocina la app, con números calculados del audit log, la cola de aprobación, la bandeja de salida y los datos de la app. Ningún número viene de un LLM.

La métrica del canvas contra la meta y la línea de base, con estado "alcanzó" o "no alcanzó". En la demo: metas concluidas 31,2%, compromiso medio 76,7 y 6 personas en riesgo.
Ejecuciones por workflow y por disparador (clic 7, horario 1, evento 1), borradores aprobados, editados y rechazados, tiempo hasta aprobar y sugerencias del agente de fondo aceptadas (1 de 10).
Accesos negados por rol, herramientas bloqueadas por alcance mínimo, cadena de hash íntegra o rota (con la línea) y el % de acciones externas con aprobación, que tiene que ser 100%.
Llamadas por workflow y por modelo (el FakeLLM cuenta igual), tokens estimados y costo según la tabla de templates/indicadores.json, que viene en cero.
De 3 a 5 frases cortas armadas por código, en el orden crítico → atención → ok. Una cadena rota o un e-mail sin aprobación suben al principio.
El panel es el workflow painel_executivo, con identidad de solo lectura. Colaborador y gerente reciben 403, y el intento se vuelve una línea workflow.negado en el audit.
python3 -m agentic_app.demo # sección 10: resumen ejecutivo python3 -m agentic_app.serve # http://127.0.0.1:8765/executivo?usuario=dora
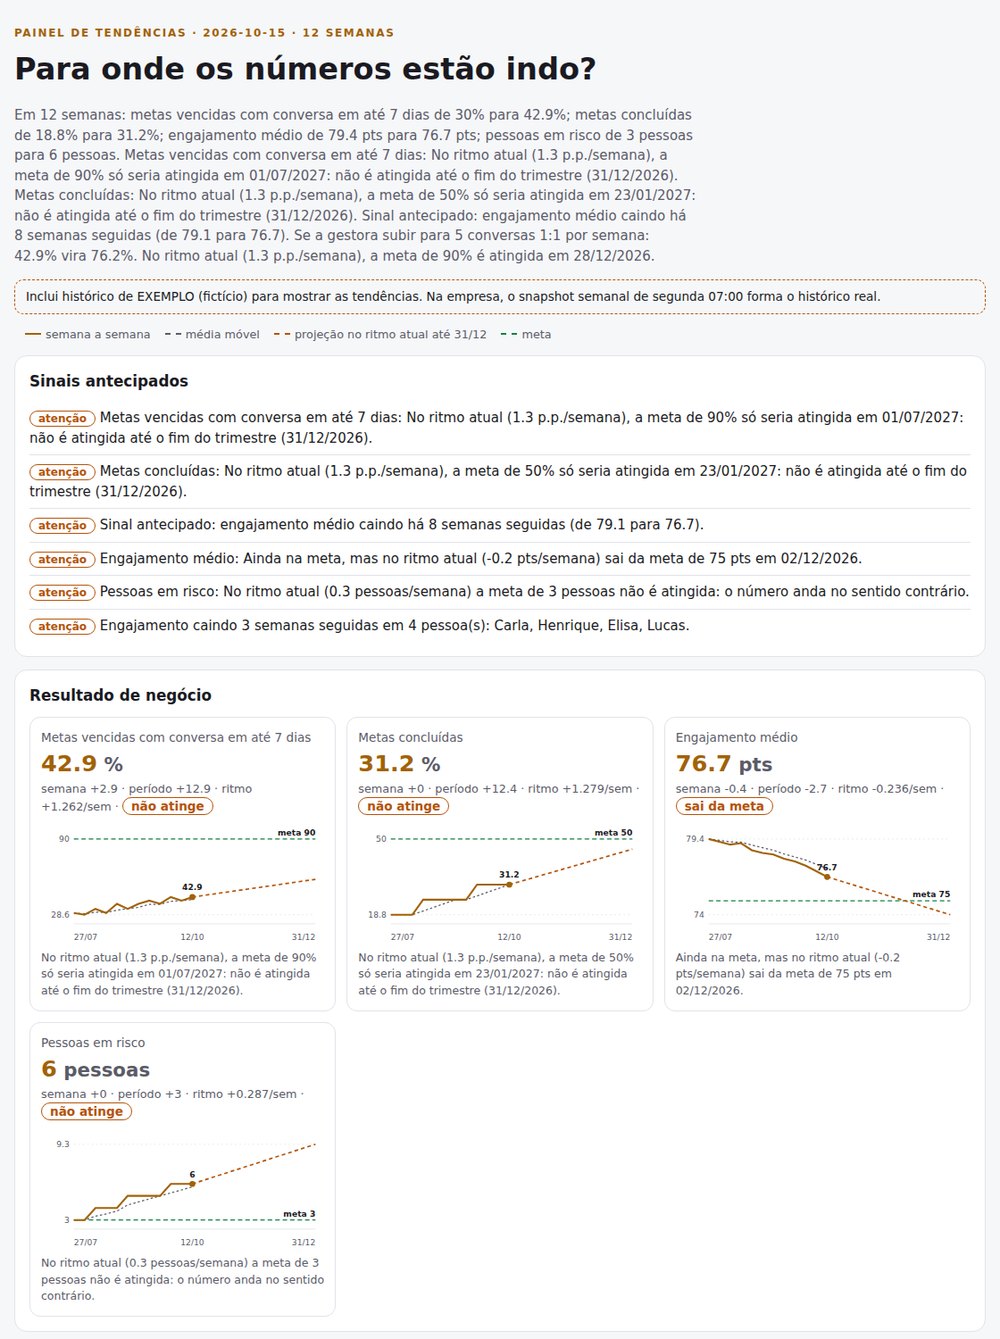
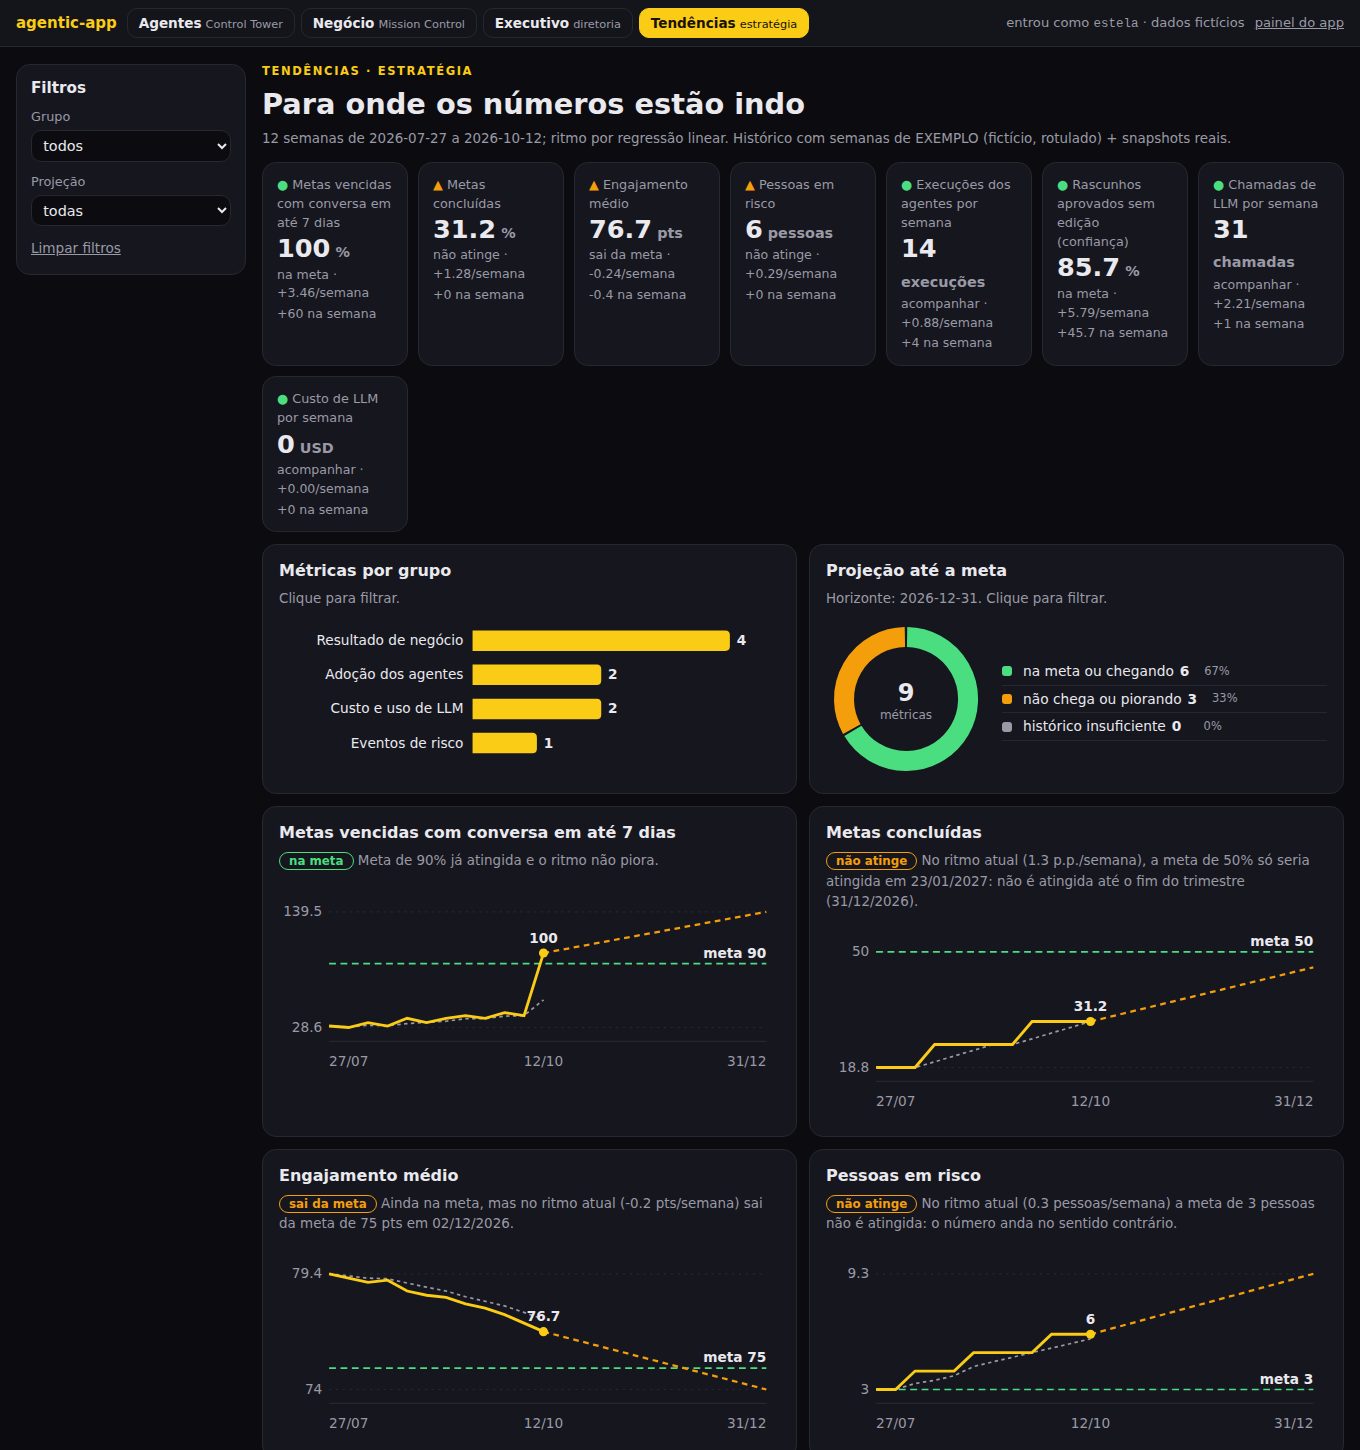
El panel ejecutivo muestra si la app entrega ahora. El de tendencias usa el historial semanal para dar el ritmo de cada número, cuándo llega la meta (o que no llega en el trimestre) y qué está empeorando antes de volverse un problema.
Regresión lineal simple sobre las semanas: "al ritmo actual, la meta se alcanza el DD/MM" o "no se alcanza hasta el fin del trimestre". Una meta ya alcanzada pero empeorando muestra la fecha en que se pierde.
Tres semanas seguidas en el sentido malo se vuelven alerta. En la demo: compromiso medio cayendo hace 8 semanas y 4 personas con 3 caídas seguidas (Carla, Henrique, Elisa, Lucas).
Regla explícita en el código: cada 1:1 extra por semana cubre a una persona con meta vencida. Con 5 por semana, 42,9% pasa a 76,2% y la meta de 90% llega el 28/12/2026.
El workflow snapshot_indicadores graba la foto de la semana cada lunes 07:00 en saida/historico.jsonl. Con menos de 4 semanas, el panel dice "historial insuficiente".
Workflow painel_tendencias con identidad de solo lectura. El LLM solo hilvana la narrativa con frases ya calculadas; cambiar el LLM no cambia ningún número.
python3 -m agentic_app.demo # sección 11: snapshot + tendencias # http://127.0.0.1:8765/tendencias?usuario=estela

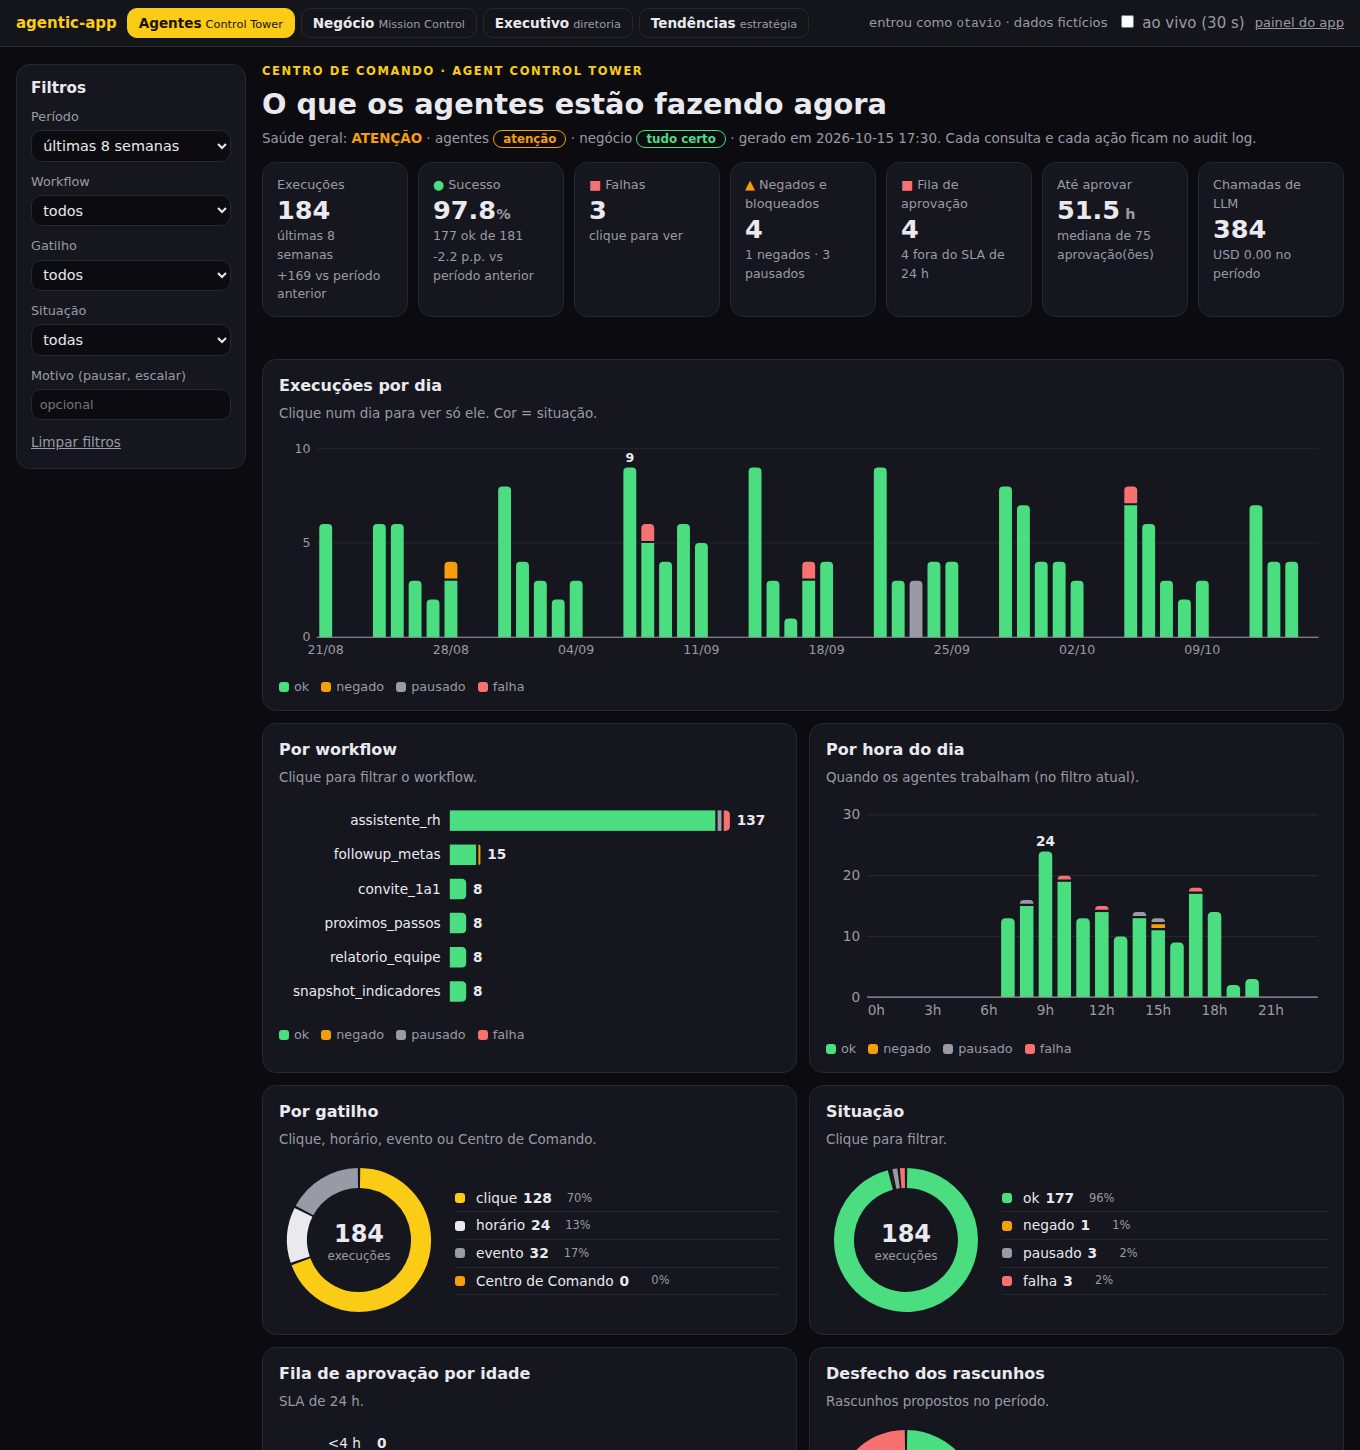
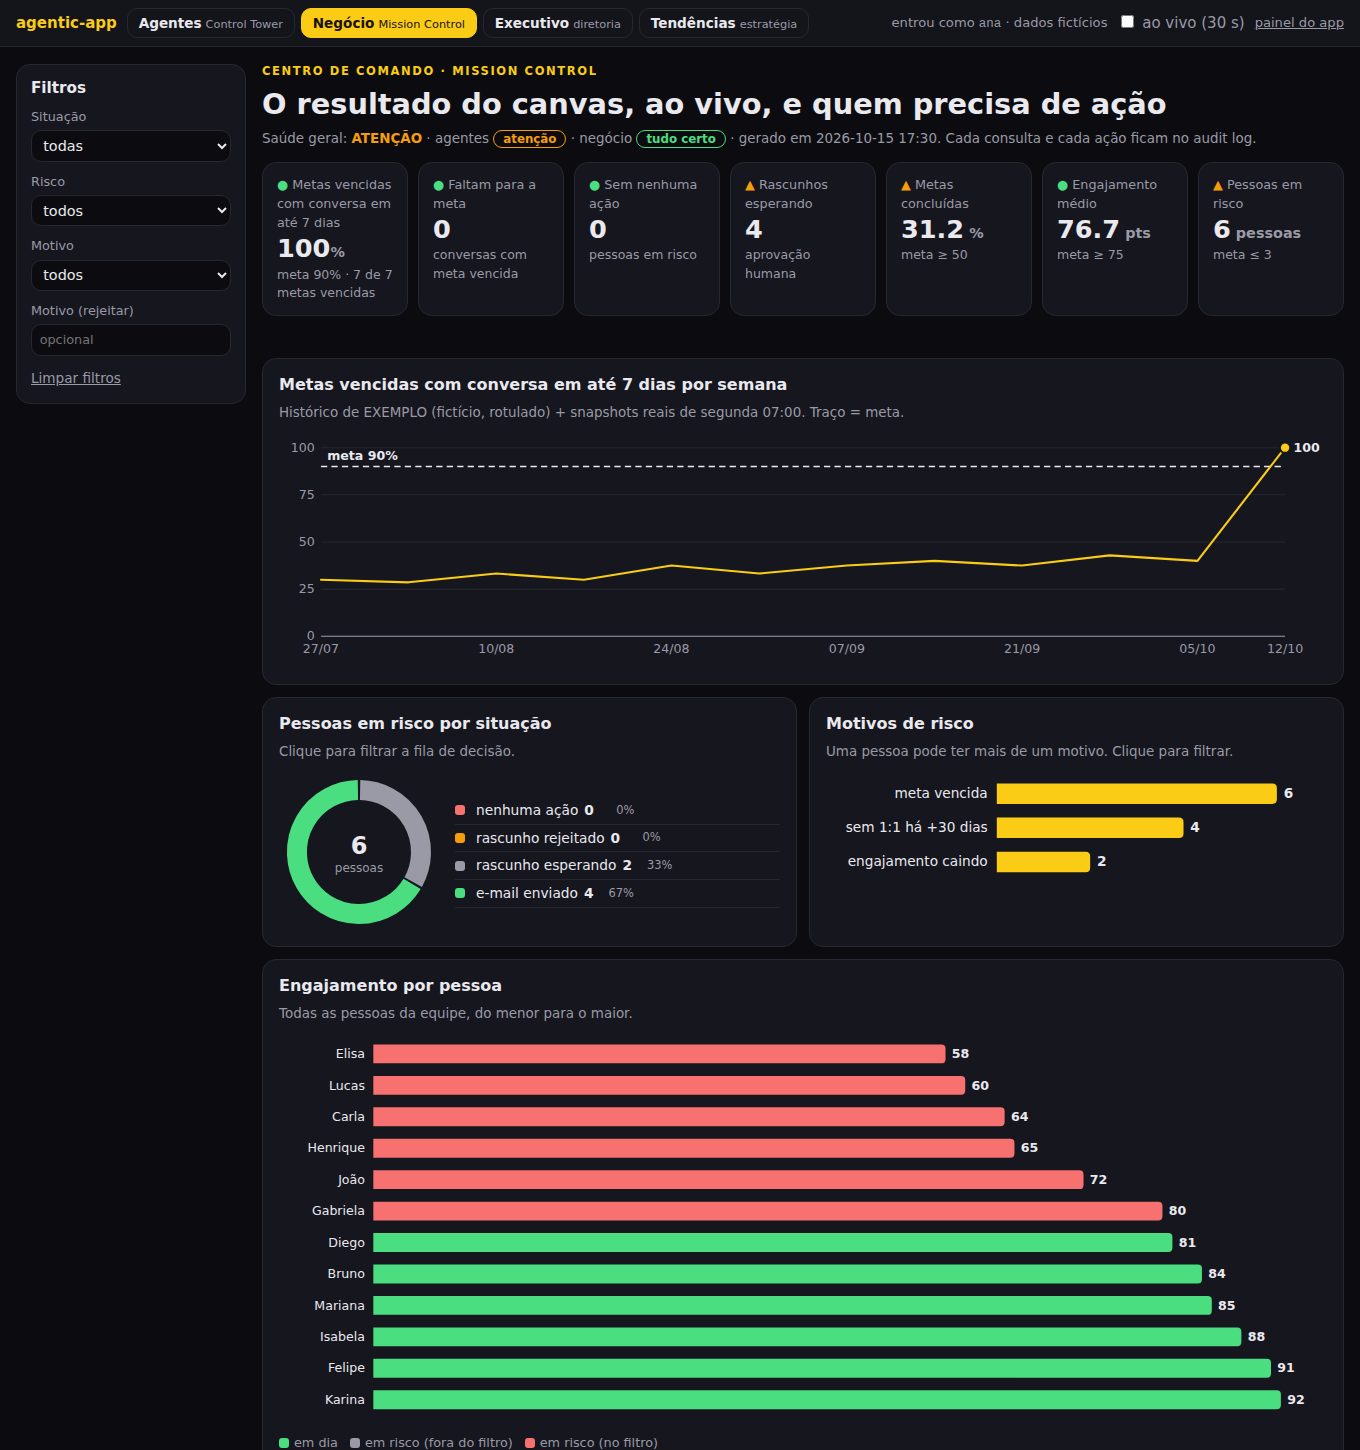
El ejecutivo y las tendencias son para quien decide. El Centro de Comando es para quien sigue en vivo y actúa en el momento. Dos pestañas: Agentes (Agent Control Tower) y Negocio (Mission Control).
Semáforo por workflow (ok, atención, falla, pausado), última ejecución, próximo disparo agendado, cola de aprobación por antigüedad con SLA de 24 h, fallas y accesos negados, cadena del audit y últimos eventos.
Pausar (el disparo queda en el audit y no corre; los otros agendados siguen), reanudar, ejecutar ahora, reejecutar y escalar una aprobación detenida. Solo el rol operacao y admin. Operación nunca aprueba ni envía.
La métrica del canvas contra la meta y cuántas conversaciones faltan (en la demo: 42,9%, faltan 4). Cola de decisión: quién está en riesgo, en qué estado está y la próxima acción, con botón para activar el agente, aprobar o rechazar.
Un botón sin permiso aparece deshabilitado con el motivo, y el servidor vuelve a verificar. Toda acción y toda negativa van al audit. Reejecutar solo rehace lo que no exige guardar la entrada de la persona.
python3 -m agentic_app.demo # sección 12: pausar, escalar, panel # http://127.0.0.1:8765/comando?usuario=otavio


Agentes, Negocio, Ejecutivo y Tendencias usan ahora el layout de los paneles de BI: números grandes arriba, filtros al costado, gráficos en el medio y, abajo, el detalle con las acciones. Un clic en un gráfico filtra el resto de la página.
Una barra arriba lleva a los cuatro paneles. Cada uno mantiene su rol: quien no puede verlo recibe 403 y el intento queda en el audit.
Barra, día, porción o tarjeta se vuelven filtro (?workflow=…&situacao=falha). Los filtros activos aparecen como etiquetas; otro clic los quita. El enlace se puede guardar y compartir.
Columnas, barras, donas y líneas dibujadas en Python, sin biblioteca ni CDN. Tooltip al pasar el mouse, leyenda cuando hay dos o más series, color de estado siempre con etiqueta.
python3 -m agentic_app.simular corre el motor real con reloj simulado (ficticio, siempre igual) para que los gráficos tengan qué mostrar.
python3 -m agentic_app.simular python3 -m agentic_app.serve


Los videos de explicación aparecerán aquí.
agentic-app no reemplaza a los otros kits INEMA. Se apoya sobre ellos.
El agente de la empresa en archivos: identidad, skills, reglas y medición. Responde quién es el agente y cómo trabaja aquí.
Cómo los agentes descubren, conectan y usan las herramientas que ya tienes. Responde por dónde el agente llega a las herramientas.
La aplicación que usa la persona de negocio: pantalla, workflow fijo, política en código, aprobación y auditoría. Responde qué resultado gana la empresa.
La versión 1.0.0 es el núcleo completo con una app de referencia. Después llegaron el panel ejecutivo (1.1.0), el de tendencias (1.2.0), el Centro de Comando (1.3.0) y el layout común de BI en los cuatro paneles (1.4.0).