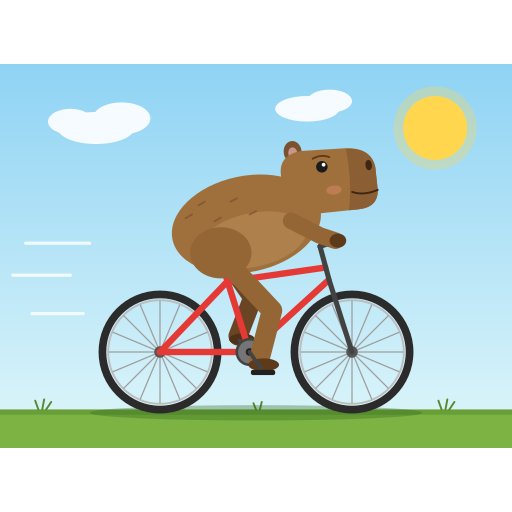
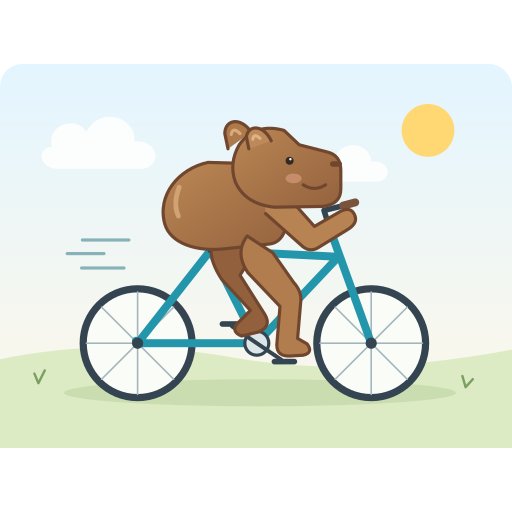
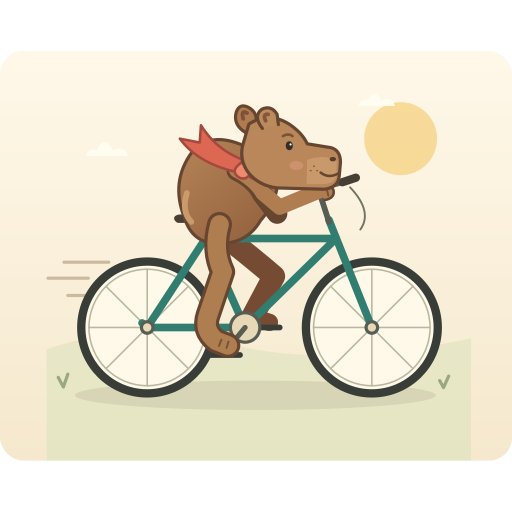
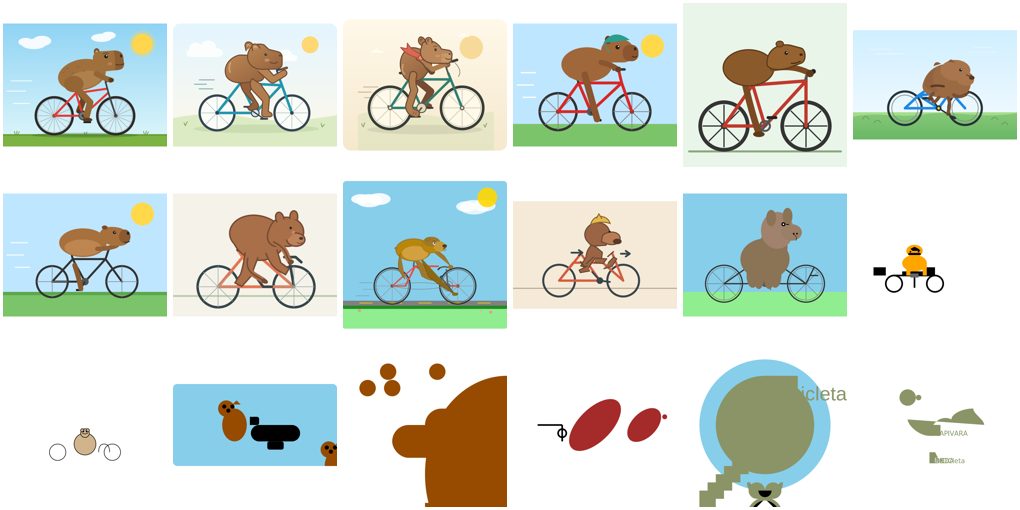
Pedimos o mesmo desenho, em código SVG, a 19 modelos: 10 rodando no próprio computador e 9 pela assinatura do Claude e do ChatGPT. Um juiz comparou tudo dois a dois, sem saber quem fez o quê. O kit é aberto: rode com os seus modelos.

Simon Willison mede cada modelo novo pedindo "um SVG de um pelicano andando de bicicleta". Ele não confia nos leaderboards; prefere um teste próprio, que ele mesmo entende. O Google já mostrou o pelicano dele num keynote, então trocamos o bicho.
Modelo de texto não desenha: ele escreve código. Bicicleta é difícil de lembrar, capivara é difícil de desenhar e capivara não pedala. Dá para ver na hora quem entende forma e composição.
O juiz vê só "A" e "B", sem nomes. Cada par aparece duas vezes, trocando os lados, para anular a mania de preferir a esquerda. Um segundo juiz de outra empresa refaz uma amostra.
Modelos locais pelo Ollama; Claude e GPT pelas CLIs claude e codex, usando a assinatura que você já paga. Nenhuma chave de API.
Claude Fable 5.1 venceu 97% dos confrontos. A surpresa: Qwen 3.8 27B, rodando no próprio computador, ficou em 5º de 18, à frente do GPT-5.5 e do Claude Sonnet 5.5. Command R 35B não entregou SVG válido. O segundo juiz (GPT-6 Luna) concordou com o primeiro em 92% dos 64 confrontos que refez.


Cada etapa grava em resultados/ e pula o que já foi feito. Dá para parar e continuar.
Manda o mesmo pedido a cada modelo de modelos.json, guarda a resposta crua e extrai o <svg>. Modelos locais rodam um por vez, para caber na memória.
Converte SVG em PNG (sem buscar nada na internet), monta as imagens A|B e pede ao juiz um JSON com o vencedor e o motivo.
Taxa de vitória (o número mais honesto), ELO médio de 200 ordens sorteadas, viés de lado e concordância entre juízes. Gera a página pública em PT, EN e ES.
Só o primeiro é obrigatório. Use os motores que tiver; tire os outros do modelos.json.
Com cairosvg (SVG para PNG) e Pillow.
pip install cairosvg pillowQualquer modelo que você já tenha baixado. Um 8B roda em notebook; um 70B pede uns 48 GB de memória.
ollama pull llama3.1:8b ollama list
Opcional. Logados com a sua assinatura; o kit chama claude -p e codex exec.
claude --version codex --version
Comece pequeno: dois ou três modelos. Depois aumente.
Os resultados da nossa rodada vêm junto, em resultados/. Apague a pasta se quiser começar do zero.
git clone https://github.com/inematds/arena-capivara cd arena-capivara rm -rf resultados && mkdir -p resultados/{svgs,respostas,png,pares} # opcional: arena limpa
Edite arena/modelos.json. Cada linha tem motor (ollama, claude ou codex) e o nome do modelo, igual ao que aparece no ollama list ou na CLI.
{"id": "llama3-1-8b", "motor": "ollama", "modelo": "llama3.1:8b",
"rotulo": "Llama 3.1 8B", "familia": "Local"}
Claude e Codex rodam em paralelo; modelos locais, um de cada vez. Quem não devolve SVG fica registrado como "não entregou", o que também é resultado.
python3 arena/gerar.py # ou --so llama3-1-8b claude-haiku-4-5
python3 arena/renderizar.py # "N imagens válidas, M confrontos montados"
O padrão é o Claude Sonnet 5.5. O segundo juiz refaz uma amostra para você saber o quanto confiar no primeiro.
python3 arena/julgar.py --paralelo 4 python3 arena/julgar.py --juiz codex --modelo gpt-6-luna --amostra 60
python3 arena/ranking.py --tabela # tabela no terminal + resultados/ranking.json python3 arena/galeria.py # resultados/index.html (+ en/ es/) python3 -m http.server 8000 # abra http://localhost:8000/resultados/
A lição da palestra não é "o modelo X desenha melhor". É: não terceirize a escolha do modelo para um leaderboard. Monte um teste pequeno que você entende e rode quando sair modelo novo.
arena/prompt.txt.resultados/respostas/).Troque o texto de arena/prompt.txt e a pergunta do juiz (PERGUNTA em arena/julgar.py). Se a saída for texto e não desenho, pule o renderizar.py e mande o juiz ler as duas respostas. Para usar o próprio histórico do Claude Code como teste, veja o personal-benchmark.
A arena fica aberta. Mande sua rodada por pull request.