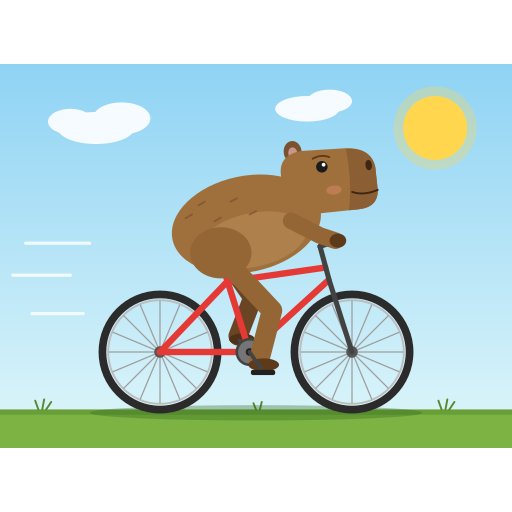
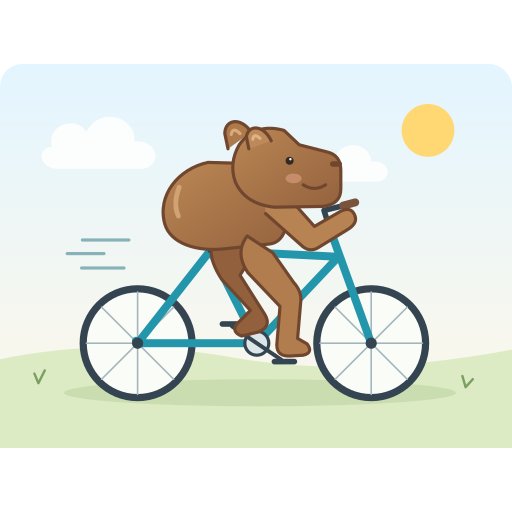
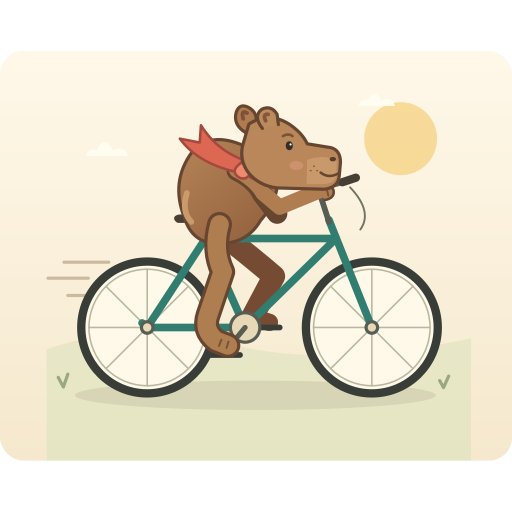
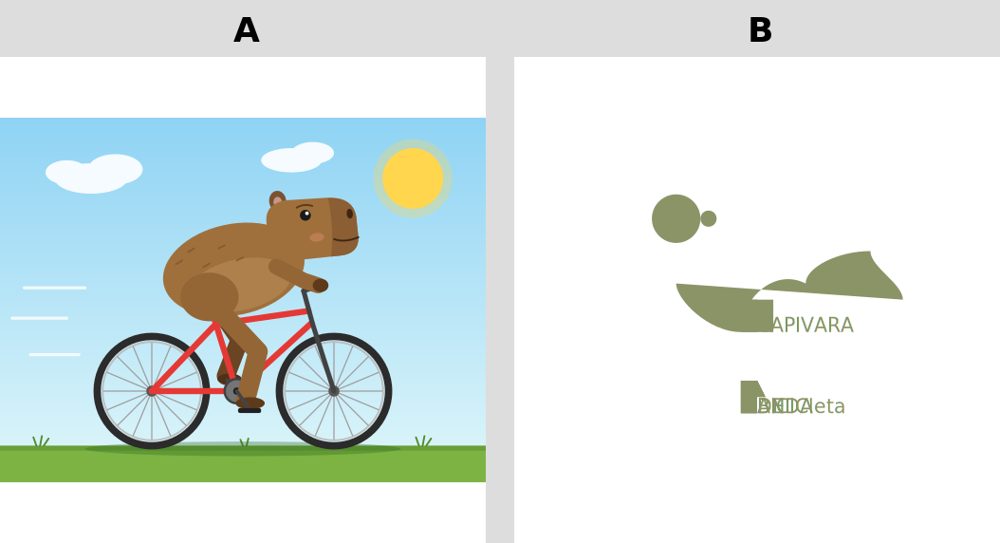
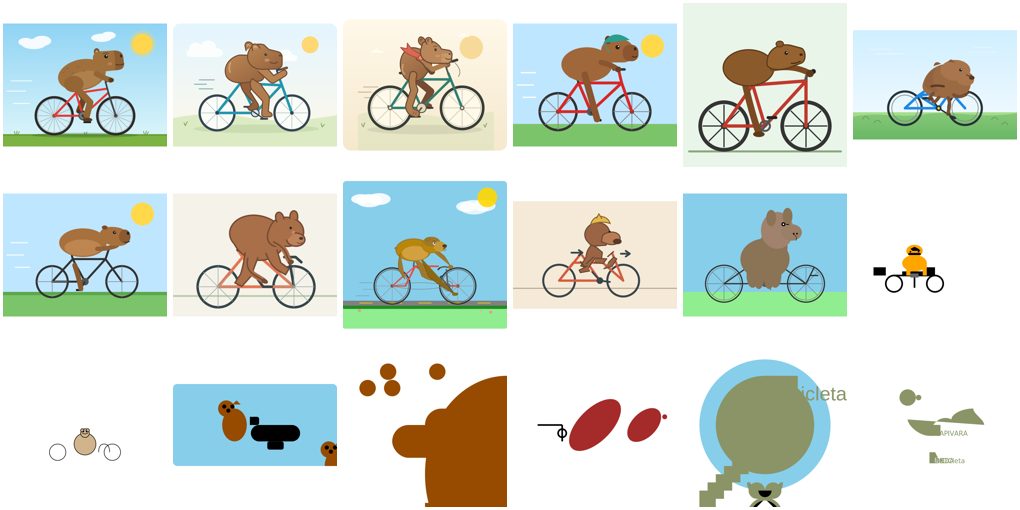
Pedimos el mismo dibujo, en código SVG, a 19 modelos: 10 que se ejecutan en la propia computadora y 9 mediante las suscripciones de Claude y ChatGPT. Un juez comparó todo de a dos, sin saber quién hizo cada dibujo. El kit es abierto: ejecútalo con tus modelos.

Simon Willison evalúa cada modelo nuevo pidiéndole "un SVG de un pelícano andando en bicicleta". No confía en las tablas de clasificación; prefiere una prueba propia que él mismo entiende. Google ya mostró su pelícano en una presentación principal, así que cambiamos el animal.
Un modelo de texto no dibuja: escribe código. Es difícil imaginar una bicicleta, difícil dibujar un capibara y los capibaras no pedalean. Así se ve de inmediato quién entiende las formas y la composición.
El juez solo ve "A" y "B", sin nombres. Cada par aparece dos veces, intercambiando los lados, para anular la tendencia a preferir la izquierda. Un segundo juez de otra empresa vuelve a evaluar una muestra.
Modelos locales con Ollama; Claude y GPT mediante las CLI claude y codex, con la suscripción que ya pagas. No se necesita ninguna clave de API.
Claude Fable 5.1 ganó el 97% de los enfrentamientos. La sorpresa: Qwen 3.8 27B, ejecutado en la propia computadora, quedó en el 5.º puesto de 18, por delante de GPT-5.5 y Claude Sonnet 5.5. Command R 35B no entregó un SVG válido. El segundo juez (GPT-6 Luna) coincidió con el primero en el 92% de los 64 enfrentamientos que volvió a evaluar.


Cada etapa guarda sus resultados en resultados/ y omite lo que ya se hizo. Puedes detenerte y continuar después.
Envía el mismo pedido a cada modelo de modelos.json, guarda la respuesta original y extrae el <svg>. Los modelos locales se ejecutan de uno en uno para que quepan en la memoria.
Convierte SVG a PNG (sin buscar nada en Internet), arma las imágenes A|B y le pide al juez un JSON con el ganador y el motivo.
Porcentaje de victorias (el dato más honesto), ELO promedio de 200 órdenes aleatorios, sesgo por lado y concordancia entre jueces. Genera la página pública en PT, EN y ES.
Solo el primero es obligatorio. Usa los motores que tengas y quita los demás de modelos.json.
Con cairosvg (de SVG a PNG) y Pillow.
pip install cairosvg pillowCualquier modelo que ya hayas descargado. Un 8B funciona en una laptop; un 70B requiere unos 48 GB de memoria.
ollama pull llama3.1:8b ollama list
Opcional. Inicia sesión con tu suscripción; el kit ejecuta claude -p y codex exec.
claude --version codex --version
Empieza con poco: dos o tres modelos. Después agrega más.
Los resultados de nuestra ronda vienen incluidos en resultados/. Elimina la carpeta si quieres empezar desde cero.
git clone https://github.com/inematds/arena-capivara cd arena-capivara rm -rf resultados && mkdir -p resultados/{svgs,respostas,png,pares} # opcional: arena limpia
Edita arena/modelos.json. Cada línea tiene motor (ollama, claude o codex) y el nombre del modelo, tal como aparece en ollama list o en la CLI.
{"id": "llama3-1-8b", "motor": "ollama", "modelo": "llama3.1:8b",
"rotulo": "Llama 3.1 8B", "familia": "Local"}
Claude y Codex se ejecutan en paralelo; los modelos locales, de uno en uno. Si un modelo no devuelve SVG, queda registrado como "no entregó", lo cual también es un resultado.
python3 arena/gerar.py # o --so llama3-1-8b claude-haiku-4-5
python3 arena/renderizar.py # "N imágenes válidas, M enfrentamientos armados"
El predeterminado es Claude Sonnet 5.5. El segundo juez vuelve a evaluar una muestra para que sepas cuánto confiar en el primero.
python3 arena/julgar.py --paralelo 4 python3 arena/julgar.py --juiz codex --modelo gpt-6-luna --amostra 60
python3 arena/ranking.py --tabela # tabla en la terminal + resultados/ranking.json python3 arena/galeria.py # resultados/index.html (+ en/ es/) python3 -m http.server 8000 # abre http://localhost:8000/resultados/
La lección de la presentación no es "el modelo X dibuja mejor". Es: no delegues la elección del modelo a una tabla de clasificación. Diseña una prueba pequeña que entiendas y ejecútala cuando salga un modelo nuevo.
arena/prompt.txt.resultados/respostas/).Cambia el texto de arena/prompt.txt y la pregunta del juez (PERGUNTA en arena/julgar.py). Si el resultado es texto y no un dibujo, omite renderizar.py y pídele al juez que lea ambas respuestas. Para usar el historial de Claude Code como prueba, consulta personal-benchmark.
La arena está abierta. Envía tu ronda mediante un pull request.