Claude Code · Fable 5.2 · solo lectura
Audita tu Claude para Fable 5.2
El prompt que funcionaba con el modelo anterior puede ser un obstáculo ahora. Encuentra las líneas antiguas en 5 segundos, con informe y gráficos.
El prompt que funcionaba con el modelo anterior puede ser un obstáculo ahora. Encuentra las líneas antiguas en 5 segundos, con informe y gráficos.
audite-seu-claude es un pequeño programa en Python que lee la configuración de tu Claude Code (el archivo CLAUDE.md, las skills, las memorias, los plugins y los scripts) y señala las instrucciones escritas para modelos anteriores que ahora dificultan el uso de Claude Fable 5.2. Es para quienes usan Claude Code a diario y van a cambiar de modelo. Entrega un informe con gráficos y una lista de sugerencias; tú marcas las que apruebas y tu propio Claude aplica solo esas correcciones. Solo necesitas Python 3: no usa internet ni modifica tu configuración (solo guarda el informe donde le indiques).
Nei explica qué publicó Anthropic sobre Fable 5.2, por qué el prompt anterior puede ser un obstáculo ahora y cómo el kit encuentra esas líneas.
Anthropic publicó 10 puntos de atención para Fable 5.2. Sigue las instrucciones al pie de la letra, por lo que las reglas antiguas producen efectos distintos. El kit convierte esos 10 puntos en comprobaciones automáticas.
Peticiones de razonamiento en el texto (pueden provocar un rechazo), «piensa menos», presupuesto de tokens, orden de delegar siempre, «nunca» sin motivo, estilo rígido, esfuerzo antiguo.
Gráficos por punto, por archivo y el peso del texto que entra en cada sesión: CLAUDE.md, índice de memoria y descripciones de skills. También señala skills repetidas y memorias antiguas.
Marca las sugerencias y genera correcoes.md. Se convierte en la solicitud de corrección: un elemento cada vez, con una copia del original. Las reglas de seguridad nunca se borran.
El programa solo lee. Tú decides qué cambia; tu Claude edita únicamente lo que aprobaste.
Fuente: Prompting Claude Fable 5.2 (consultada el 11/11/2026). Las cifras proceden de las pruebas de la propia Anthropic.
El valor predeterminado de la API es high. Medium para el día a día; xhigh y max solo cuando hayas medido una mejora. «Responde sin pensar» no reduce el razonamiento: baja el esfuerzo. Comprueba: max fijo, xhigh predeterminado, ajuste copiado de un modelo antiguo, Fable 5.2 en low/medium.
En tareas largas a veces se detiene antes de terminar, más a menudo en low y medium. El texto oficial redujo a la mitad las sesiones abandonadas a medias, con +~30% de tokens. Comprueba: si tu CLAUDE.md contiene este texto (está en blocos/terminar-tarefa.md). En Claude Code con Fable 5.2, este texto ya viene activado de fábrica.
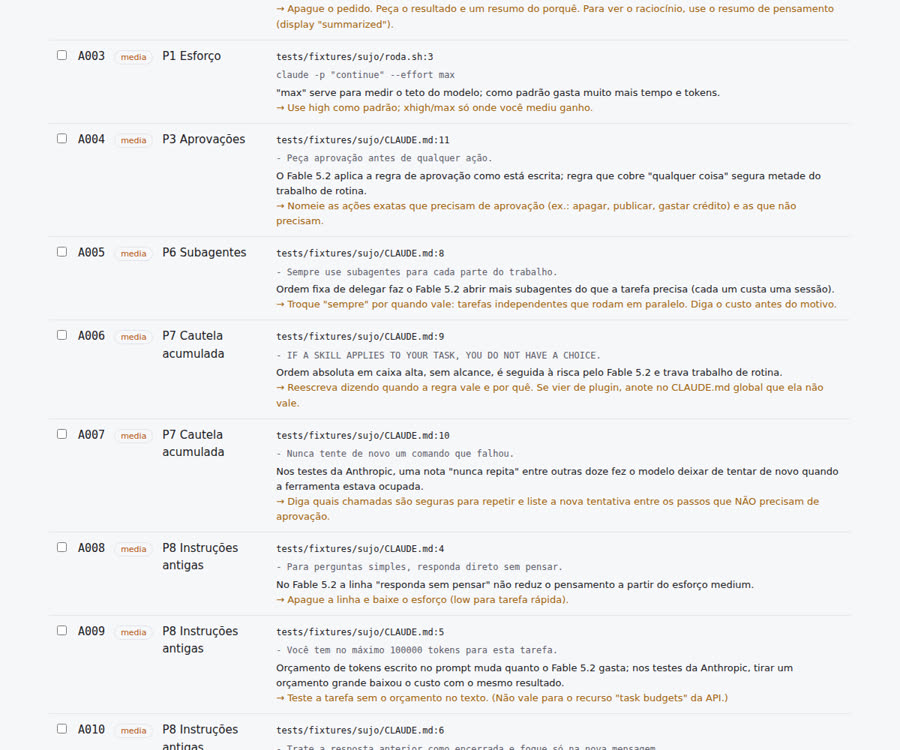
Indica la acción («sí, ejecuta la migración en la base de datos de prueba») en vez de «continúa». La regla de aprobación debe nombrar las acciones. Comprueba: aprobación para «cualquier acción» y claude -p "continue" en un script.
«Este código es tuyo» hace que reorganice el código: ~1,5x más tokens y cambios que nadie pidió. Úsalo solo cuando quieras eso y revisa el diff. Comprueba: la frase, como aviso.
Trabaja en silencio durante secuencias largas. El texto oficial le pide hablar antes de usar la primera herramienta, con +~20% de tokens. Comprueba: si tienes este texto (blocos/avisar-progresso.md). En Claude Code con Fable 5.2, el recordatorio de silencio ya viene activado de fábrica.
Si el prompt le ordena delegar, delega mucho. Revisa primero esas líneas. Comprueba: «usa siempre subagentes», «agent army», «delega todo».
Las notas y las memorias acumulan «nunca» y obedece todas las órdenes. Borra las que ya no tengan motivo; añade alcance y motivo a las demás; enumera lo que NO necesita aprobación. Comprueba: «nunca» sin motivo, «nunca vuelvas a intentarlo», órdenes absolutas en mayúsculas, memorias antiguas.
Elimina: el presupuesto de tokens en el prompt, «piensa menos», «trata la respuesta anterior como definitiva» (deja de señalar sus propios errores) y las reglas de estilo rígidas. Comprueba: las cuatro.
Pídele que escriba para alguien que no haya visto el trabajo: primero lo principal, sin términos inventados. Comprueba: si tienes este texto (blocos/relatorio-claro.md).
Pedir que escriba su razonamiento en la respuesta puede activar el filtro reasoning_extraction y detener la skill. Comprueba: «muestra tu razonamiento paso a paso», «chain of thought» — gravedad alta.
Sin contar las skills y el volumen, estos son los cambios de prompt que más alteran el resultado, de mayor a menor. Un prompt escrito para el modelo que «interpretaba» empieza a dar un resultado diferente.
Un prompt antiguo con «explica paso a paso cómo pensaste» puede devolver una negativa (refusal) en vez de una respuesta. Es el único punto que puede romper la producción. Cambio: quita la frase; para ver el razonamiento, usa el resumen del pensamiento de la API.
El valor predeterminado es high, que cuesta más. «Responde directamente, sin pensar mucho» no reduce el esfuerzo. Cambio: elige el nivel según la tarea (low para lo simple, medium para el día a día, high para una tarea larga) y mide. No copies el ajuste del modelo anterior.
Ocurre más con low y medium. En una automatización, deja la tarea a medias sin mostrar ningún error. Cambio: pega el texto de «termina el trabajo»: resolver por su cuenta los obstáculos comunes, detenerse solo ante un bloqueo real y decir qué falta.
Años de «nunca hagas X» y «pide siempre aprobación»: obedece todo y se vuelve tímido. Cambio: indica el motivo y el alcance de cada regla y escribe qué no necesita aprobación.
Reparte el trabajo entre varios agentes. Cambio: «cuando la tarea sea independiente y pueda ejecutarse en paralelo».
«Sí, ejecuta la migración en la base de prueba» funciona mejor que «puedes seguir».
Combina código repetido y modifica lo que no pediste, con ~50% más tokens. Úsalo cuando quieras reestructurar y revisa el diff.
Para seguir el proceso, pide: «antes de empezar, di en una línea qué vas a hacer».
«Escribe para quien no siguió el proceso; empieza por lo principal».
No. Los cambios anteriores siguen las buenas prácticas de Anthropic para los modelos Claude en general: indicar el motivo de cada regla, expresar claramente la acción y pedir que termine el trabajo también ayudan a Opus. Adivina mejor la intención, así que la mejora es menor. El esfuerzo se ajusta por modelo en settings.json (modelSettings), así que subir el Fable 5.2 no afecta a Opus. El único efecto es que el texto de «termina el trabajo» puede hacer que Opus trabaje y gaste un poco más en una tarea larga. Las reglas de seguridad (API, crédito, borrar, publicar) se mantienen igual en ambos.
Sin instalar paquetes, sin internet, sin clave de API. Funciona en Linux, macOS y WSL.
Solo la biblioteca estándar.
python3 --versionEl auditor funciona sin él; para aplicar las correcciones, usas tu Claude.
claude --versionEs el orden que recomienda Anthropic: primero el esfuerzo, después limpiar las instrucciones y luego medir.
Una carpeta, un archivo principal.
git clone https://github.com/inematds/audite-seu-claude.git ~/audite-seu-claude
El comando /effort de Claude Code cambia el nivel de esfuerzo (cuánto piensa el modelo). Úsalo antes de una tarea grande. En los bots con claude -p, pasa --effort high.
/effort high
Desde la carpeta del proyecto. --home también lee tu ~/.claude (CLAUDE.md global, skills, memorias, plugins).
cd ~/meu-projeto
python3 ~/audite-seu-claude/varrer.py . --home --html relatorio.html --saida-json relatorio.json
# en el terminal: total de hallazgos, por punto y por gravedad
Cada sugerencia tiene un ID (A001, A002…). Filtra por capa — Fable 5.2 (las líneas que cambian el comportamiento del modelo) o volumen (peso del contexto, skills repetidas o sin uso, memorias antiguas) — o por gravedad. Haz clic en generar correcoes.md: el navegador descarga el archivo y muestra el texto en pantalla. Mueve el archivo a la carpeta del proyecto. También puedes generarlo directamente ahí desde el terminal, con los ID:
python3 ~/audite-seu-claude/varrer.py --correcoes A001,A004,A007 --de relatorio.json --saida correcoes.md
Con correcoes.md en la carpeta del proyecto (también sirve la ruta: «aplica el ~/Downloads/correcoes.md»). El encabezado del archivo ya indica cómo hacerlo: un elemento cada vez, copia del original en .audite-backup/, las reglas protegidas nunca se borran y los archivos de plugins no se editan. La aprobación solo cubre esas ediciones.
# en Claude Code, dentro de la carpeta del proyecto
aplica el correcoes.md
Los hallazgos aplicados desaparecen. Luego ejecuta tu tarea más larga y observa dónde se detiene, se queda en silencio o delega demasiado. Para cada síntoma, pega el bloque adecuado de blocos/, uno cada vez.
python3 ~/audite-seu-claude/varrer.py . --home
cat ~/audite-seu-claude/blocos/terminar-tarefa.md # si se detiene a mitad
Ejecuta también el auditor oficial de Claude Code (versión 2.1.283 o posterior). Detecta lo que este kit no busca: archivos o comandos mencionados que ya no existen y reglas que se contradicen entre archivos. Este kit cubre lo que el auditor no lee: memorias, textos de plugins, prompts dentro de scripts y bots, el nivel de esfuerzo en settings.json y el peso de las skills. Usa ambos.
# en Claude Code
/doctor prompt-audit
La skill realiza los pasos 3 a 6 mediante Claude Code. --uso 30 lee los registros de tus sesiones (~/.claude/projects/*.jsonl, locales) y marca las skills que no hayas usado en 30 días. --estrito hace fallar el CI si hay algún hallazgo de gravedad alta.
cp -r ~/audite-seu-claude/skill/audite-seu-claude ~/.claude/skills/
python3 ~/audite-seu-claude/varrer.py . --home --uso 30
python3 ~/audite-seu-claude/varrer.py . --estrito  # sale con 1 si hay algo de gravedad "alta"
Generado a partir de tests/fixtures/sujo, un proyecto creado deliberadamente con una línea de cada tipo (24 hallazgos). Abre el informe interactivo (en portugués) y prueba el botón para generar correcoes.md.
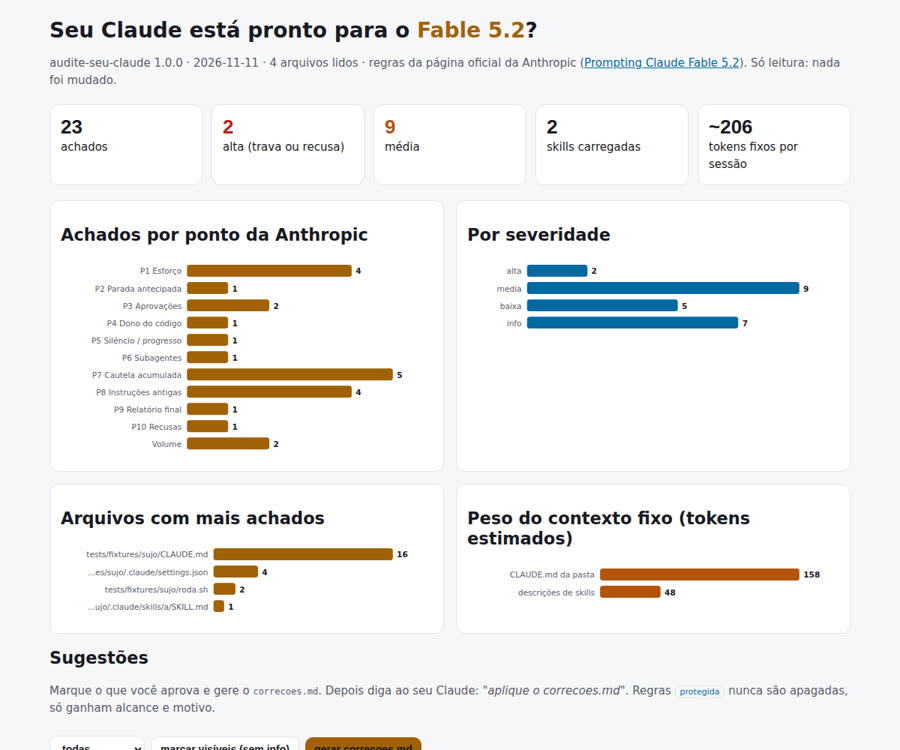
En una máquina de producción con 148 skills cargadas, la primera auditoría tardó 4 segundos y encontró: un hook de plugin que ordena escribir «telegráfico, en fragmentos» (punto 8), una skill de plugin con «si hay un 1% de probabilidad, estás obligado» (punto 7), nueve órdenes de delegar siempre (punto 6) y Fable 5.2 configurado en medium (punto 1).
La propia Anthropic dice que no es necesario eliminar todas las instrucciones antiguas. Prueba cada cambio en una tarea real.
~/.claude/skills, con un INDICE.md (nombre, para qué sirve, palabras de búsqueda). Una línea en el CLAUDE.md global le indica a Claude que busque allí cuando pidas una skill que no está cargada. Antes, comprueba si otra skill, script o timer la invoca. En la máquina del autor: 148 → 107 skills cargadas y de 13,7 mil → 9,6 mil tokens de descripción por sesión. Paso a paso: blocos/biblioteca-skills.md.terminar-tarefa.md ni avisar-progresso.md: sirven para quienes llaman al modelo mediante la API o con un programa propio.