Shorts 9:16 · todo local
Un guion se convierte en un short narrado en 30 segundos
Tú escribes los diálogos y eliges los cards. cardshorts graba la voz, la verifica, genera las imágenes y arma el video con subtítulos.
Tú escribes los diálogos y eliges los cards. cardshorts graba la voz, la verifica, genera las imágenes y arma el video con subtítulos.
cardshorts es una herramienta de línea de comandos que crea videos cortos verticales (Reels, Shorts, TikTok) a partir de un archivo de texto. Cada escena tiene un diálogo y una pantalla lista (un "card"). La herramienta graba la narración con una voz clonada, verifica que la voz haya dicho bien el texto, genera las imágenes y entrega el MP4 con subtítulos palabra por palabra, en 30 segundos como máximo. Es para quien quiere publicar videos provocadores con frecuencia sin editar a mano. Corre en tu computadora, con tarjeta de video y los proyectos de voz e imagen de INEMA instalados.
Nació de una serie de shorts sobre IA en Brasil. Lo que funcionó se volvió molde: cinco estilos de pantalla, reglas de voz y de contenido y un comando que hace el resto.
El roteiro.yaml lista las escenas: diálogo + molde de card + textos. Un comando entrega el MP4 1080×1920.
Cada diálogo se transcribe después de grabarse. Si la voz se equivocó en una palabra, lo graba de nuevo (hasta 3 veces) y corta el balbuceo del final.
Acelera el habla hasta 1,2× para que quepa en el tiempo máximo. Si no cabe, se detiene y avisa cuánto recortar.
Cada etapa usa una herramienta local. La voz y las imágenes quedan en caché: si cambias un texto, solo ese diálogo se graba de nuevo.
Las rutas se pueden cambiar con variables CS_* o con un config.yaml en la raíz del proyecto.
inemavox con tts_direct.py (Chatterbox) y transcrever_v1.py (Whisper large-v3), y un audio de referencia de la voz.
export CS_INEMAVOX=~/projetos/inemavox
export CS_VOZES=~/minhas-vozes   # nei.wav, etc.
Servidor con POST /generate (inemaimg con FLUX.2 klein).
export CS_IMAGEM_API=http://localhost:8000/generate
ffmpeg con libass, Chrome headless de Playwright y Python 3 con PyYAML.
npx playwright install chromium-headless-shell
pip install pyyaml
Empieza por la vista previa, que es rápida. Graba la voz solo cuando los cards estén bien.
Lista los 5 estilos, los moldes de cada uno y los campos que pide cada molde.
git clone https://github.com/inematds/cardshorts && cd cardshorts
./cardshorts.py estilos
Copia el guion de ejemplo del estilo elegido.
./cardshorts.py novo meus/ia-trabalho --estilo versus
Un diálogo por escena, escrito como se habla: números en letras, "inema ponto club". En 30 segundos caben unas 70 palabras.
estilo: versus
max_seg: 30
musica: true
voz: {ref: nei}
imagens:
  dupla: {prompt: "two modern faceless humanoid robots...", w: 1088, h: 640}
cenas:
  - fala: "De um lado, quem trabalha. Do outro, os humanoides."
    molde: capa-dupla
    campos: {foto_cima: "img:equipe", foto_baixo: "img:dupla", faixa: "VOCÊ × ELES", ...}
Genera las imágenes y los cards y lo junta todo en previa.png. Verifica que ningún texto se salga del card y que la franja de subtítulos (parte inferior) no tape el título.
./cardshorts.py cards meus/ia-trabalho/roteiro.yaml # → previa.png
Graba la voz (unos 2 minutos por diálogo la primera vez), verifica cada diálogo, ajusta la velocidad y arma el video. El log muestra los subtítulos finales para revisarlos.
./cardshorts.py montar meus/ia-trabalho/roteiro.yaml
# narración 31.4s → velocidad 1.13x
# listo: meus/ia-trabalho/ia-trabalho.mp4 (28.6s)
¿Cambiaste un diálogo? Solo ese se graba de nuevo. ¿Palabra equivocada en los subtítulos? Corrígela en el guion, sin volver a grabar.
correcoes: {garanda: garanta}
./cardshorts.py musica musicas/calma.mp3 "calm lofi piano, instrumental"  # otra música
La carpeta skill/ es una skill para Claude Code y Codex: elige estilos distintos para cada versión y sigue las reglas de contenido.
ln -s $PWD/skill ~/.claude/skills/cardshorts
# en Claude Code: "/cardshorts haz 3 versiones distintas sobre ..."
Para hacer tres versiones de un tema, usa tres estilos. El mismo molde con otro texto queda demasiado parecido.
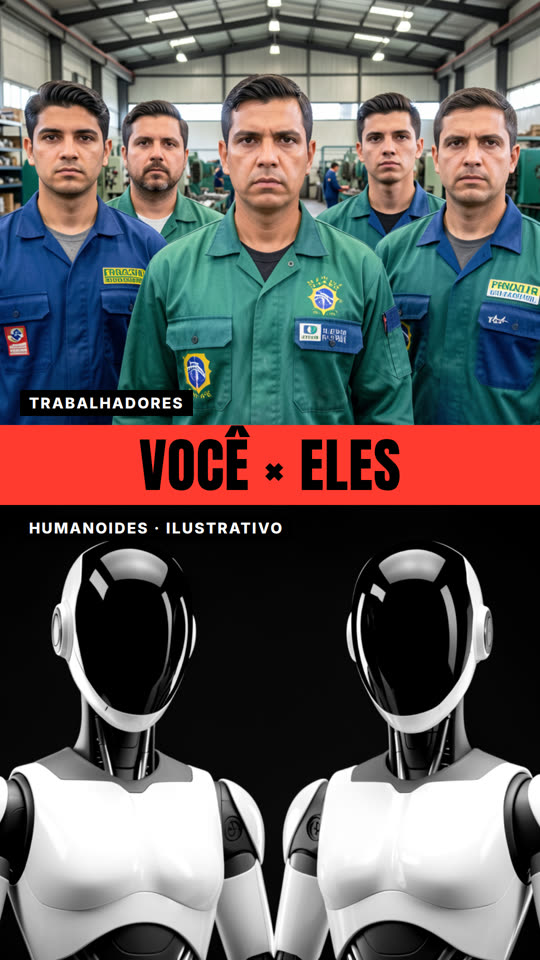
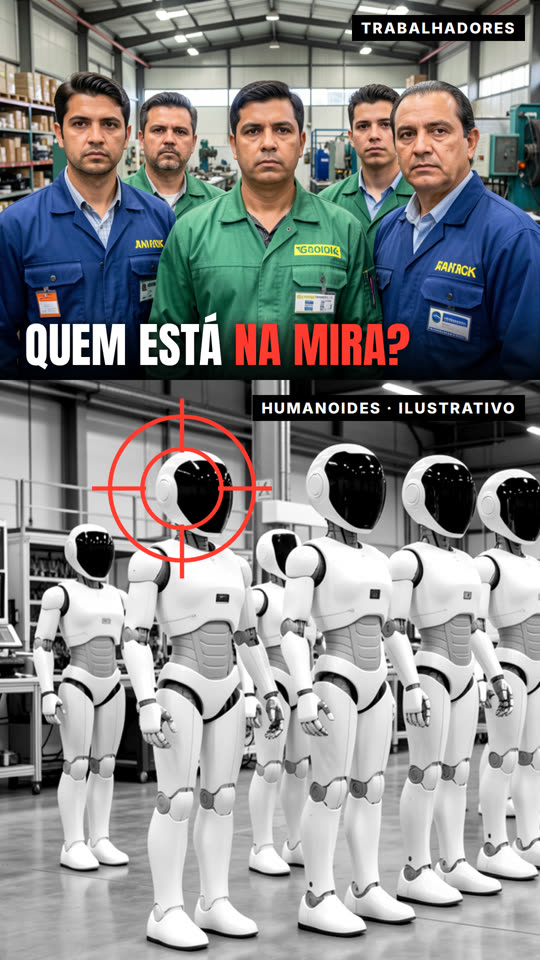
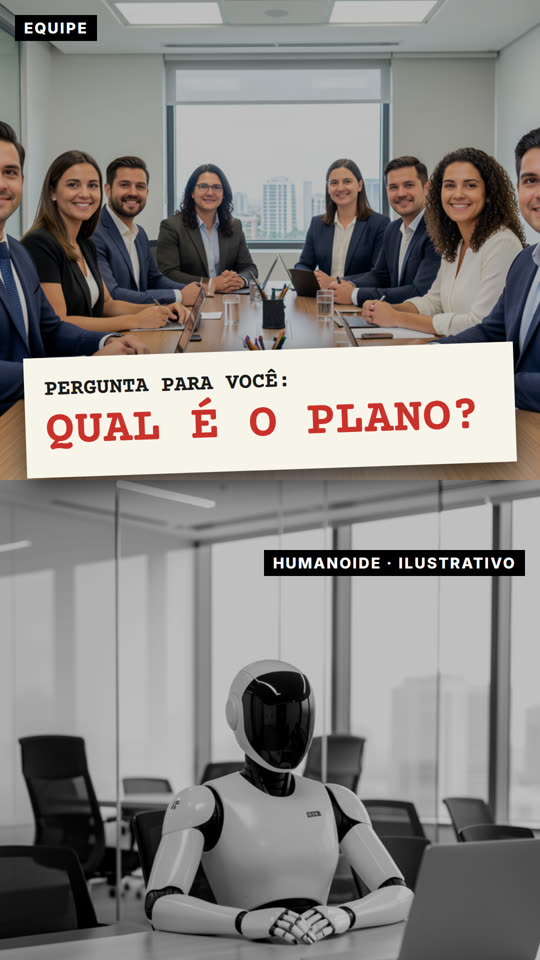
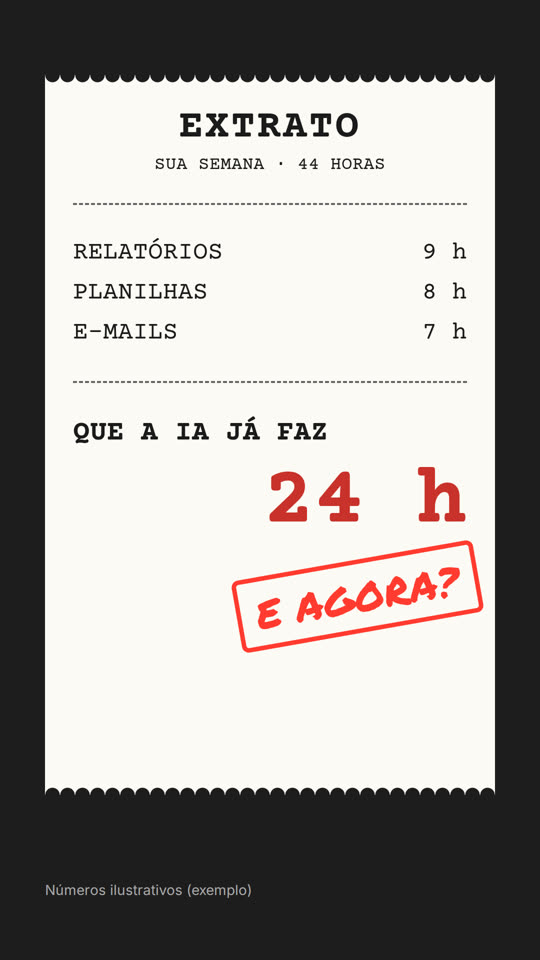
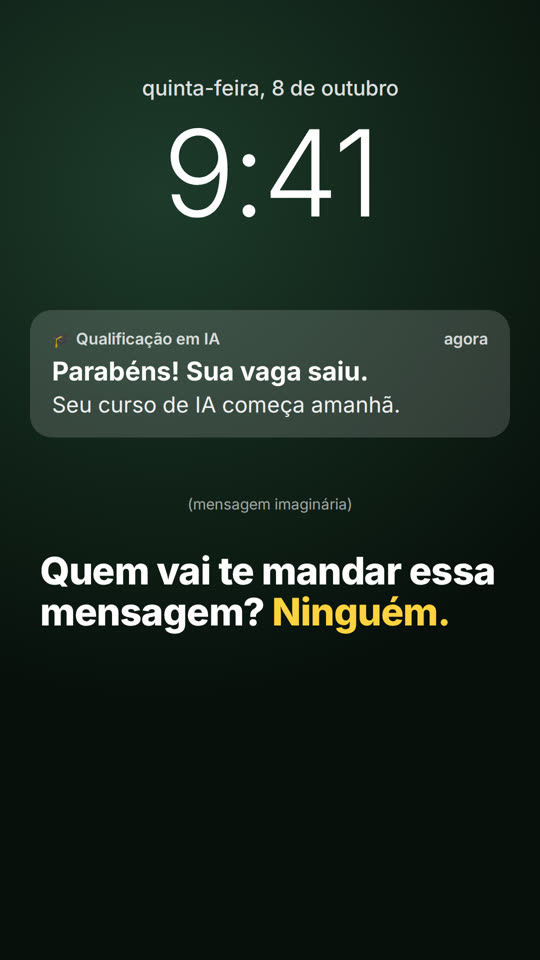
exemplos/versusCuatro escenas, voz clonada, música tensa generada localmente y subtítulos palabra por palabra. Salió de este comando, sin edición manual:
./cardshorts.py montar exemplos/versus/roteiro.yaml
| El comando garantiza | Cómo |
|---|---|
| Habla fiel al texto | Transcripción local; por debajo de 85% de similitud, graba de nuevo |
| Sin ruido al final | Corta 0,35 s después de la última palabra escuchada |
| Hasta 30 s | Velocidad entre 1,0× y 1,2×; por encima de eso, pide recortar |
| Música sin tapar la voz | La música baja sola cuando entra la voz |
La versión actual cubre los cards estáticos. Próximos pasos:
video: en la escena).