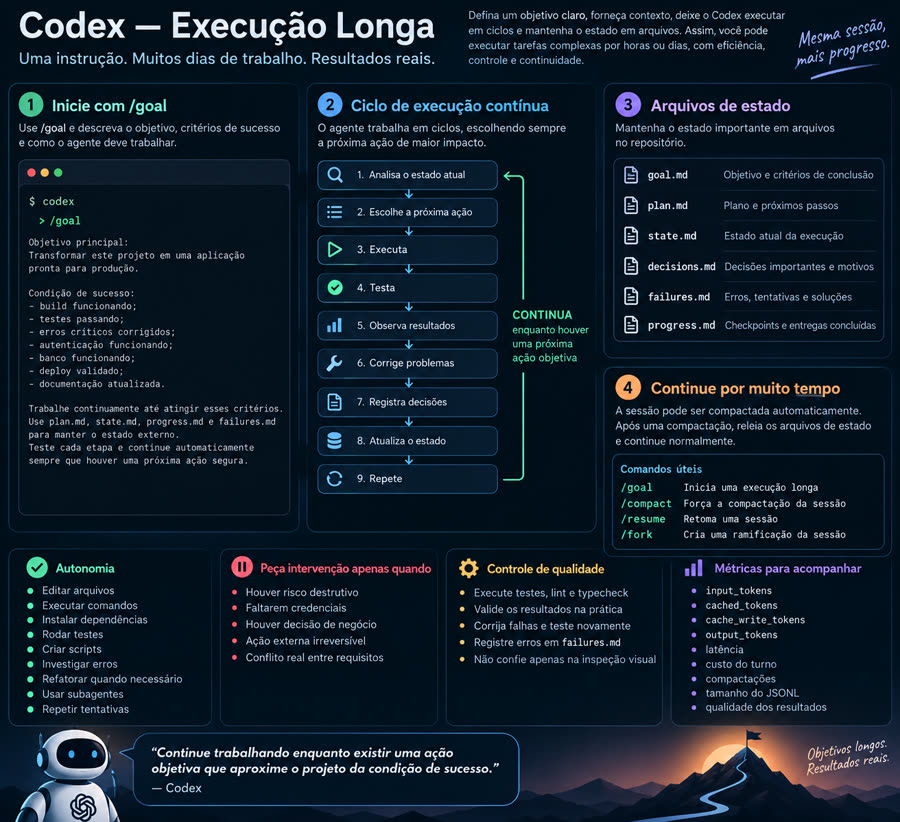
Não é mandar o agente "trabalhar 10 horas". É dar um objetivo com condição de pronto verificável, guardar o estado em arquivos e pôr tetos. Ele trabalha em ciclos até concluir.

Este repositório junta o material de origem sobre a sessão longa no Codex, uma pesquisa das novidades de jul–out/2026 com fontes, um plano de uso e templates prontos para copiar.
O /goal precisa de Resultado, Restrições e Verificação: comandos cuja saída prova que terminou. Nada de "até ficar bom".
goal, plan, state, progress, failures e decisions.md guardam a tarefa; canal.md guarda o que a compactação perde (fatos, glossário, armadilhas). Após compactar ou retomar, o agente relê os arquivos em vez de depender da memória da conversa.
Tempo, tokens e memória com limite. Gasto de crédito, API, produção e ações irreversíveis viram portão humano.
O agente escolhe sempre a próxima ação útil, testa, registra e continua. Três ciclos sem avanço mensurável = parar e chamar o humano.
Continuidade lógica do trabalho: o mesmo objetivo, o mesmo histórico.
Resume o histórico antigo para caber na janela. Muda o prefixo e baixa o cache logo depois — é esperado.
Reaproveita o prefixo idêntico. Em sessões contínuas o acerto passa de 95%. Meça cached ÷ input.
Um agente de código com modo de objetivo e um projeto com algum teste automático para servir de oráculo.
O /goal vive dentro do TUI (não aparece no --help).
# versão recente codex --version
Também tem /goal, além de /loop, background agents e workflows.
claude --versionClone este repositório para copiar os arquivos de estado e os prompts.
git clone https://github.com/inematds/execucao-longa
Use os templates de templates/. Cada execução ganha a própria pasta dentro do projeto.
Uma pasta por execução, com os sete arquivos (os seis de estado + canal.md).
execucao-longa/tools/novo-longrun.sh . meu-objetivo # cria a pasta com os sete arquivos e data no goal.md # ou à mão: mkdir -p longrun/2026-10-01-meu-objetivo cp execucao-longa/templates/{goal,plan,state,progress,failures,decisions,canal}.md \ longrun/2026-10-01-meu-objetivo/
Cada critério é um comando e a saída esperada. Liste também os portões humanos.
## Critérios de pronto (verificáveis) - [ ] npm test → 0 falhas - [ ] npm run build → sai com código 0 ## Portões humanos (parar e perguntar) - gasto de crédito / API paga / deploy em produção
No Codex, cole templates/prompt-goal-codex.md preenchido. Se o objetivo ainda está vago, rode /plan antes.
codex /goal RESULTADO: ... VERIFICAÇÃO: ... ESTADO: longrun/2026-10-01-meu-objetivo/ # no Claude Code: a condição precisa aparecer na saída /goal a saída do npm test mostra 0 falhas e state.md diz "concluído"
Veja o progresso, pause e retome. Use fork para caminhos alternativos.
/goals # lista goals e status /goal pause # /goal resume para continuar /side # pergunta de status sem parar o trabalho /fork # ramifica a sessão
Cada ciclo é um codex exec com stdin fechado, timeout, teto de memória e flock. Quem decide continuar é o teste: o loop reverte mexida em teste protegido, faz commit de checkpoint e para por estagnação.
# loop.env + prompt.md na pasta (copie de longrun/2026-10-01-medir-sessao/) execucao-longa/tools/loop-longrun.sh longrun/2026-10-01-meu-objetivo # para sozinho: CONCLUÍDO, 3 ciclos sem avanço ou teto de ciclos
Confira você mesmo (rode o teste final, veja o hash dos testes) e registre no progress.md o que medir-sessao.py mostra: duração, compactações, tokens, cache e saída de ferramenta.
python3 execucao-longa/tools/medir-sessao.py <sessão.jsonl> # resumo: duração, compactações, cache python3 execucao-longa/tools/medir-sessao.py <sessão.jsonl> --json --por-turno # curva por turno
Instale uma vez por máquina. Depois, cada objetivo longo segue um de dois caminhos: interativo (você acompanha) ou headless (roda sozinho).
~/projetos/execucao-longa.templates/AGENTS-long-run.md no CLAUDE.md e no AGENTS.md globais.~/.claude/settings.json, ligue tools/hook-longrun.sh em PreCompact, SessionStart (matcher compact|resume), PostToolUse e UserPromptSubmit: ele lembra de salvar antes de compactar, manda reler depois e avisa as faixas de contexto (50/70/85%). Ponha "cleanupPeriodDays": 365 para o Claude não apagar as transcrições com 30 dias.tools/systemd/longrun-vigia.* para ~/.config/systemd/user/ e rode systemctl --user enable --now longrun-vigia.timer.flock -n + timeout.tools/novo-longrun.sh <projeto> <slug>goal.md com critérios nível 3./goal no Codex ou no Claude Code com o prompt de templates/.medir-sessao.py e anote no progress.md.tools/novo-longrun.sh <projeto> <slug>goal.md + testes congelados (o teste é o juiz).prompt.md + loop.env — copie do exemplo longrun/2026-10-01-medir-sessao/.tools/loop-longrun.sh <pasta> (num tmux ou em segundo plano).Para achar algo dito em qualquer sessão (Codex ou Claude): recall "termo" --projeto X --desde AAAA-MM-DD. Alertas do vigia ficam em ~/.local/state/execucao-longa/alertas.log (e no notify-send). tools/arquivar-sessoes.py mostra quanto espaço as sessões antigas ocupam; com --aplicar comprime e com --restaurar devolve. Exemplo completo de execução: longrun/2026-10-01-medir-sessao/.
Bom critério: alguém de fora consegue checar sem confiar no agente, e o agente não consegue cumprir por atalho. Em execução longa, o mínimo é o nível 3.
"Deixar o site bom". Ninguém sabe quando acabou.
"Código revisado e limpo". O agente se autoaprova.
"0 falhas", "20 páginas". Dá para apagar teste ou gerar página vazia.
Comando + trava: "0 falhas e ≥ 48 testes e tests/ intocado". Mínimo aceito.
Nível 3 + checagem externa: e2e real, avaliador separado, amostra humana. Quando o erro custa caro.
comando → saída esperada)?/goal no Claude só lê a conversa.❌ Nível 0: a frase em si. ⚠️ Nível 2: "existe guia/en/index.html". ✅ Nível 3–4: mesmas <section id> que o PT, nenhum trecho em PT, links internos respondem 200, captura de tela conferida.
Sinais de critério ruim: "bom", "limpo", "completo"; depende do agente dizer que terminou; só contagem; não diz o que não pode mudar; verificação que leva horas. O templates/goal.md já traz a escala.
O /goal funciona, mas sessões com muitas compactações perdem o fio. Detalhes e fontes em docs/pesquisa-goal-contexto-fila-2026-10.md.
Não é o /goal, é a compactação repetida. O objetivo sobrevive, mas se perde o "o que já está feito / o que falta": o agente repete "vou terminar e commitar", reabre trabalho e não converge (issue openai/codex #34095).
Faixas de contexto, antes do automático (~90–95%): ~50% → anotar no canal.md fatos, aprendizados e armadilhas; ~70% → atualizar o estado e rodar /compact; ~85% ou 3ª compactação → /session-handoff, sessão nova e /prime. No Claude Code um hook mede a % e avisa o agente uma vez por faixa. Um goal por feature.
Se o orquestrador dorme entre ciclos, acorde antes do cache expirar: OpenAI 30 min (acordar a cada ~25), Claude 1 h (~55). Perder o cache custa 12,5x a 25x. Acordar só para manter o cache vale se houver trabalho nas próximas horas.
Backlog que cresce: o orquestrador pega a próxima tarefa, despacha numa sessão curta, confere e fecha. Para quando não há tarefa aberta (padrão do Symphony, da OpenAI, sobre o Linear). Comece com fila local em arquivos.
O claude-mem funciona e serve para lembrar o que já foi feito num projeto, mas só cobre o Claude Code e guarda resumos, não o que foi dito. Para buscar palavra por palavra em tudo (Codex e Claude), use recall "termo" (índice SQLite FTS5, F8). A faxina com backup (F9) zerou a fila antiga e fechou as sessões presas. Análise em docs/pesquisa-memoria-claude-mem-2026-10.md.
longrun/<execução>/tasks/, com status e campo evidencia:.proposta e esperam aprovação.progress.md e parar. Linear/GitHub Issues só com autorização para a API.Resumo da pesquisa com fontes em docs/pesquisa-web-2026-10.md.
/goal, /compact, /resume e /fork existem no Codex (docs oficiais). Goals retomam após limite de uso (20/07) e após reinício do daemon (17/09). O Claude Code tem /goal desde mai/2026, com avaliador após cada turno.
GPT-6 Astra (03/09) mantém notas entre janelas de contexto. Claude Opus 5.5 (22/09) tem 1M de contexto e leitura de cache a US$0,20/MTok.
A sessão de 11 dias / 573 turnos / 1,3 GB não tem fonte pública. É plausível: há relatos de logs de sessão de 0,7 a 2 GB.
Os arquivos de estado são uma divisão da mesma ideia do PLANS.md (OpenAI) e do PROGRESS.md + git (Anthropic).
O infográfico e a capa que originaram o projeto, guardados em docs/origem/ junto com os quatro textos.


Detalhes em docs/PLANO-EXECUCAO-LONGA.md.
recall "termo": índice SQLite FTS5 de tudo o que foi dito com o Codex e o Claude (sem saída de ferramenta), reindexado de hora em hora. Feito por execução longa em 1 ciclo; 90 mil trechos, busca em 0,02–0,04 s.