No se trata de pedirle al agente que "trabaje 10 horas". Se trata de darle un objetivo con una condición de terminado verificable, guardar el estado en archivos y poner límites. Trabaja en ciclos hasta concluir.

El proyecto explicado en pocos minutos.
Este repositorio reúne el material de origen sobre la sesión larga en Codex, una investigación de las novedades de jul–oct/2026 con fuentes, un plan de uso y plantillas listas para copiar.
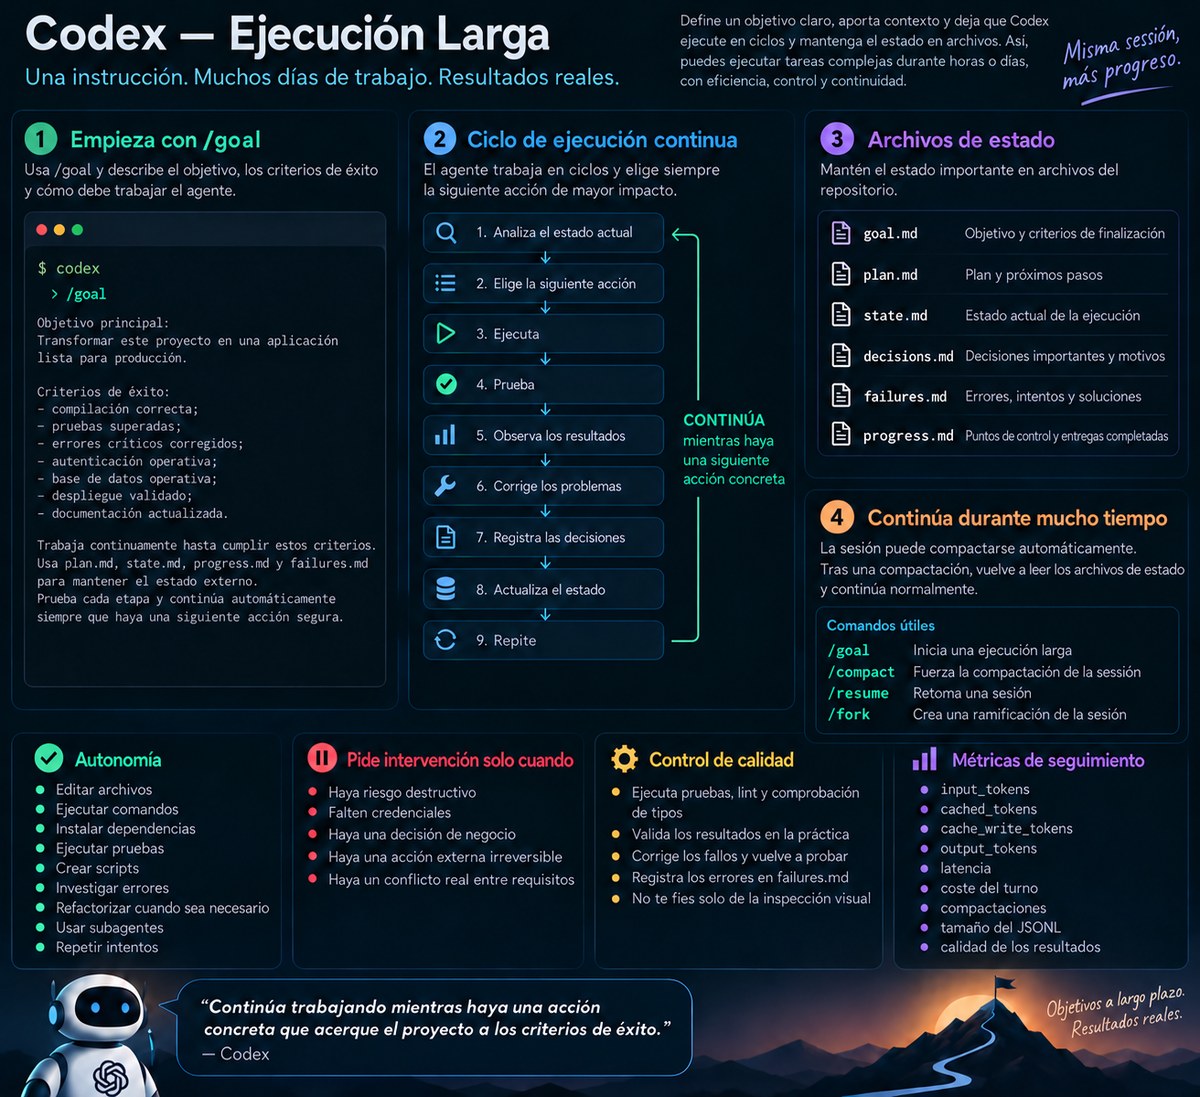
El /goal necesita Resultado, Restricciones y Verificación: comandos cuya salida prueba que terminó. Nada de "hasta que quede bien".
goal, plan, state, progress, failures y decisions.md guardan la tarea; canal.md guarda lo que la compactación pierde (hechos, glosario, trampas). Tras compactar o reanudar, el agente vuelve a leer los archivos en lugar de depender de la memoria de la conversación.
Tiempo, tokens y memoria con límite. Gasto de créditos, API, producción y acciones irreversibles se convierten en compuerta humana.
El agente elige siempre la siguiente acción útil, prueba, registra y continúa. Tres ciclos sin avance medible = detenerse y llamar al humano.
Continuidad lógica del trabajo: el mismo objetivo, el mismo historial.
Resume el historial antiguo para que quepa en la ventana. Cambia el prefijo y baja el caché justo después — es lo esperado.
Reutiliza el prefijo idéntico. En sesiones continuas el acierto supera el 95%. Mida cached ÷ input.
Cuando el contexto se llena o la sesión ya se compactó, no insistas en la misma conversación. Guarda el estado en un archivo, limpia y vuelve a empezar leyendo ese archivo. Es el proceso que recomendamos para cualquier trabajo largo, en Claude Code y en Codex.
Escribe lo que se hizo, lo que está en curso, la próxima acción exacta y lo que depende del humano, sin secretos. Guarda un archivo nuevo en handoffs/history/<fecha-UTC>.md (nunca sobrescribe) y actualiza handoffs/latest.md.
Empieza de cero: contexto vacío, sin el peso de las compactaciones. No se pierde nada, porque el estado está en el archivo. En Codex, abre una sesión nueva.
Antes de actuar, lee AGENTS.md/CLAUDE.md, context/, tasks/current.md y handoffs/latest.md y devuelve un resumen corto: objetivo, regla principal con fuente, última decisión, próxima acción y conflictos. Solo lee: nunca retoma publicación, deploy ni envíos por su cuenta.
Con tools/hook-longrun.sh activado, el agente guarda el handoff solo al ~70% y al ~85% del contexto y justo después de una compactación, mientras la caché sigue caliente (sale barato). El % se mide sobre el punto en que Claude Code compacta por tamaño (~967 mil tokens en los modelos de 1M). Parado ~55 min con más de ~200 mil, el propio Claude Code compacta por inactividad. El hook comprueba que el archivo se grabó y vuelve a pedirlo si no; en la 3.ª compactación pide sesión nueva; y si vuelves tras más de 1 h parado con contexto grande, retiene tu primer mensaje y avisa que la caché venció: reenviar continúa, /clear empieza limpio y la sesión nueva señala el último handoff. Tú solo haces /clear y /prime. Instalación en Cómo usarlo todo.
¿Volviste a una sesión detenida hace más de 1 h con más de 150 mil tokens? El hook retiene el primer mensaje una vez. El caché dura ~1 h; después el mensaje relee toda la conversación sin caché y gasta mucho del límite. Ejemplo real (el aviso del hook está en portugués):
● UserPromptSubmit operation blocked by hook:
Sessão parada há 5h33: o cache venceu e esta mensagem vai reprocessar ~220 mil tokens do seu limite. Para continuar aqui, reenvie a mensagem. Para começar limpo: /clear e depois /prime (o último handoff do projeto é indicado na abertura).
Original prompt: ficou muito ruim, a movimentação da apresentação...
Seguir aquí: reenvía el mismo mensaje (pasa directo). Empezar liviano (recomendado): /clear + /prime y repite el pedido, ~20 mil tokens en lugar de 220 mil. Cada sesión cuenta aparte: dos sesiones detenidas avisan una vez cada una. Ajuste: LONGRUN_PAUSA_MIN=120 (solo después de 2 h), LONGRUN_PAUSA_TOKENS=300000 (solo contextos mayores), LONGRUN_PAUSA_TOKENS=0 (desactiva).
Versión común (solo chat), la que circula en kits y repositorios de skills: muestra el resumen en la conversación y no guarda nada. Al hacer /clear, el resumen se va con ella, salvo que lo copies a mano, y /prime no encuentra qué leer.
Versión INEMA (guarda en archivo), del kit agente-claude-codex (1.5.2), también en skillmanager3x, con latest.md como índice de abiertos: lo muestra en el chat y lo guarda en handoffs/; crea la carpeta si el proyecto solo tiene CLAUDE.md. Funciona en Claude Code (~/.claude/skills) y en Codex (~/.agents/skills), junto con /prime.
# 0 = versión solo chat; 1 o más = guarda en handoffs/ grep -c "handoffs/history" ~/.claude/skills/session-handoff/SKILL.md # instalar o cambiar por la versión que guarda (vista previa primero, luego --apply) git clone https://github.com/inematds/agente-claude-codex && cd agente-claude-codex scripts/sync-skills.sh install session-handoff --all scripts/sync-skills.sh install session-handoff --all --apply --replace scripts/sync-skills.sh install prime --all --apply --replace
--replace guarda la versión anterior en ~/.claude/skills-backup/ y ~/.agents/skills-backup/. Guía del kit: agente-claude-codex/guia.
Un agente de código con modo de objetivo y un proyecto con alguna prueba automática que sirva de oráculo.
El /goal vive dentro del TUI (no aparece en el --help).
# versión reciente codex --version
También tiene /goal, además de /loop, background agents y workflows.
claude --versionClone este repositorio para copiar los archivos de estado y los prompts.
git clone https://github.com/inematds/execucao-longa
Use las plantillas de templates/. Cada ejecución tiene su propia carpeta dentro del proyecto.
Una carpeta por ejecución, con siete archivos (los seis de estado + canal.md).
execucao-longa/tools/novo-longrun.sh . meu-objetivo # crea la carpeta con los siete archivos y fecha el goal.md # o a mano: mkdir -p longrun/2026-10-01-meu-objetivo cp execucao-longa/templates/{goal,plan,state,progress,failures,decisions,canal}.md \ longrun/2026-10-01-meu-objetivo/
Cada criterio es un comando y la salida esperada. Liste también las compuertas humanas.
## Criterios de terminado (verificables) - [ ] npm test → 0 fallos - [ ] npm run build → sale con código 0 ## Compuertas humanas (detenerse y preguntar) - gasto de créditos / API de pago / deploy en producción
En Codex, pegue templates/prompt-goal-codex.md completado. Si el objetivo todavía es vago, ejecute /plan antes.
codex /goal RESULTADO: ... VERIFICACIÓN: ... ESTADO: longrun/2026-10-01-meu-objetivo/ # en Claude Code: la condición tiene que aparecer en la salida /goal la salida de npm test muestra 0 fallos y state.md dice "concluido"
Vea el progreso, pause y reanude. Use fork para caminos alternativos.
/goals # lista goals y estado /goal pause # /goal resume para continuar /side # pregunta de estado sin detener el trabajo /fork # ramifica la sesión
Cada ciclo es un codex exec con stdin cerrado, timeout, tope de memoria y flock. Quien decide seguir es el test: el loop revierte cambios en tests protegidos, hace commit de checkpoint y se detiene por estancamiento.
# loop.env + prompt.md na pasta (copie de longrun/2026-10-01-medir-sessao/) execucao-longa/tools/loop-longrun.sh longrun/2026-10-01-meu-objetivo # se detiene solo: CONCLUIDO, 3 ciclos sin avance o tope de ciclos
Compruebe usted mismo (corra el test final, mire el hash de los tests) y registre en progress.md lo que muestra medir-sessao.py: duración, compactaciones, tokens, caché y salida de herramientas.
python3 execucao-longa/tools/medir-sessao.py <sessão.jsonl> # resumen: duración, compactaciones, caché python3 execucao-longa/tools/medir-sessao.py <sessão.jsonl> --json --por-turno # curva por turno
Instálelo una vez por máquina. Después, cada objetivo largo sigue uno de dos caminos: interactivo (usted lo acompaña) o headless (corre solo).
~/projetos/execucao-longa.templates/AGENTS-long-run.md en el CLAUDE.md y el AGENTS.md globales.~/.claude/settings.json, conecte tools/hook-longrun.sh a PreCompact, SessionStart (matcher compact|resume), PostToolUse y UserPromptSubmit: recuerda guardar antes de compactar, pide releer después y avisa las franjas de contexto (50/70/85%). Ponga "cleanupPeriodDays": 365 para que Claude no borre las transcripciones a los 30 días.tools/systemd/longrun-vigia.* a ~/.config/systemd/user/ y corra systemctl --user enable --now longrun-vigia.timer.flock -n + timeout.tools/novo-longrun.sh <proyecto> <slug>goal.md con criterios nivel 3./goal en Codex o Claude Code con el prompt de templates/.medir-sessao.py y anótelo en progress.md.tools/novo-longrun.sh <proyecto> <slug>goal.md + tests congelados (el test es el juez).prompt.md + loop.env — copie del ejemplo longrun/2026-10-01-medir-sessao/.tools/loop-longrun.sh <carpeta> (en tmux o en segundo plano).Para encontrar algo dicho en cualquier sesión (Codex o Claude): recall "término" --projeto X --desde AAAA-MM-DD. Las alertas del vigía quedan en ~/.local/state/execucao-longa/alertas.log (y en notify-send). tools/arquivar-sessoes.py muestra cuánto espacio ocupan las sesiones antiguas; --aplicar las comprime y --restaurar devuelve una. Ejemplo completo de ejecución: longrun/2026-10-01-medir-sessao/.
Un buen criterio lo puede comprobar alguien de fuera sin confiar en el agente, y el agente no puede cumplirlo con un atajo. En ejecuciones largas, el mínimo es el nivel 3.
"Dejar el sitio bien". Nadie sabe cuándo terminó.
"Código revisado y limpio". El agente se autoaprueba.
"0 fallos", "20 páginas". Puede borrar tests o generar páginas vacías.
Comando + candado: "0 fallos y ≥ 48 tests y tests/ intacto". Mínimo aceptado.
Nivel 3 + verificación externa: e2e real, evaluador separado, muestra humana. Cuando el error cuesta caro.
comando → salida esperada)?/goal en Claude solo lee la conversación.❌ Nivel 0: la frase en sí. ⚠️ Nivel 2: "existe guia/en/index.html". ✅ Nivel 3–4: mismas <section id> que el PT, nada en portugués, enlaces internos responden 200, captura de pantalla revisada.
Señales de criterio malo: "bueno", "limpio", "completo"; depende de que el agente diga que terminó; solo conteo; no dice qué no puede cambiar; verificación que tarda horas. El templates/goal.md ya trae la escala.
El /goal funciona, pero las sesiones con muchas compactaciones pierden el hilo. Detalles y fuentes en docs/pesquisa-goal-contexto-fila-2026-10.md (en portugués).
No es el /goal, es la compactación repetida. El objetivo sobrevive, pero se pierde "qué está hecho / qué falta": el agente repite "voy a terminar y hacer commit", reabre trabajo y no converge (issue openai/codex #34095).
Franjas de contexto, antes de la automática (~90–95%): ~50% → anotar en canal.md hechos, aprendizajes y trampas; ~70% → actualizar el estado y correr /compact; ~85% o 3.ª compactación → /session-handoff, sesión nueva y /prime. En Claude Code un hook mide el % y avisa al agente una vez por franja. Un goal por funcionalidad.
Si el orquestador duerme entre ciclos, despiértalo antes de que expire la caché: OpenAI 30 min (cada ~25), Claude 1 h (~55). Perder la caché cuesta de 12,5x a 25x. Despertar solo para mantener la caché compensa si hay trabajo en las próximas horas.
Un backlog que crece: el orquestador toma la siguiente tarea, la despacha en una sesión corta, la verifica y la cierra. Se detiene cuando no hay tareas abiertas (patrón Symphony de OpenAI, sobre Linear). Empieza con una cola local en archivos.
claude-mem funciona y sirve para recordar lo que ya se hizo en un proyecto, pero solo cubre Claude Code y guarda resúmenes, no lo que se dijo. Para buscar palabra por palabra en todo (Codex y Claude), use recall "término" (índice SQLite FTS5, F8). La limpieza con respaldo (F9) vació la cola antigua y cerró las sesiones trabadas. Análisis en docs/pesquisa-memoria-claude-mem-2026-10.md (en portugués).
longrun/<ejecución>/tasks/, con estado y campo evidencia:.proposta y esperan aprobación.progress.md y parar. Linear/GitHub Issues solo con autorización para usar la API.Resumen de la investigación con fuentes en docs/pesquisa-web-2026-10.md (en portugués).
/goal, /compact, /resume y /fork existen en Codex (docs oficiales). Los goals se reanudan tras el límite de uso (20/07) y tras el reinicio del daemon (17/09). Claude Code tiene /goal desde may/2026, con evaluador después de cada turno.
GPT-6 Astra (03/09) mantiene notas entre ventanas de contexto. Claude Opus 5.5 (22/09) tiene 1M de contexto y lectura de caché a US$0,20/MTok.
La sesión de 11 días / 573 turnos / 1,3 GB no tiene fuente pública. Es plausible: hay reportes de logs de sesión de 0,7 a 2 GB.
Los archivos de estado son una división de la misma idea del PLANS.md (OpenAI) y del PROGRESS.md + git (Anthropic).
La infografía y la portada que originaron el proyecto, guardadas en docs/origem/ junto con los cuatro textos.


Detalles en docs/PLANO-EXECUCAO-LONGA.md (en portugués).
recall "término": índice SQLite FTS5 de todo lo dicho con Codex y Claude (sin salida de herramientas), reindexado cada hora. Hecho por una ejecución larga en 1 ciclo; 90 mil fragmentos, búsqueda en 0,02–0,04 s.Las skills session-handoff y prime que este hook activa: graban y retoman el handoff.
Núcleo portátil y handoff entre sesiones y agentes.
Statusline, checkpoints y handoff antes del /clear.
Loops que se mejoran a sí mismos con evidencia y rollback.