 CURSO INEMA.CLUB · v2
Fable Lite — Desentrañando el razonamiento de los modelos
Cómo destilar tus logs de Claude Code, medir cómo trabaja cada modelo, y convertir la diferencia en un playbook que hace que Opus actúe más como Fable 5.
La técnica, en una frase
Los logs de Claude Code están en ~/.claude/projects/*.jsonl.
Cada línea es un evento; el campo message.model dice
qué modelo escribió cada turno. Eso es suficiente para separar el trabajo de Fable 5 del trabajo de Opus 4.8 —
y medir el ritmo de cada uno con números reales.
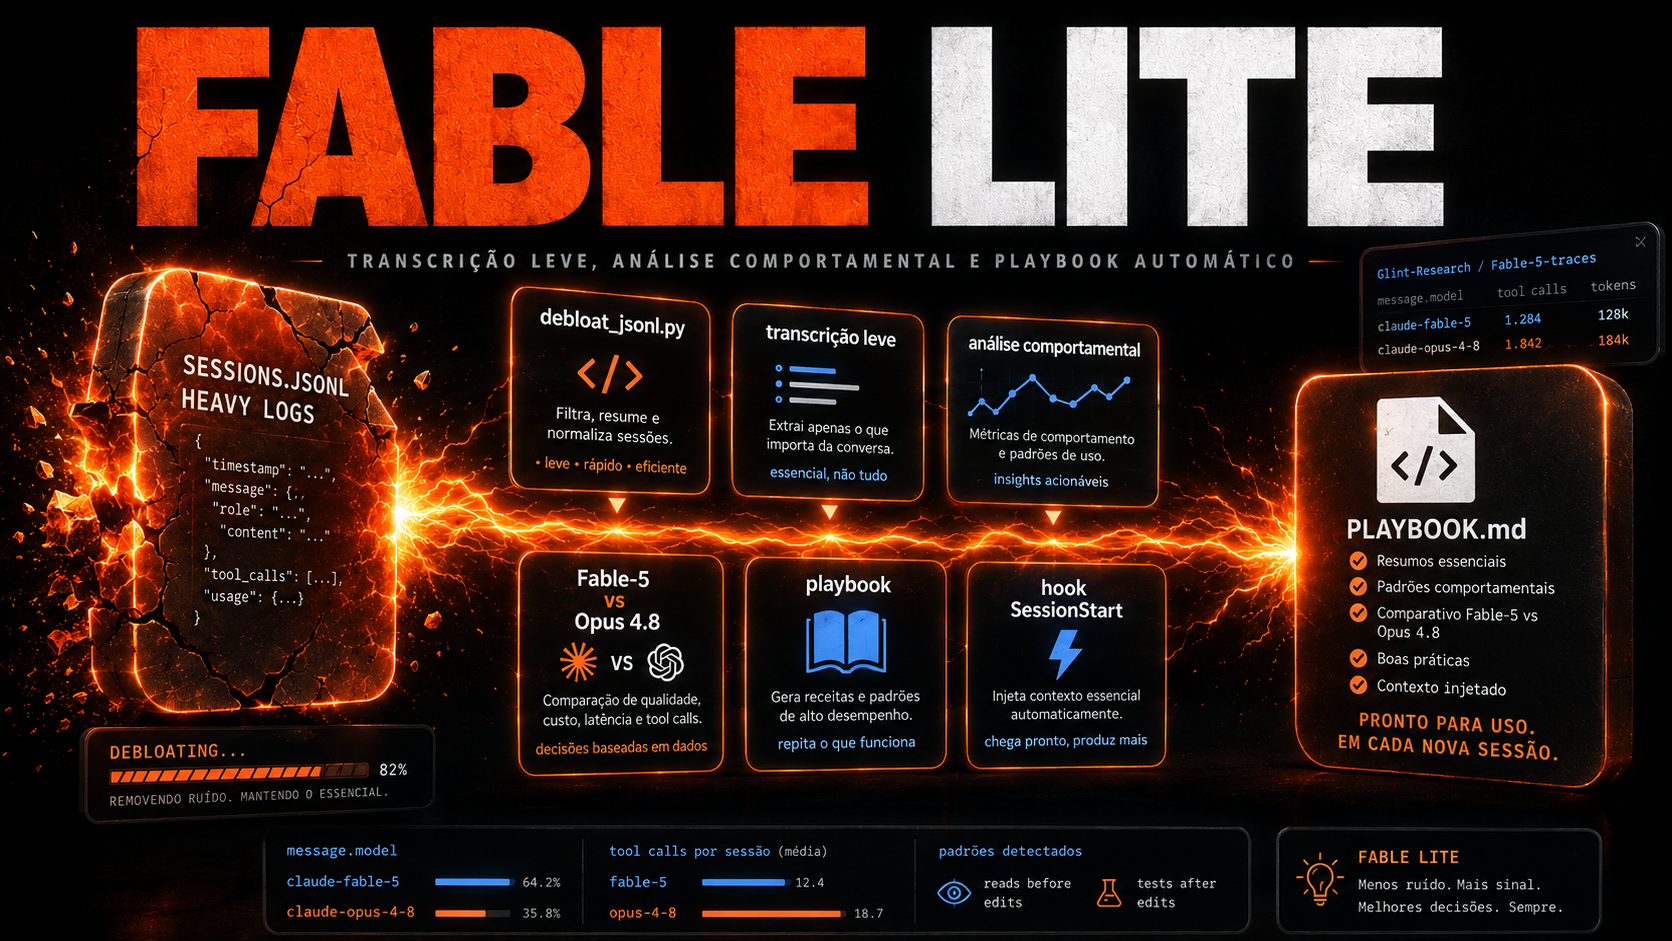
El pipeline es honesto y breve: (1) destila lo superfluo (tool_results, volcados de archivo, adjuntos), (2) extrae el corpus de un modelo, (3) mide el comportamiento, (4) compara Fable vs Opus, (5) se convierte en playbook y se inyecta mediante hook / skill / CLAUDE.md.
Cómo funciona: todo el pipeline
Del registro bruto al playbook inyectado: cada caja es un script de Python con la biblioteca estándar pura en scripts/.
Los números reales (medidos en este proyecto)
Fable-5 pensó antes de actuar en el 99% de los turnos lógicos.
⚠ Actualización: medido después con una muestra grande (4.892 pasos), el número honesto es ~85% (no 99%) y la brecha baja a +31 pts — y aparece una brecha oculta en prueba-después-de-editar (41% frente a 2%). Consulta la Ruta 4 · La prueba real.
Opus-4.8 pensó antes de actuar en el 54% de los casos: un delta de +45 puntos.
El debloat reduce una sesión típica alrededor de un 74%.
Herramientas por turno: Fable-5 usó 6,57 herramientas/turno; Opus-4.8 usó 7,86 — es decir, Fable fue más económico. La señal fuerte y transferible es el pensar-antes-de-agir; los demás son buenas prácticas, no diferencias confirmadas.
⚠️ El hallazgo honesto (lo que distingue este curso)
O texto del razonamiento NO queda en los logs — viene cifrado (solo la signature).
No extraes el pensamiento literal del modelo.
Lo que extraes es la presencia del razonamiento, el texto visible e a secuencia de herramientas — es decir, el ritmo de trabajo. Y eso ya es lo bastante potente como para convertirse en un playbook.
Las cuatro rutas
🪙 Los logs son oro
Dónde viven las conversaciones, la anatomía de una sesión JSONL y qué es grasa frente a oro.
RUTA 2🛠️ Manos a la obra
Debloat en la práctica, extracción del corpus, números reales y el delta Fable vs Opus.
RUTA 3📓 Del Delta al Playbook
Escribir el playbook e inyectarlo en el modelo, incluso sin datos propios.
RUTA 4🛡️ La prueba real
Las 3 pruebas de medición, la trampa de la muestra y las soluciones — con ejemplos de uso.
Descárgalo y úsalo ahora
📥 El Playbook (.md)
El archivo de síntesis generado a partir de los números reales (muestra grande: Fable 5 85% vs Opus 4.8 54% de pensar antes, y prueba después de editar 41% vs 2%). Conéctalo a tu modelo mediante un hook, skill o CLAUDE.md.
🧩 La skill fable-mindset (.zip)
La skill de Claude Code con los 5 scripts integrados. Descomprime en ~/.claude/skills/ y se activa sola (reducir el volumen de código, comparar modelos, generar un playbook).
Los scripts y el conjunto de datos abierto
📂 scripts/ en este proyecto
Cinco scripts de Python con solo la biblioteca estándar que ejecutan todo el pipeline: debloat_jsonl.py, extract_corpus.py, compare_models.py, make_playbook.py e import_hf_traces.py.
🤗 Dataset abierto (Hugging Face)
¿Sin datos propios? Usa las trazas abiertas de Fable para ejecutar el pipeline desde ya.
Glint-Research/Fable-5-traces →Aprende a analizar el ritmo de los modelos
Este curso es parte de la comunidad INEMA.CLUB — investigación, educación y experimentos con IA aplicada.