Dois comandos: projeto "o que faz" acha o projeto, numa pasta ou só no GitHub. memoria "pergunta" responde com data e fonte, a partir das suas lições e anotações. Índice e busca rodam na sua máquina; a memória usa a sua assinatura do Claude, sem chave de API.
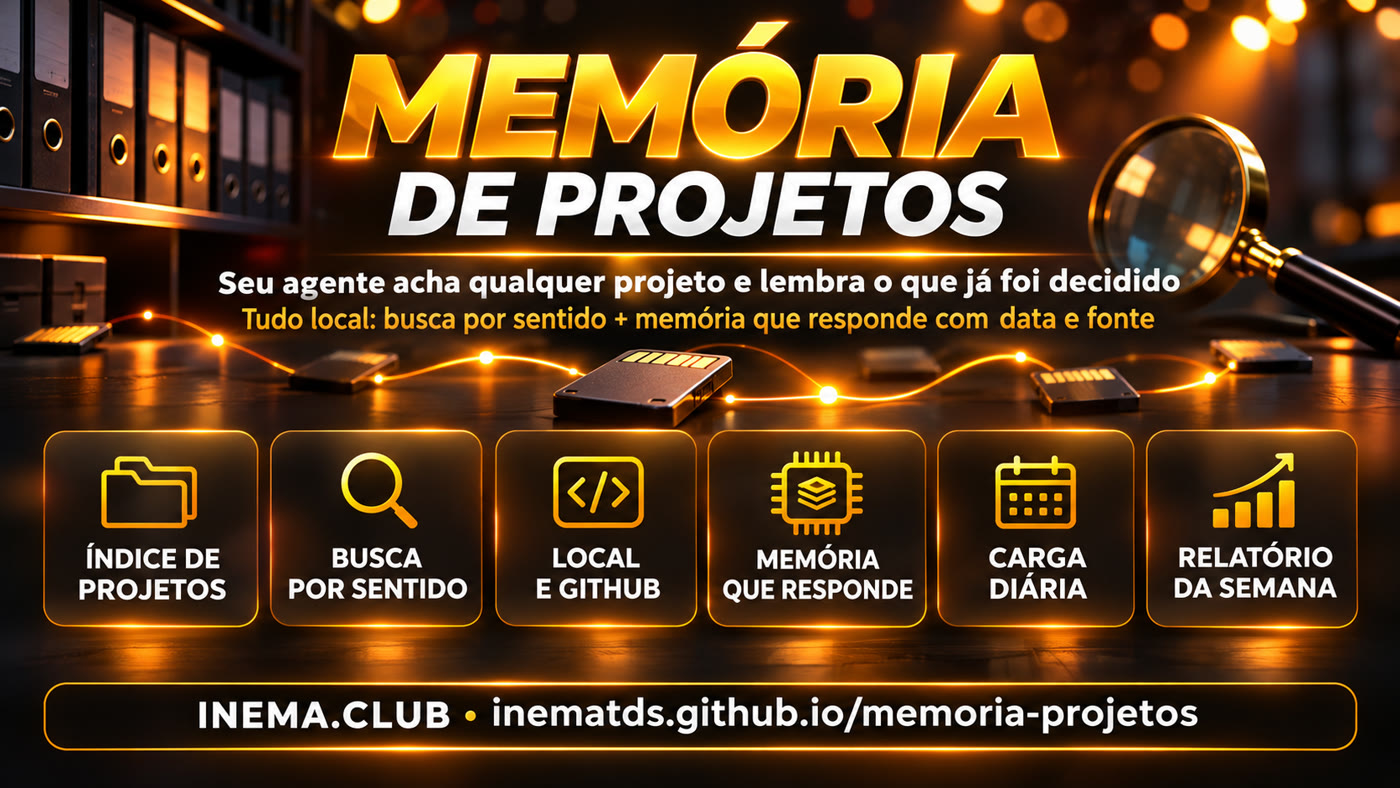
O memoria-projetos é um kit para quem tem muitos projetos e trabalha com agentes de IA, como o Claude Code e o Codex. Ele resolve dois problemas: o agente não sabe onde está cada projeto e esquece o que já foi decidido. O comando projeto procura pelo que o projeto faz, nas suas pastas e no GitHub. O comando memoria responde perguntas como "pode fazer X?" lendo suas lições e anotações. Para usar, você precisa de um computador com Linux, Python, o Ollama e, para a memória, a assinatura do Claude. Atenção: o índice fica todo na sua máquina, mas a memória manda o texto das anotações ao Claude para extrair os fatos.
Dá para instalar só uma. O índice roda todo local; a memória guarda tudo local, mas usa o Claude para extrair os fatos. As duas se atualizam sozinhas todo dia.
projeto "o que faz" procura por palavra e por sentido em mais de mil projetos, inclusive os que só existem no GitHub, e avisa quando a pasta local está atrás do GitHub.
memoria "pode X?" lê suas lições, falhas e a memória do agente e devolve uma resposta curta com data e fonte, em vez de um monte de linhas de grep.
Cada uso fica registrado. Toda semana sai um relatório: quantas vezes o agente usou, quanto tempo levou, quanto custou e se as respostas foram úteis.
Índice: pastas e repositórios viram uma linha cada. Para buscar por sentido, cada linha vira um vetor (uma lista de números que representa o significado do texto), calculado pelo modelo bge-m3 no Ollama local. Memória: o Hindsight, um servidor de memória para agentes de código aberto (MIT), guarda os fatos num banco local e usa o Haiku, o modelo menor e mais rápido do Claude, pela sua assinatura, para tirar fatos das anotações e responder. Um modelo local de reordenação põe os trechos mais relevantes no topo.
projeto "X"
memoria "pergunta"→
Relatório da semana
O instalador só confere estas coisas; ele não instala nada do sistema.
O Ollama fornece os vetores multilíngues (as duas metades usam).
# modelo de vetores ollama pull bge-m3
Logado em cada conta que você quer indexar. Sem ele, o índice fica só com as pastas locais.
gh auth login # uma vez por conta gh auth status
A memória usa a sua assinatura pelo provedor claude-code do Hindsight, indicado para uso pessoal e local. Os horários automáticos usam o systemd de usuário; o enable-linger deixa os timers rodarem mesmo com você deslogado. Sem systemd, use --sem-systemd e rode à mão.
claude --version loginctl enable-linger "$USER"
Comandos do README do repositório. A primeira subida do servidor da memória baixa o banco embutido e o modelo de reordenação; depois, tudo roda local.
O --dry-run mostra tudo antes, sem gravar nada.
git clone https://github.com/inematds/memoria-projetos.git cd memoria-projetos ./instalar.sh --dry-run
Cria os atalhos projeto e memoria em ~/.local/bin, os serviços com teto de memória e instala o Hindsight (cerca de 2 GB). Só uma metade: --so-indice ou --so-memoria. Se já existir um atalho ou serviço com o mesmo nome que não seja do kit, ele pula e avisa; para substituir, use --forcar. Confira se ~/.local/bin está no seu PATH.
./instalar.sh --instalar-hindsight echo $PATH | grep -q .local/bin || echo 'export PATH="$HOME/.local/bin:$PATH"' >> ~/.bashrc source ~/.bashrc # ou abra um terminal novo systemctl --user status memoria-hindsight # 1ª subida baixa o banco: espere "active (running)"
Em indice/config.json: a pasta raiz dos projetos e as contas do GitHub (troque sua-conta-github pela sua, ou deixe [] para só pastas locais). Em memoria/fontes.json: os arquivos de lições, falhas e memória. Em memoria/.env: o nome do banco de memória (um por pessoa ou projeto).
# uma fonte em memoria/fontes.json (modelo completo em fontes.exemplo.json) {"nome": "licoes", "tipo": "linhas", "caminho": "~/meu-projeto/LESSONS.md", "contexto": "lição aprendida no projeto", "tag": "licao"} # a memória do Claude Code fica em ~/.claude/projects/<pasta>/memory ls ~/.claude/projects/ # <pasta> = caminho do projeto com / trocado por -
Mil projetos levam de 1 a 2 minutos. Depois, procure algo que você sabe onde está para conferir.
projeto --atualizar projeto "publica vídeo no youtube" -n 5 # * = todas as palavras casaram
Veja antes o que seria enviado. Cada documento é uma chamada ao Haiku e gasta um pouco da cota da sua assinatura: no piloto, cerca de 5,6 mil tokens de entrada por documento, e 100 documentos levaram 8 minutos.
python3 memoria/carga.py --simular # não envia nada python3 memoria/carga.py --max 200 # carga inicial
Resposta pronta (30 a 75 s) ou só os trechos (7 a 17 s, sem LLM na resposta). Depois, dê uma nota à última resposta (o texto entre aspas é o motivo): ela entra no relatório.
memoria "posso rodar processo longo sem teto de memória?" memoria -r "systemd PATH" memoria --nota util "achou a regra certa"
O agente só usa o que está na regra dele. Cole o bloco "Achar projeto e consultar a memória" do README no CLAUDE.md ou no AGENTS.md. A memória não entra no início da sessão: o agente pergunta quando precisa, e assim a cota só é gasta quando há pergunta.
# trecho da regra
- Pergunta de regra ou decisão: rode `memoria "pergunta"` ANTES do grep nas lições e falhas.
Os timers refazem o índice às 05:40, gravam só o que é novo às 06:10 e geram o relatório toda segunda às 08:00. Com ele você decide se fica, se muda a regra ou se desliga.
python3 memoria/semana.py # → memoria/semana-AAAA-MM-DD.md python3 memoria/avalia.py # grep × trechos × resposta nas suas perguntas (gasta cota)
Para parar tudo, desligue os serviços. Para remover, apague também os atalhos, o ambiente Python do Hindsight e o banco local (~/.pg0).
systemctl --user disable --now memoria-hindsight.service memoria-carga.timer memoria-semana.timer memoria-indice.timer rm ~/.config/systemd/user/memoria-*.service ~/.config/systemd/user/memoria-*.timer systemctl --user daemon-reload rm ~/.local/bin/projeto ~/.local/bin/memoria rm -rf memoria/.venv # de dentro da pasta do kit rm -rf ~/.pg0 # só se nenhum outro programa usa o pg0: apaga a memória gravada
Saídas reais de uma máquina com cerca de mil projetos; os nomes são dos projetos dela.
Sem lembrar o nome, só o que ele faz. O * marca que todas as palavras casaram:
projeto "publica vídeo no youtube" -n 2 1.01* yt-pubx — Publique qualquer vídeo no YouTube com um comando… 0.96* yt-pub-livesx2 — Publicador de vídeos no YouTube para N canais…
Com -r, vêm só os trechos que interessam, cada um com sua origem:
memoria -r "systemd PATH codex" # 12,7 s - systemd-run sem PATH chamou /usr/bin/codex antigo… definir PATH com ~/.npm-global/bin
grep (como é hoje): 10 de 10, mas foram 43,6 mil tokens de linhas misturadas para o agente ler. Trechos (-r): 9 de 10, com 5,3 mil tokens. Resposta pronta: 10 de 10, com 4,3 mil tokens, cerca de 10 vezes menos texto. Este resultado é de um piloto pequeno, avaliado por quem o montou, e o uso real está sendo medido pelo relatório semanal.
O índice está em uso diário. A memória está em teste: o relatório semanal decide os próximos passos.
memoria com nota de utilidade e relatório semanal de uso e custo.