Modo en masa
Cuando el problema no es un proyecto, sino doce
El prompt de arriba abre uno proyecto a fondo. Hay un segundo modo, en el mismo repo, para cuando la pregunta es otra: tengo varios proyectos detenidos — ¿cuál hago primero, cuál simplifico, cuál abandono?
⚔️ War Game
Un proyecto, a fondo. Responde «¿cómo construir esto sin recibir golpes en el camino?». Entrega un plan por fases, una tabla maestra de fallas y un expediente visual en HTML.
🗂️ War Game en masa
Varios proyectos, comparados. Responde «¿por dónde empiezo?». Entrega un análisis por proyecto, un ranking por impacto/esfuerzo/riesgo y un plan de 30 y 90 días.
Ambos usan la misma lógica — acción → reacción → contraataque — y la misma regla: prever el obstáculo antes de la primera línea de código. La diferencia está en dónde se gasta el modelo costoso.
Un archivo por proyecto→
Contexto + criterios comunes→
Prompt maestro (modelo potente)→
Ronda de revisión→
Ranking + 30/90 días→
Ejecutar 1 proyecto (modelo económico)
1
Arma la estructura y escribe un archivo por proyecto
Nunca juntes varios en un solo archivo — eso mezcla el contexto y destruye la comparación. Empieza con el briefing mínimo de 5 preguntas; lo que no sepas, déjalo en blanco, no adivines.
analise-projetos/
├── projetos/          # projeto-01.md, projeto-02.md, ...
├── resultados/        # la IA escribe aquí
├── contexto-geral.md  # qué aplica a todos
├── criterios.md       # los mismos criterios para todos
├── ledger.md          # bloqueos
└── assumptions.md     # suposiciones, con impacto si son incorrectas
2
Completa el contexto general y los criterios
Esos dos archivos son los que permiten comparar proyectos diferentes. Un criterio común permite crear un ranking; los criterios por proyecto no permiten hacerlo.
# criterios.md — los mismos para todos
substância  clareza · problema real · público · valor · diferencial
execução   viabilidade · complexidade · gargalo · simplificação · automação
risco      o que impede · segurança · manutenção · escala
retorno    receita · custo
3
Ejecuta el prompt maestro con el modelo más capaz
Genera una primera versión de todos los proyectos — sin pulir ninguno. Pulir el proyecto 01 antes de revisar el resto consume el presupuesto en el primero de la fila, que rara vez es el más importante.
cat doc/war-game-massa-portugues.md # o doc/mass-war-game.md (EN)
4
Ejecuta la ronda de revisión
La primera ronda casi siempre sale genérica. La segunda es la que elimina lo genérico: busca contradicciones, riesgos ignorados, etapas sin validación y acciones sin condición de parada.
revisar /resultados → aprofundar war-game → atualizar ledger + suposições
5
Elige UN proyecto y entrégaselo al modelo económico
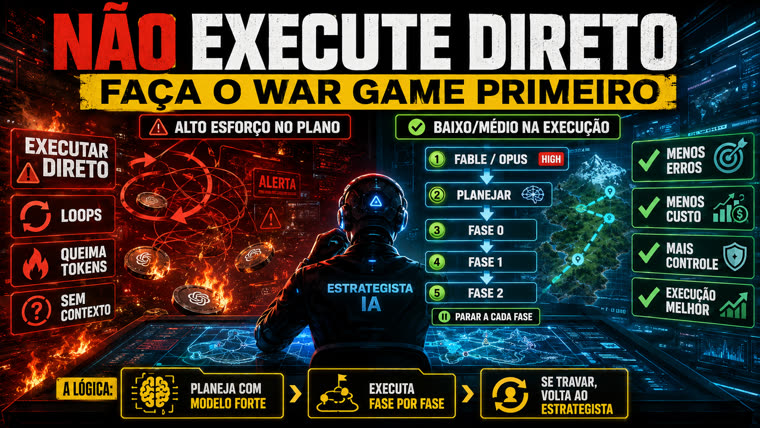
El análisis puede ser masivo. La ejecución, no. Lee el resumo-geral.md, elige el prioritario y entrega su war-game con el prompt de ejecución.
modelo avançado pensa e antecipa
modelo intermediário organiza
modelo barato executa  # siguiendo el plan ya detallado
O ledger.md e o assumptions.md son lo que impide que el análisis se convierta en ficción: sin ellos, el modelo inventa lo que falta para poder continuar. ¿Falta información? Se convierte en [PRECISA_DEFINIR: x] en el punto exacto donde haría falta.
¿Quieres ver hasta dónde llega? El ejemplo de resultado presenta un portafolio ficticio de 4 proyectos analizado de principio a fin — un análisis individual completo, o resumen general con clasificación y plan de 30/90 días, además del ledger y las suposiciones. Es la referencia de «listo» para este modo.