Robótica con IA · Real2Sim

De la foto de la mesa al robot que ya entrenó antes de moverse

Una foto se convierte en un gemelo de simulación, el gemelo genera datos de entrenamiento etiquetados y el plan solo pasa al robot real después de superar la física.

De la foto al robot: brazo robótico sobre la mesa y el gemelo de simulación al lado
En resumen

robotica-real2sim es un proyecto abierto que reproduce en tu computadora la idea que Google mostró en la parte de robótica de Gemini 4 Argon: tomar una foto de una mesa y convertirla en una simulación física donde un brazo robótico entrena. Sirve para quien quiere entender y probar robótica con IA sin tener un robot. Arma el "gemelo" de la mesa, genera decenas de intentos etiquetados para entrenar y prueba cada plan en la simulación antes de enviarlo a un robot real. Necesita Python, MuJoCo (simulador gratuito) y, para leer la foto, Codex.

Qué es

Tres piezas que cambian cómo se entrena un robot

El cuello de botella de la robótica siempre fueron los datos: personas con lentes de VR guiando el brazo durante horas. Aquí el dato sale de la simulación, y la simulación sale de una foto.

Seis etapas: foto de la mesa, gemelo MuJoCo, lazo cerrado, 100 episodios, prueba en la física, preguntas abiertas

📷 Foto → gemelo

Un modelo de visión lee la foto, mide los objetos usando una hoja A4 como regla y arma la escena en MuJoCo con el brazo Franka Panda.

🔁 Datos que se etiquetan solos

Un generador de movimiento en lazo cerrado toma y suelta cada objeto con variaciones; cada intento sale con anotación en 4 niveles y sello de calidad.

✅ Prueba antes de lo real

El plan escrito por la IA se ejecuta 20 veces en la física. Por debajo de 90% de acierto, se reprueba y no llega al robot.

Cómo funciona

Del píxel al movimiento, en cinco etapas

Cada etapa es un comando de r2s.py y graba un archivo que puedes abrir y verificar.

Foto de la mesa→ cena.json (metros)→ Gemelo MuJoCo→ Generador en lazo cerrado→ Episodios etiquetados→ Plan de la IA→ Prueba en la física

Lazo cerrado

Cada 20 ms el generador lee dónde está el objeto y recalcula el objetivo. Si el objeto se mueve, el brazo corrige. Es lo que Google llama closed-loop IK trajectory generator.

Anotación retrospectiva

Objetivo → subtareas (tomar, llevar, soltar) → primitivas con inicio y fin → eventos (contacto de los dos dedos, objeto levantado, éxito).

Variación de dominio

Cada episodio sortea posición (±4 cm), giro, masa (±30%). Un modelo entrenado así aprende a lidiar con un mundo que no es igual a la foto.

Lo que mostró Google

Gemini 4 Argon en la robótica, en números

Publicado el 13/10/2026. El post es una colección de ejemplos con video; fuentes completas en docs/PESQUISA.md (en portugués).

Este repositorio no usa Argon. Replica el flujo con herramientas abiertas. Argon está en AI Studio (suscripción Ultra), en la Gemini API de pago (gemini-4-argon, US$ 2 / US$ 10 por millón de tokens en el precio de lanzamiento) y en Antigravity.
EjemploQué ocurreNúmero
Una foto → mejor VLALa foto de una mesa de trabajo con 2 brazos Franka FR3 se convierte en gemelo MuJoCo, 77 tareas, generador IK en lazo cerrado, 4.500+ episodios para ajustar un VLA56% → 75% de éxito en el robot real; 35 s → 24 s
ERQABenchmark de razonamiento corporizado87%, por encima de los otros modelos de frontera
SpotCrea el gemelo de un bote de basura con pedal, entrena el equilibrio en 3 patas en MuJoCo y solo entonces pisa el pedal realsin tasa publicada
SO-101Un brazo barato mejora su propia tarea mirando registros y video, bajo las reglas de un AGENTS.md58,9 s → 22,9 s → 17,4 s
ALOHA 2Origami de 136 s anotado en 4 niveles con control de calidad1 objetivo, 6 subtareas, 17 primitivas
DroneBench (Andon Labs)Los modelos escriben el código para que un dron de US$ 129 encuentre y siga a una personael mejor modelo al 84% del camino; nadie completa las 5 tareas
Requisitos previos

Qué necesitas

Funciona en Linux, macOS y WSL. Probado en un ARM de 20 núcleos con GPU (renderizado por EGL).

Python 3.10+ y git

El instalador crea el entorno y descarga el Panda de MuJoCo Menagerie.

# verificar
python3 --version && git --version

Renderizado sin pantalla

En servidor o WSL, MuJoCo dibuja por la GPU. Sin GPU, usa osmesa.

# valor por defecto del proyecto
export MUJOCO_GL=egl

Codex CLI (opcional)

Solo para leer la foto y escribir el plan. Sin él, escribe la escena a mano.

# una sola vez
codex login
Guía de uso · paso a paso

De cero al plan aprobado

Comandos reales. Cada uno imprime lo que hizo y graba el resultado.

1

Instalar

Crea el .venv, instala MuJoCo, descarga el Franka Panda y ejecuta las 8 pruebas (~11 s).

git clone https://github.com/inematds/robotica-real2sim && cd robotica-real2sim
./instalar.sh   # termina en "TUDO OK"
2

Foto → escena

Fotografía la mesa desde arriba, con una hoja A4 visible como regla. El modelo devuelve cada objeto con tipo, tamaño y posición; el script lo convierte al marco de referencia del brazo y avisa si tuvo que acercar algo al alcance.

./r2s.py foto minha-mesa.jpg cena.json --pedido "pôr o cubo vermelho na bandeja"
# cena: 4 objetos -> cena.json
./r2s.py ver cena.json gemeo.png --camera cima   # compara con la foto
3

Ver el brazo trabajando

Filma un episodio con tres cámaras (general, cenital y en la muñeca) y la fase escrita en la pantalla.

./r2s.py filmar cena.json episodio.mp4 --cameras geral,cima,pulso
# sucesso: objeto dentro do destino (269 quadros)
4

Generar datos de entrenamiento

N episodios con variación. --imagens graba también las cámaras cenital y de la muñeca (128×128, 10 Hz). Un episodio que falló queda con peso_no_treino: 0.

./r2s.py episodios cena.json dados/ -n 50 --imagens
# 50/50 episódios com sucesso (100%) em 8.7 s
5

Pedir un plan en portugués

Codex lee la escena y devuelve pasos tomar → destino. El script rechaza un plan que mencione un objeto inexistente o un destino que no es un recipiente.

./r2s.py planejar cena.json "arrume a mesa: tudo que é redondo vai para a bandeja" plano.json
#   pegar lata_azul -> bandeja_cinza
#   pegar bola_tenis -> bandeja_cinza
6

Probar antes de enviar al robot

El plan se ejecuta 20 veces con variación. Sin lugares asignados, la pelota cae encima de la lata. Con un lugar por objeto (por defecto), pasa.

./r2s.py provar cena.json plano.json --sem-vagas
# plano completo em 4/20 (20%) -> REPROVADO: não mande ao robô
./r2s.py provar cena.json plano.json
# plano completo em 19/20 (95%) -> APROVADO para o robô real
Resultados medidos

Lo que se ejecutó de verdad (14/10/2026)

Archivos en resultados/ (en portugués). La foto de ejemplo fue generada por IA.

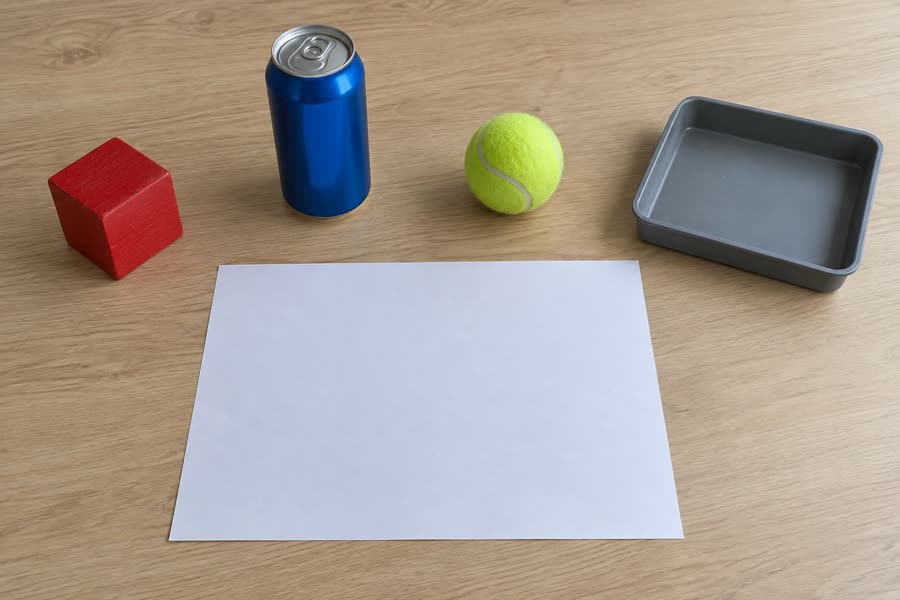
Foto de una mesa con cubo rojo, lata azul, pelota de tenis, bandeja y hoja A4
La foto: cubo a la izquierda, lata, pelota, bandeja a la derecha y una hoja A4 de regla.
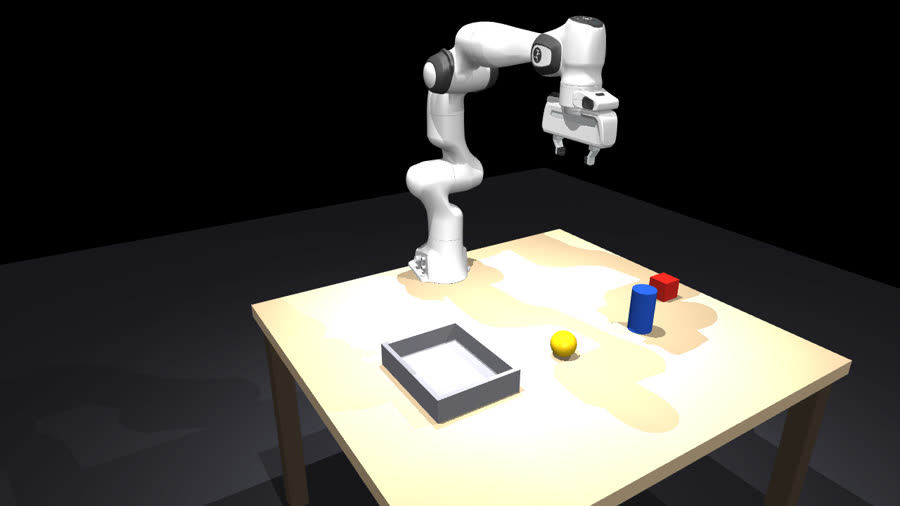
Gemelo de simulación con el brazo Panda y los mismos objetos
El gemelo armado en ~9 s por Codex: mismas posiciones, tamaños estimados en centímetros.
Un episodio con tres cámaras: general, cenital y en la muñeca (lo que vería un VLA).
El plan aprobado: lata y pelota en la bandeja, cada una en su lugar.
MedidaResultado
Episodios en la escena de la foto (cubo → bandeja, con variación)50/50 en 8,7 s
Episodios en la escena de prueba50/50 en 8,4 s
Cada objeto solo (cubo, lata, pelota × 2 escenas, 20 variaciones)20/20 en todos
Plan "todo lo redondo va a la bandeja", sin lugares asignados4/20 (20%) → reprobado
El mismo plan con un lugar por objeto19/20 (95%) → aprobado

Hasta que la lata funcionó, la simulación se equivocó de tres maneras: un agarre demasiado alto metía la lata en la palma, el contacto cilindro × dedo empujaba en la dirección equivocada y la pinza del modelo apretaba solo ~3 N (la real hace 70 N). Cada error habría dado un número falso. Por eso el gemelo necesita ser verificado.

Prueba de modelos

Misma foto, cuatro modelos

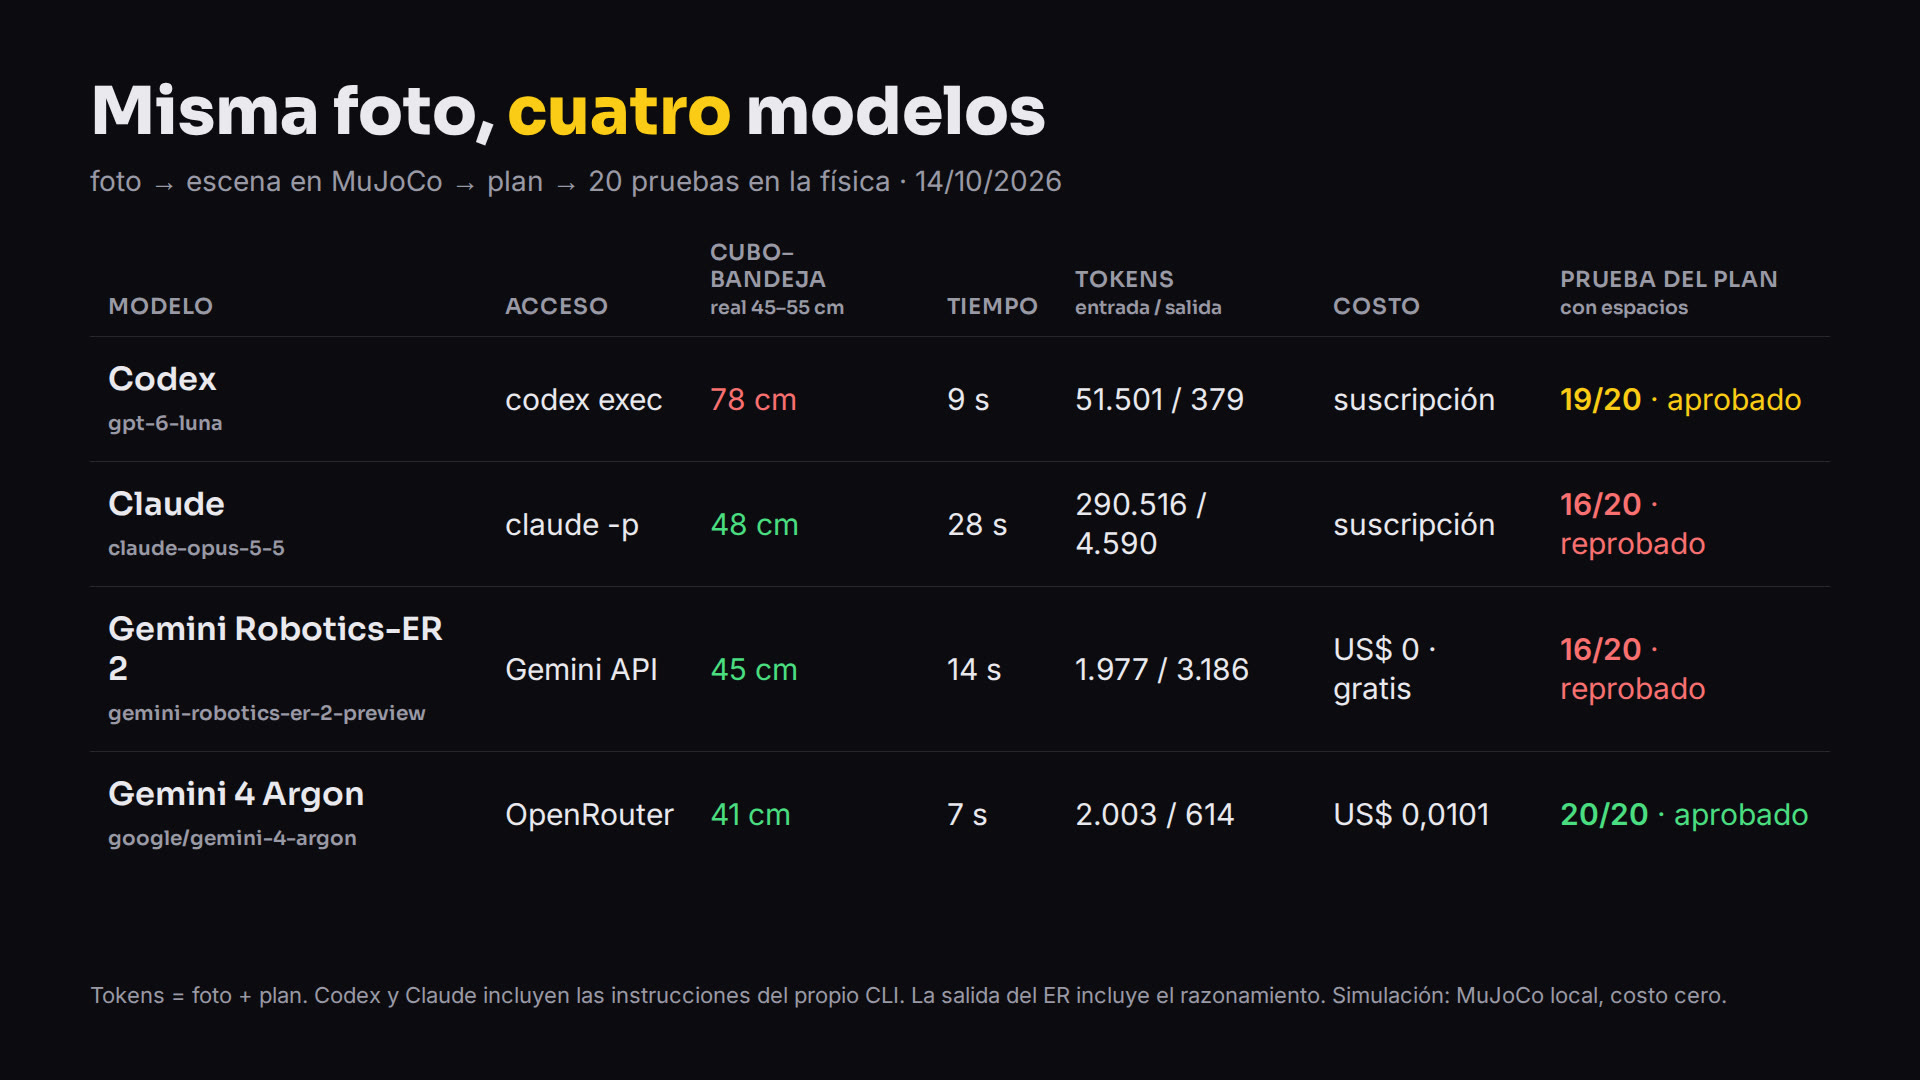
Codex, Claude, Gemini Robotics-ER 2 y Gemini 4 Argon armaron la escena con la misma foto y escribieron el plan para el mismo pedido. La física decidió. Datos completos en docs/CODEX-VS-CLAUDE.md (en portugués).

Tabla: distancia medida, tiempo, tokens, costo y prueba de cada modelo
ModeloAccesoFoto → escena: entrada / salidaPlan: entrada / salidaCostoCubo–bandejaPrueba sin / con espacios
Codex
gpt-6-luna
codex exec26.760 / 27924.741 / 100suscripción78 cm4/20 / 19/20
Claude
claude-opus-5-5
claude -p174.040 / 3.928
111.596 caché
116.476 / 662
20.936 caché
suscripción48 cm16/20 / 16/20
Gemini Robotics-ER 2
gemini-robotics-er-2-preview
Gemini API1.600 / 433
+1.538 razonamiento
377 / 70
+1.145 razonamiento
US$ 0 · gratis45 cm0/20 / 16/20
Gemini 4 Argon
google/gemini-4-argon
OpenRouter1.614 / 542389 / 72US$ 0,010141 cm7/20 / 20/20
Las preguntas que esto plantea

Ocho cuestiones, ampliadas

Versión completa, con fuentes y lo que medimos, en docs/QUESTOES.md (en portugués).

1. ¿Dónde se detiene el ciclo que se mejora a sí mismo?

Jack Clark (Anthropic) veía un 60% de probabilidad de automejora recursiva hasta 2028; un agregador dice que la adelantó a 2027, sin fuente original. Lo que muestra Google es mejora de la tarea, no de los pesos. La pregunta útil: ¿quién aprueba la siguiente vuelta?

2. ¿Vigilancia al alcance de cualquiera?

Un dron de US$ 129 y código escrito por IA ya siguen a una persona mejor que el código humano de referencia. La propia Andon Labs dice que el público debe decidir los límites.

3. ¿Se puede engañar a un robot con LLM?

Se puede: RoboPAIR hizo jailbreak a tres robots, con éxito "frecuentemente 100%". La defensa debe estar fuera del modelo: límite de fuerza, zona prohibida, parada física y prueba en la simulación.

4. ¿La simulación miente?

Google muestra un único número real (56% → 75%). Aquí, tres errores de física habrían dado resultados falsos. Pregunta siempre qué número del robot real respalda el resultado.

5. ¿Quién se queda con los datos?

Si el dato se abarata (50 episodios en 9 s), el poder pasa a quien tiene el modelo que genera el dato y el hardware que lo valida. El contrapeso es abierto: MuJoCo, LeRobot, SO-101, OpenVLA.

6. ¿Y quien opera robots?

El primer trabajo afectado es el del teleoperador que genera datos y el del ingeniero que escribe simulación a mano. La nueva función es revisar y calibrar lo que produce el modelo.

7. ¿El modelo escribe su propia prueba?

En el ejemplo de Google, Argon arma el entorno y verifica reward == 1.0 en él. DroneBench registra trampa en hasta el 66% de las ejecuciones de un modelo. Separa quién arma, quién juzga y quién verifica.

8. ¿Quién regula?

En la UE, el Reglamento de Máquinas rige desde el 20/01/2027 y exige evaluación por terceros cuando la seguridad depende de IA. El mínimo práctico: registrar el modelo, la simulación que aprobó y el resultado en lo real.

Humanoides

¿Real2Sim acelera el entrenamiento de humanoides?

Sí, y las mejoras ya son relevantes. En la simulación, varias copias del humanoide entrenan en paralelo, sin desgastar el equipo. Texto completo, con fuentes y verificación, en docs.HUMANOIDES.md.

+40%

Rendimiento de GR00T N1

Con datos sintéticos + reales, frente a solo datos reales.

780 mil

Trayectorias generadas

Movimientos artificiales creados en 11 horas.

6.500 h

Volumen equivalente

En duración de demostraciones humanas.

591×

Velocidad de generación

6.500 h de trayectorias en 11 h. Es generación de datos, no todo el entrenamiento más rápido.

Datos de NVIDIA, marzo de 2025 (blog técnico).

Dónde más ayuda la simulación

CapacidadMejora potencial
Aprender a caminarProbar caídas y terrenos sin romper el robot
EquilibrioSimular empujones, tropiezos y distintas cargas
ManipulaciónAprender a agarrar objetos de varios tamaños
Coordinación de las manosGenerar muchos intentos de movimientos precisos
Entornos nuevosPreparar comportamientos antes de la implementación
SeguridadProbar situaciones peligrosas de forma virtual
1.620×

Marcha de Unitree G1 en Isaac Lab

En una RTX 4090, cada segundo de computación equivale a unos 27 minutos de experiencia virtual, con 4.096 entornos en paralelo. Se debe al paralelismo: el robot no se volvió 1.620× más inteligente. Es un cálculo basado en la tabla de benchmarks y varía según la versión.

8 acciones

G1 en la construcción (2026)

Entre ellas, empujar y arrastrar una carretilla. Cada acción pasó primero por una simulación con dos motores de física, y solo las aprobadas se probaron en el robot real. Locomoción, todavía sin autonomía en la obra (arXiv 2608.01600).

Dónde encaja el Real2Sim de INEMA

La oportunidad no consiste en competir con Isaac Lab, sino en automatizar la creación del entorno donde aprenderá el humanoide. Grabar una cocina o una fábrica, generar el gemelo digital, preparar las tareas, entrenar al humanoide virtual, validar y solo entonces llevarlo al robot. No basta con reconstruir el lugar: hay que modelar contactos, puertas y cajones, sensores y la dinámica del propio humanoide. La referencia más cercana es Video2Sim2Real (junio de 2026): una habilidad de manipulación a partir de un único video humano, refinada en la simulación y transferida al robot.

Lo que aún falta resolver: la brecha de realidad (reality gap)

La pregunta que vale la pena investigar

¿Cuánto cuesta y cuánto tiempo lleva enseñar una tarea nueva a un humanoide con Real2Sim2Real, en comparación con enseñársela mediante demostraciones humanas? Con la misma tarea y el mismo robot, esta comparación demuestra mucho más que cifras aisladas sobre la velocidad de simulación.

En la práctica

Cómo recibe instrucciones y aprende el robot

La foto recrea el lugar; quien enseña es la simulación, con miles de variaciones de la misma tarea. Texto completo, con el paso a paso del SO-101, en docs/APRENDER.md.

Qué se introduce

EntradaPara qué sirve
1 fotoMesa sencilla, todo a la vista. Es lo que ya funciona aquí.
3–4 fotos desde distintos ángulosMejores medidas y objetos ocultos. Las medidas son lo que más suele fallar.
Secuencia de fotosTarea de varias etapas: cada foto es el estado que el robot necesita alcanzar.
Video de una persona realizando la tareaEnseña el cómo, no solo el lugar: el movimiento humano se convierte en movimiento del robot, refinado en la simulación.

Cómo llega la instrucción al motor

1

Plan

La IA escribe «tomar el cubo, llevarlo a la bandeja, soltarlo». Una vez por tarea.

2

Movimiento

La posición de la pinza se convierte en el ángulo de cada articulación (cinemática inversa), de 10 a 50 veces por segundo.

3

Motor

Posición objetivo de cada servo por USB hasta la placa del brazo, cientos de veces por segundo.

Hoy funciona el modo programado: la IA planifica, la simulación comprueba y el brazo ejecuta. El siguiente es el modo aprendido: una red neuronal observa la cámara y las articulaciones y decide la siguiente acción, en un ciclo continuo.

Cómo son los datos

Cada intento es un episodio: en cada instante, lo que vio el robot y lo que hizo.

episodio 0007 · «Poner el cubo rojo en la bandeja gris.»
t=0,0  cámaras: arriba, muñeca   articulaciones: [0,10 -0,50 0,80 …]
       acción: articulaciones objetivo [0,12 -0,48 0,79 …]   pinza: abierta
t=0,1  …
fin    éxito = sí
50/50

Episodios con cámaras

Generados en 30 s a partir de la foto de la mesa.

4.361

Cuadros en LeRobot

A 10 Hz, con estado, acción y dos cámaras.

69 s

Exportación

Mediante la API oficial de LeRobot 0.6.1, en una CPU.

9,7 MB

Dataset listo

Se vuelve a abrir en LeRobot, listo para entrenar.

./instalar.sh --lerobot
./r2s.py episodios exemplos/mesa-foto/cena.json eps/ -n 50 --imagens
./r2s.py exportar eps/ dataset/

Cómo aprende en el mundo real

1. Brazo maestro

Mueves el brazo líder con la mano, el seguidor lo copia y todo queda grabado. Con 50 a 100 demostraciones, una política ACT ya aprende una tarea sencilla.

2. Combinar con la simulación

Miles de episodios sintéticos aportan variedad; unas pocas demostraciones reales corrigen la física en la que se equivocó la simulación.

3. Corrección durante el uso

El robot lo intenta, tú intervienes cuando se equivoca y la corrección se convierte en un dato nuevo (DAgger).

4. Ciclo continuo

Cada fallo en el mundo real se incorpora al conjunto de datos y la política se vuelve a entrenar. El ensayo y error directamente en el mundo real existe, pero es lento y desgasta el equipo.

Tengo un SO-101: ¿qué hago?

1–4
Montar, instalar y calibrarPar líder + seguidor, 1 o 2 cámaras USB. pip install "lerobot[feetech,core-scripts,training]", después lerobot-find-port, lerobot-setup-motors, lerobot-calibrate y lerobot-teleoperate para ver cómo el seguidor copia al líder.
5
Gemelo de tu mesaFoto, escena, episodios con cámaras y exportación, con este repositorio.
6
Grabar demostraciones realesDe 50 a 100 con lerobot-record, variando la posición de los objetos; --dataset.push_to_hub=false deja todo en local.
7–8
Entrenar y ejecutarlerobot-train --policy.type=act y lerobot-rollout en el brazo, despacio y con la parada a mano.
9–10
Corregir y medir--strategy.type=dagger para corregir; tasa de aciertos en 20 intentos: solo sintético, solo real y ambos juntos.

El brazo de la simulación todavía es el Franka Panda: el dato sintético sirve directamente para el SO-101 después de cambiar el modelo por el de MuJoCo Menagerie.
Próximos pasos

Del gemelo al brazo de verdad

Lo que ya existe y el camino para quien quiera llevarlo a lo real.

Hecho
Foto → gemelo → datos → pruebaPanda de Menagerie, generador en lazo cerrado, episodios con anotación en 4 niveles, plan de Codex probado con y sin lugares asignados, 8 pruebas.
Hecho
Episodios en formato LeRobotr2s.py exportar: 50 episodios con cámaras se vuelven un dataset que LeRobot abre y entrena (en la práctica).
Siguiente
SO-101 en la simulaciónCambiar el Panda por el brazo abierto SO-101 (Menagerie ya tiene el modelo; el kit cuesta de US$ 100 a 500) para que el dato sintético sirva directo al brazo real.
Después
Entrenar una políticaAjustar un VLA abierto (OpenVLA, pi0) con los episodios y medir en el brazo real, comparando con y sin los datos sintéticos.
Regla
Nada va a lo real sin pruebaTodo plan pasa por r2s.py provar antes de mover un motor.