El recorrido de la ruta 2: del archivo de instrucciones (la «constitución» del proyecto) a la arquitectura WAT, al protocolo MCP, a la economía de contexto y a RAG: las capas internas que separan el prototipo del sistema confiable.
Mapa de la ruta
📜 Ingeniería de CLAUDE.md
El system prompt persistente del proyecto
🔠 El Framework WAT
Workflows + Agent + Tools, a fondo
🔌 MCP por dentro
Cómo obtiene herramientas externas el agente
🧠 Contexto y tokens
No dejes que el agente «se deteriore»
🗂️ RAG y datos
Darle memoria y fuentes al agente
Cómo recorrer
Los módulos son independientes, pero el orden 2.1 → 2.5 construye capa sobre capa: instrucciones, arquitectura, herramientas, ahorro y datos.
Contenido detallado
📜 Ingeniería de CLAUDE.md
El CLAUDE.md es el system prompt persistente del proyecto: la «constitución» que el agente vuelve a leer en cada sesión. Anatomía, reglas operativas, cómo reducirlo a menos de ~500 líneas, qué va en el CLAUDE.md y qué en las skills, y cómo iterar el archivo conversando.
Un archivo Markdown en la raíz del proyecto que define el rol, el contexto y las preferencias, y que el agente lee al comienzo de cada sesión, sin que tengas que volver a explicarlo.
Es lo que da consistencia entre sesiones; si está mal escrito, el agente olvida las reglas cada vez.
Persistente; markdown; se lee en cada sesión; rol + contexto + reglas.
Las secciones típicas: quién es el agente, qué se está construyendo, reglas de operación, estilo de comunicación y estructura de carpetas del proyecto.
Un esquema claro evita archivos confusos y reglas perdidas.
Rol; contexto; reglas; estilo; estructura.
Directivas de comportamiento: buscar una herramienta existente antes de crear una nueva, aprender y adaptarse cuando algo falla, y mantener los archivos actualizados.
Son las reglas que activan el ciclo de automejora del agente.
Reutilizar antes de crear; aprender al fallar; mantener actualizado.
Limita el archivo (objetivo: menos de ~500 líneas) porque entra en el contexto en cada sesión; los archivos largos diluyen las reglas importantes.
Si el agente repite el mismo error pese a que la regla está escrita, puede que el archivo sea demasiado largo y la regla "se pierda".
Menos de ~500 líneas; solo contenido útil en todas las sesiones; conciso.
CLAUDE.md guarda solo lo que sirve para todas las sesiones (propósito, reglas, framework); las instrucciones de tareas específicas van en skills, que se cargan bajo demanda.
Poner todo en CLAUDE.md desborda la ventana de contexto; las skills ahorran espacio.
Cada sesión → CLAUDE.md; bajo demanda → skills.
El CLAUDE.md no se escribe una vez y se olvida: le pides al agente que agregue o cambie secciones («agrega una regla para mantener las explicaciones cortas»).
El archivo evoluciona con el proyecto; iterarlo es lo que lo afina.
Siempre editable; pide cambios en lenguaje natural; documento vivo.
🔠 El Framework WAT a fondo
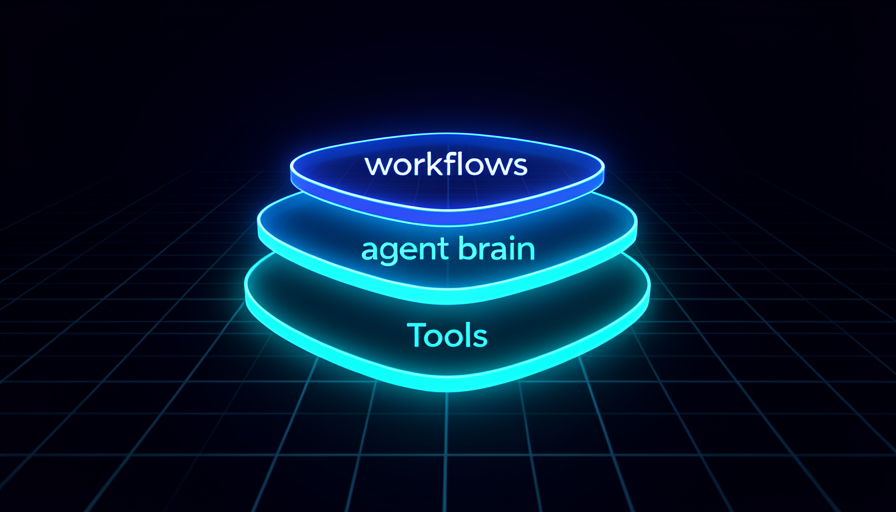
La estructura detrás de todo workflow agéntico: W = Workflows (instrucciones en markdown = SOP), A = Agent (el coordinador que decide), T = Tools (scripts para una tarea cada uno). Además, el ciclo de automejora, la estructura de carpetas y cuándo NO usar WAT.
Un patrón de tres capas —Workflows, Agent, Tools— que le da al agente un «manual + cerebro + manos». La mayoría de las construcciones agénticas encajan en este molde.
Da un vocabulario común y una forma repetible de estructurar cualquier proyecto.
W + A + T; manual + cerebro + manos; repetible.
Archivos markdown en lenguaje natural (con títulos, viñetas y negritas) que funcionan como una descripción del puesto o una SOP, e indican al agente qué hacer.
Es la capa que más editas; un buen workflow es la mitad del resultado.
Markdown; SOP; objetivo + entrada + salida + pasos.
El propio asistente de código: el cerebro coordinador que lee los workflows, ve las herramientas disponibles y decide cuál usar y cuándo, como un gerente de proyecto que delega.
Entender que el agente decide (no sigue un guion fijo) cambia la forma en que escribes las instrucciones.
Coordinador; lee y decide; delega en las tools.
Scripts (generalmente en Python) que hacen el trabajo concreto, idealmente uno por tarea (extraer datos de un sitio, generar un PDF, analizar datos). El agente los escribe y corrige: no necesitas programar.
Las tools pequeñas y enfocadas son fáciles de probar, reutilizar y reparar.
Un trabajo cada uno; se generan automáticamente; reutilizables.
El agente ejecuta un workflow, encuentra un error, lo diagnostica, corrige la tool y actualiza el archivo del workflow para que el error no se repita; las ejecuciones son más fluidas y rápidas con el tiempo.
Es el superpoder de WAT: el sistema se mejora a sí mismo mientras se ejecuta.
Error → diagnóstico → fix → workflow actualizado.
La organización recomendada: carpeta workflows, carpeta tools, carpeta temporary (archivos intermedios/salida), el archivo de entorno (.env, secretos) y el CLAUDE.md.
Una estructura clara ayuda al agente a encontrar lo que necesita y a separar los secretos del código.
workflows; tools; temporary; .env; CLAUDE.md.
Para tareas únicas, experimentación inicial o instrucciones que caben en una frase, montar la estructura WAT es exagerado: basta con escribir el pedido.
Saber cuándo NO usarlo evita la burocracia y el desperdicio de contexto.
Tarea única; one-off; no fuerces la estructura.
🔌 MCP por dentro
El protocolo que le da herramientas externas al agente. Qué resuelve, cómo el agente descubre y decide qué herramientas usar, el .mcp.json y la clave manual (nunca en el chat), project-level vs global, dónde encontrar servers, cómo verificar y diagnosticar, y el costo de contexto.
MCP (Model Context Protocol) permite que una sola conexión exponga varias herramientas/acciones, como cuando Gmail expone enviar, redactar y buscar correos electrónicos de una vez.
Es cómo la IA obtiene «brazos» sin que integres cada acción a mano.
Protocolo; una conexión = muchas herramientas; acciones expuestas.
En cuanto el agente y el server se conectan, el agente conoce todas las herramientas disponibles y decide por sí solo cuál llamar, cuándo y con qué parámetros.
Describes el resultado; la IA elige la herramienta.
Descubrimiento; decisión autónoma; parámetros.
Al instalar un server, el agente genera un .mcp.json con la configuración y un espacio para la clave de API; pegas la clave manualmente en el archivo, nunca en el chat.
Es la regla básica de seguridad de MCP: el secreto fuera de la conversación.
.mcp.json; placeholder; clave manual; nunca en el chat.
La configuración de MCP puede ser global (para toda la máquina) o a nivel de proyecto; se recomienda el nivel de proyecto para mantener aislados los secretos y el contexto.
La configuración global puede activar avisos de seguridad en cada reinicio; la configuración a nivel de proyecto lo resuelve.
Project-level; aislamiento; mover a la carpeta del proyecto.
Los servidores están en directorios dedicados (p. ej., mcp.so) o en GitHub (busca "MCP server" + nombre del servicio). Categorías comunes: scraping (Firecrawl), bases de datos (Postgres, Supabase), documentos, comunicación.
Saber dónde buscar acelera mucho el build.
Directorios; GitHub; categorías de server.
El comando /mcp muestra los servers instalados y su estado; si no aparece un server nuevo, reiniciar el asistente suele resolverlo.
Es el primer paso para solucionar cualquier problema de MCP.
/mcp; estado; reinicia primero.
Cada servidor activo inyecta las definiciones de sus herramientas en el contexto, lo que consume tokens. Desactivar los que no usas libera contexto.
Menos ruido en el contexto = menos errores y menos costo.
Las definiciones de las herramientas = tokens; desactiva las que no uses.
🧠 Contexto y tokens
No dejes que el agente «se deteriore». Context rot y la degradación después de ~60%, los umbrales (0-50 / 50-70 / 70-85 / 85%+), /clear vs /compact, una tarea por sesión, definir «listo» para evitar bucles y estrategias de ahorro.
La calidad disminuye gradualmente cuanto más larga es la sesión; los errores aparecen con más frecuencia después de ~60% de uso del contexto, cuando el historial ruidoso ahoga las reglas centrales.
Saber esto evita pelearte con un agente que solo está "cansado".
Degradación; ~60%; el ruido ahoga las reglas.
Una escala: 0-50% seguro; 50-70% amarillo (considera compactar); 70-85% naranja (ejecuta /compact); por encima de 85%, ejecuta /clear y empieza de nuevo.
Transforma el abstracto "context rot" en una acción concreta según el rango.
Verde / amarillo / naranja / rojo.
/clear borra toda la conversación (úsalo al cambiar de tarea o cuando baja la calidad); /compact genera un resumen inteligente que mantiene lo esencial y comprime el resto (úsalo a mitad de una tarea larga).
Elegir mal hace que pierdas contexto útil o conserves basura.
clear = reset; compact = resumen; cuándo usar cada uno.
Mantener cada sesión enfocada en una tarea y limpiarla antes de empezar la siguiente, en lugar de reutilizar una conversación saturada para algo que no está relacionado.
Contexto limpio = más precisión y menos tokens gastados.
Una tarea; limpiar antes; enfoque.
Darle al agente un criterio explícito de finalización (ej.: "exactamente 75 perfiles") para que se detenga en lugar de investigar sin fin.
Sin un "listo", el agente puede entrar en un bucle y gastar tokens.
Definición de terminado; criterio; evita el bucle.
Las palancas para ahorrar: usar skills (se cargan según se necesitan), desactivar los MCP que no se usan, mantener el CLAUDE.md conciso y trabajar en una tarea por sesión.
Reúne todo lo del módulo en una rutina de «higiene del contexto».
Skills; desactivar MCP; CLAUDE.md conciso.
🗂️ RAG y datos
Darle memoria y fuentes al agente. El problema (la IA no sabe lo que no está en el contexto), system prompt vs vector store, embeddings & vector store en lenguaje sencillo, el indexador, el classifier que enruta antes de consumir recursos del agente, y confidence score & fallback.
Un modelo solo responde sobre lo que está en el contexto o en el entrenamiento. Para responder sobre tus documentos (políticas, preguntas frecuentes), debes poner esa información a su alcance.
Es el «porqué» de RAG: sin una fuente, la IA inventa o se equivoca.
Fuera del contexto = invisible; fundamenta en una fuente.
System prompt inserta el texto directamente (sencillo y económico para pocos documentos); vector store busca solo los fragmentos relevantes (escalable, mejor para crecer).
Elegir mal consume contexto o limita el crecimiento.
Incrustar o buscar; pequeño o escalable.
Los embeddings transforman texto en números que capturan el significado; el vector store guarda esos números y busca por similitud de significado, no por palabras exactas.
Es el motor que hace que la búsqueda «entienda» la pregunta.
Significado en números; búsqueda por similitud.
Un workflow separado que lee los documentos, los divide en fragmentos, genera embeddings y llena el vector store; se ejecuta una vez (o cuando se actualiza la base).
Separar la indexación de la consulta es el patrón de arquitectura de RAG.
Trigger manual; loader/splitter; llenar el store.
Un nodo clasificador decide pronto si la entrada es relevante (p. ej., una pregunta de soporte o no) y la enruta: solo lo importante llega al agente costoso.
La clasificación económica antes del agente ahorra tokens y evita respuestas fuera de alcance.
Clasificación; enrutamiento; solo pasa lo relevante.
Cuando la búsqueda no encuentra algo relevante, el agente emite un marcador de "no encontré" y recurre a una alternativa (p. ej., "vamos a investigar y volver") en lugar de inventar.
Un agente honesto que se niega a inventar es un resultado deseado, no un bug.
Marcador de confianza; fallback; no alucinar.