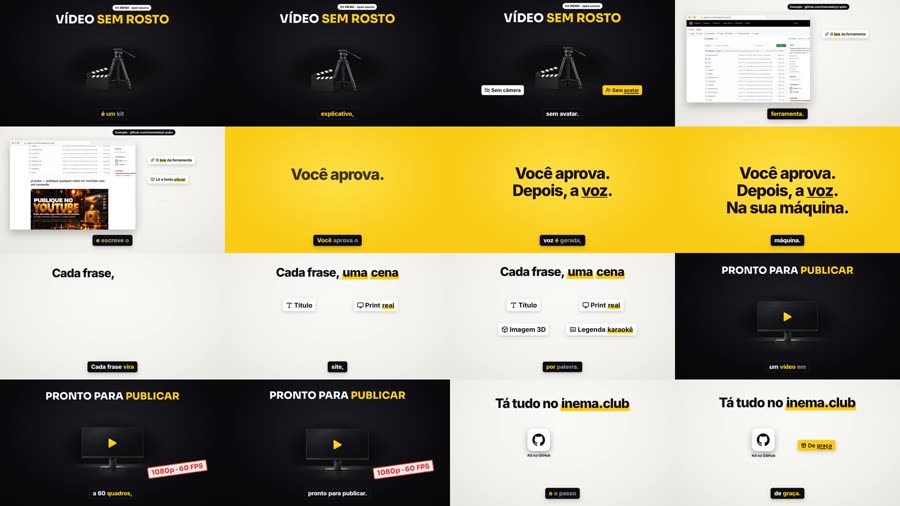
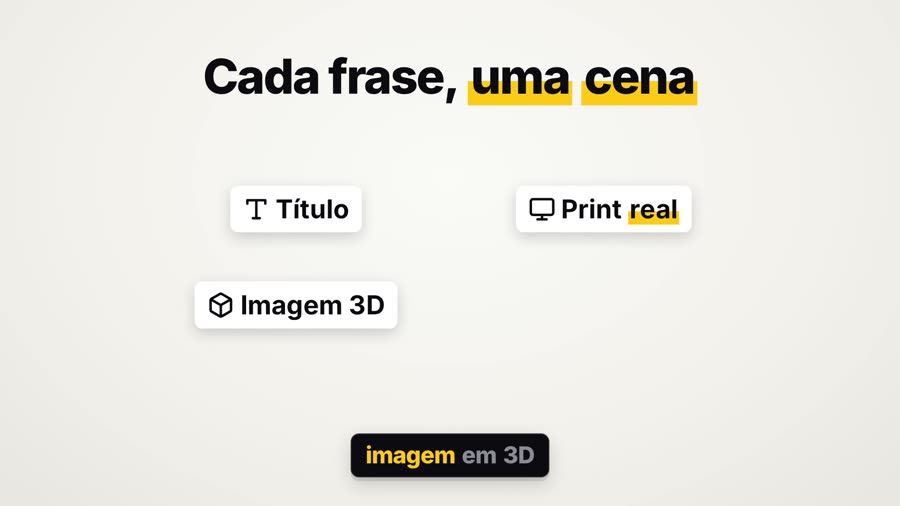
Você passa o link de uma ferramenta. O agente pesquisa, escreve o roteiro, você aprova, e cada frase vira uma cena com print real, imagem 3D e legenda palavra por palavra.

O video-sem-rosto é um kit (uma "skill") que ensina o Claude Code a fazer vídeos explicativos na horizontal sem gravar nada: sem câmera, sem avatar. Serve para quem quer explicar uma ferramenta, um repositório ou uma novidade em vídeo sem aparecer e sem pagar serviço de voz. A voz é gerada no seu computador com uma voz clonada, e as cenas mostram a página real do site, imagens 3D e legenda sincronizada. Para usar, você precisa do Claude Code, ffmpeg, Python e do inemavox (que faz a voz e a transcrição) rodando na máquina.
Cada cena é uma página HTML animada no tempo exato da fala. O Chromium avança quadro a quadro e o ffmpeg monta o vídeo.
Chatterbox gera cada frase com a voz clonada; o Whisper local ouve, compara com o roteiro e manda gerar de novo a frase que saiu errada. Nenhuma API paga.
O capture.py abre a página, acha o texto que a voz cita e devolve a posição dele, para o zoom e o anel caírem exatamente ali.
Nada é gerado antes do roteiro aprovado. No fim, o qc.py confere 1920x1080, 60 fps, bitrate, −14 LUFS e quadros pretos, e monta uma folha para olhar.
Voz, imagens e prints rodam em paralelo. As cenas são escritas lendo o tempo de cada palavra no words.json.
reel (papel ↔ preto, chips, 3D), cinema (imagem real primeiro, letterbox) e ledger (notas de versão, contadores). Alterne entre vídeos.
Preto #0c0c10, papel claro, amarelo #FACC15, títulos Sora e corpo Inter, aplicados nos três looks. FV_THEME=original volta à paleta creme/laranja.
Só a voz, a −14 LUFS, e uma trilha opcional baixa. Sem whoosh nos cortes (FV_WHOOSH=1 liga, se quiser).
O setup.sh confere tudo e para com a mensagem do que falta.
Motor das cenas e encode do vídeo.
# Ubuntu sudo apt install python3-venv ffmpeg
Projeto aberto do INEMA que traz o worker do Chatterbox e um venv com faster-whisper. O kit usa os dois por caminho (INEMAVOX_DIR muda o local).
git clone https://github.com/inematds/inemavox ~/projetos/inemavox cd ~/projetos/inemavox && python3 -m venv venv venv/bin/pip install faster-whisper soundfile numpy
Modelo aberto de voz que clona a voz de um áudio curto. Roda num ambiente conda próprio (CHATTERBOX_PYTHON muda o caminho).
# Miniconda (se não tiver): https://docs.anaconda.com/miniconda/ — instala em ~/miniconda3 # outro lugar: export CHATTERBOX_PYTHON=.../envs/chatterbox/bin/python3 conda create -n chatterbox python=3.11 -y ~/miniconda3/envs/chatterbox/bin/pip install chatterbox-tts soundfile
10 segundos de fala limpa, sem música, em .wav 24 kHz mono. Grave com o celular e converta:
ffmpeg -i gravacao.m4a -ss 2 -t 10 -ac 1 -ar 24000 ~/minha-voz.wav echo 'export FV_VOICE=~/minha-voz.wav' >> ~/.bashrc && source ~/.bashrc
É quem segue o SKILL.md: pesquisa, escreve roteiro e cenas, roda os scripts.
claudeGera as imagens 3D pela assinatura do ChatGPT (sem API): npm i -g @openai/codex e codex login. Sem ele: FV_IMG=flux se você tiver um servidor flux2-klein local, ou faça o vídeo só com prints, logos e ícones.
codex loginVoz e Whisper rodam bem mais rápido em GPU; os dois caem para CPU se precisar.
nvidia-smiWhisper: modelo que transcreve fala; aqui ele ouve cada frase para medir se saiu certa e marcar o tempo de cada palavra. LUFS: medida de volume percebido; −14 é o padrão do YouTube. Folha de contato (stills): uma imagem com vários quadros do vídeo, para conferir tudo de uma vez. Look: o estilo visual do vídeo — reel (padrão), cinema (imagem real em tela cheia, faixas pretas de cinema) ou ledger (cara de notas de versão); escolha com Video(job, look="cinema"). flux2-klein: gerador de imagem que roda local; o kit chama em localhost:8000 (FV_FLUX_URL) só se você tiver esse servidor.
Na 1ª execução o Whisper large-v3 (~3 GB) e o Chatterbox baixam os pesos dos modelos. Se o Playwright reclamar de biblioteca do sistema: sudo .venv/bin/python -m playwright install-deps chromium.
Use TMPDIR=$(mktemp -d /tmp/fv.XXXX) na frente do render e da captura: o Chromium aborta se o caminho temporário for longo demais.
Cria o .venv do projeto (Playwright + Pillow), confere voz e Whisper e liga a skill em ~/.claude/skills/video-sem-rosto.
git clone https://github.com/inematds/video-sem-rosto ~/projetos/video-sem-rosto cd ~/projetos/video-sem-rosto && bash setup.sh # tem que terminar com SELFTEST PASS
O PROFILE.md guarda voz, chamada para ação, visual e palavras proibidas; a skill lê antes de cada vídeo. Ele vem com o perfil do INEMA (chamada para o inema.club, publicação pelo yt-pubx, avisos no bot): troque nome, chamada, canal e regras pelos seus. Os passos de publicação do SKILL.md que citam ferramentas do INEMA são opcionais.
nano PROFILE.md # seu nome, sua voz, sua chamada (~3:00 e no fim), seu canal
O agente pesquisa a fonte oficial, escreve script.txt e o roteiro com tempos, e para esperando sua aprovação. Depois do seu "ok", ele mesmo roda os passos 4 a 7; os comandos abaixo servem para rodar à mão ou entender o que acontece.
faz um vídeo sem rosto sobre https://github.com/dono/projeto — uns 8 minutos, me mostra o roteiro antes
Para rodar sem o agente, comece pelo exemplo de ~40 s (ele traz a marca INEMA no texto das cenas: troque no job.py). O tts.py lê $P/script.txt e gera vo.mp3, words.json e vo_qc.json (semelhança de cada frase).
P=~/videos/teste; mkdir -p $P/{img,cap} cp templates/exemplo_30s.py $P/job.py && cp templates/exemplo_30s.txt $P/script.txt python3 scripts/tts.py $P # usa FV_VOICE; FV_LANG=pt
c_ = fundo claro, d_ = escuro; um objeto por imagem. O print devolve um .json com a caixa de cada texto pedido.
python3 scripts/images.py $P/img d_clap="a film clapperboard beside an empty tripod" d_monitor="a widescreen monitor with a play button" TMPDIR=$(mktemp -d /tmp/fv.XXXX) .venv/bin/python scripts/capture.py https://github.com/inematds/yt-pubx $P/cap/gh.png "README"
O job.py do exemplo usa img/d_clap.png, img/d_monitor.png e cap/gh.png (gerados no passo 5). Os tempos das cenas são os da voz do exemplo: com a sua voz, ajuste os v.scene(início, fim, …) lendo o words.json. Vídeo longo: templates/job_full_template.py. Primeiro a folha de cenas, depois o render.
TMPDIR=$(mktemp -d /tmp/fv.XXXX) .venv/bin/python $P/job.py stills # out/stills.jpg TMPDIR=$(mktemp -d /tmp/fv.XXXX) .venv/bin/python $P/job.py # out/video-sem-rosto-teste.mp4
Confere tamanho, fps, bitrate, volume e quadros pretos; sai com erro se algo reprovar e grava uma folha de 16 quadros.
python3 scripts/qc.py $P/out/video-sem-rosto-teste.mp4
Voz local, tema INEMA, 1080p60, −14,3 LUFS. Baixe os dois em 1080p60 na release 1.0.1.
Abaixo: a folha de contato e um quadro do exemplo 1.

qc.py: papel ↔ preto, cartão amarelo, print real, legenda karaokê.
O kit já faz o vídeo inteiro. Os próximos passos são de integração com o que o INEMA já usa.
script.txt, gerar a voz em FV_LANG=en|es e reaproveitar as cenas.