🧭 Entiende «agentic»: un agente con herramientas y criterio
"Agentic" describe una forma de usar un modelo, no una arquitectura. Describes el objetivo, le das un conjunto de herramientas (búsqueda, terminal, editor de archivos) y dejas que el modelo decida, paso a paso, qué hacer a continuación. No hay un diagrama previo del camino: el camino se descubre en tiempo real, dentro de la propia conversación.
🆕 ¿Nuevo aquí? Dos palabras antes de seguir
- Juicio del modelo: la decisión de "qué hacer ahora" ocurre dentro de la cabeza del modelo, token a token: no existe una línea de código que diga "después de esto, haz aquello".
- Prueba de salida: una condición explícita y verificable que indica cuándo terminó el trabajo (p. ej., «las pruebas pasaron»). Un sistema puramente agentic rara vez tiene una; se detiene cuando el modelo «cree» que terminó.
Esto no es un defecto, es la característica. Sirve justamente para tareas abiertas y exploratorias —"investiga este bug extraño", "lee este repositorio y cuéntame qué hace"—, cosas que se ejecutan una vez y en las que no sabes de antemano qué pasos vas a necesitar. Intentar dibujar el diagrama de flujo antes sería una pérdida de tiempo: todavía no sabes cuál será el flujo.
✓ Agentic funciona bien cuando
- ✓La tarea es exploratoria: no sabes los pasos de antemano
- ✓Se ejecuta una vez o pocas veces, bajo supervisión humana
- ✓El costo de un paso equivocado es bajo y reversible
✗ Agentic sale caro cuando
- ✗La tarea se repite todos los días: siempre vuelves a explicar el mismo objetivo
- ✗Necesita la garantía de que «esto siempre va a ocurrir en este orden»
- ✗Nadie puede predecir el costo de tokens porque el camino cambia en cada ronda
Conceptos clave
Vive en la cabeza del modelo
Tú lo proporcionas, él decide si usarlo
Ruta descubierta en el momento
Se ejecuta una vez, de forma exploratoria
🔁 Entiende «loop»: el ciclo diseñado con una prueba de salida
En el loop dejas de escribir prompts y empiezas a diseñar ciclos. En vez de confiar en que el modelo recordará verificar su propio trabajo, lo escribes en código: descubrir → planear → actuar → verificar → detenerse. La estructura sale de la cabeza del modelo y se convierte en algo que puedes leer, versionar y probar.
💡 La condición de parada es lo que lo cambia todo
Un loop solo se convierte en un loop de verdad cuando existe un prueba de salida explícito — algo que tú puedes ejecutar y que responde sí/no: "las pruebas pasaron", "el schema se validó", "la nota del revisor es mayor que 8". Sin esta prueba, solo tienes un agentic con una vuelta más.
- •El modelo todavía decide qué hacer dentro de cada etapa, pero ya no decide el orden de las etapas
- •Ganas reproducibilidad: el mismo proceso se ejecuta igual el lunes y el viernes
- •Pagas con ingeniería: alguien tiene que escribir y mantener este ciclo
Sirve para tareas repetibles con un criterio de éxito verificable: generar un informe cada mañana, corregir un bug hasta que las pruebas pasen, escribir un texto hasta que cumpla una lista de calidad. Si ejecutas lo mismo más de una vez y sabes decir cuándo salió bien, el loop es la estructura adecuada.
Conceptos clave
Descubrir/planificar/actuar/verificar/parar
Condición verificable, no «a ojo»
Sale de la cabeza y se convierte en un artefacto
Se ejecuta cada vez, con un criterio claro
🕸️ Entiende «graph»: loops compuestos con aristas explícitas
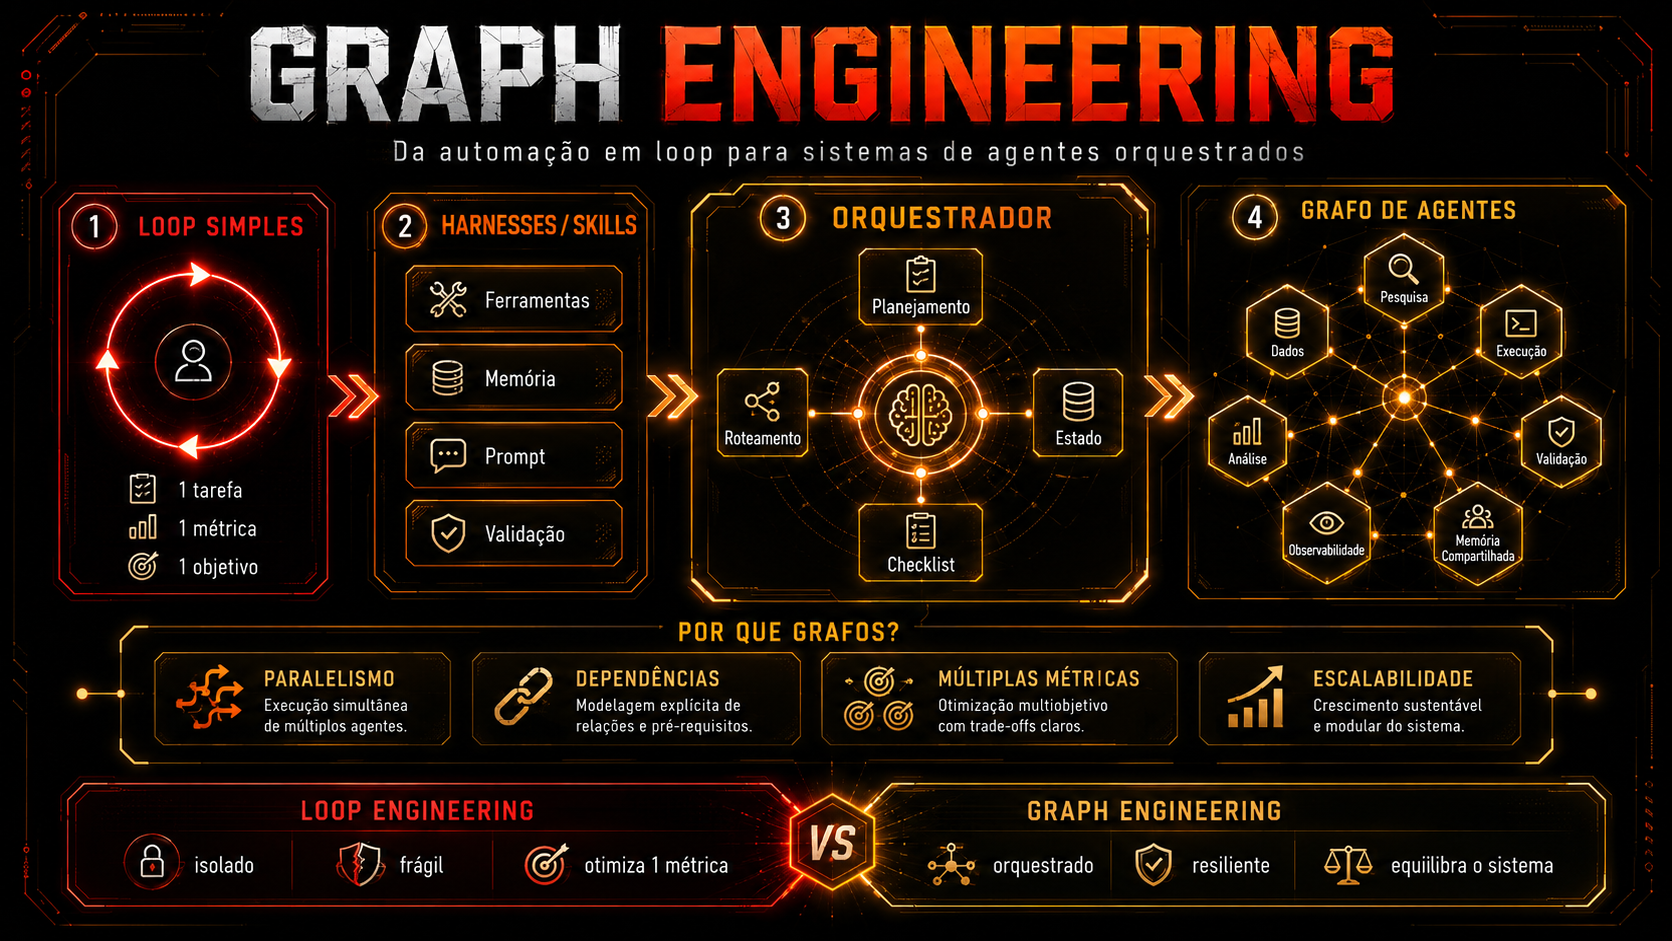
Un grafo (en este sentido de arquitectura de agentes) son varios loops conectados por aristas escritas antes de ejecutar. Cada nodo del grafo es, por sí mismo, un loop, con su propio modelo, sus propias herramientas, sus propios permisos y su propia instrucción. El camino entre los nodos y lo que agrega el grafo.
Qué observar: el cuadro punteado es nuevo, pero el contenido de adentro no lo es: cada nodo todavía tiene su propia vuelta (el "loop" escrito dentro de él). El grafo no reemplaza el loop, lo compone bucles. Y lo que el siguiente tema va a construir con un caso real.
Conceptos clave
Cada nodo tiene su propio ciclo
El camino existe antes de ejecutarse
Modelo, herramientas y permisos propios por nodo
El grafo compone el loop, no lo reemplaza
📰 Construye el mismo caso en los tres formatos
El caso es un resumen diario de investigación: cada mañana el sistema lee algunas fuentes sobre un tema, escribe un resumen de una página y verifica que sea correcto antes de enviarlo. Vamos a construir ese mismo objetivo tres veces y comparar qué pasa en cada versión.
Como bucle único sobrecargado
Un agente hace todo en una sola ventana: busca fuentes, escribe, revisa.
Abre las fuentes una por una: porque loop es secuencial por definición — y vuelca el HTML sin procesar de cada una en el mismo contexto (la ventana de texto que el modelo está "viendo" en ese momento). Cuando llega la hora de revisar, ese contexto se volvió un pantano: HTML crudo, prosa a medio escribir y razonamiento anterior, todo flotando junto. Y lo peor: revisa en el mismo contexto donde escribió, así que tiende a aprobar su propio trabajo.
Como grafo pequeño
Tres nodos, estado que fluye entre ellos, cada uno con su propio contexto.
Investigador se abre en N fuentes en paralelo — esto es fan-out: abrir una tarea en varias ramas al mismo tiempo. Entrega solo las notas (no el HTML sin procesar) a escritor, que recibe un contexto limpio — sin el ruido de la búsqueda, solo lo que importa para escribir. El escritor le entrega el borrador al revisor, que también tiene contexto nuevo: solo ve el texto y el criterio de calidad, con una arista de regreso «reprobado» hacia quien escribe si no pasa.
Qué observar: tres cosas cruzan las aristas — notas, borrador e críticas — y ninguna de ellas es el HTML sin procesar de las fuentes. Eso es lo que distingue la versión con grafo de la versión de loop único: cada nodo recibe solo lo que necesita, nunca la transcripción completa del nodo anterior. (Transcripción = el historial completo de una conversación/ejecución, con todo el razonamiento intermedio — útil para depurar, demasiado pesado para pasarlo como entrada.)
| Dimensión | agentic | loop | graph |
|---|---|---|---|
| Quién decide el siguiente paso | el modelo, en cada token | el modelo, dentro de un ciclo fijo | el modelo, dentro de cada nodo; el enrutamiento entre nodos es fijo |
| Dónde está la estructura | en la cabeza del modelo | en código, un ciclo | en código, un diagrama de nodos y aristas |
| Paralelismo | ninguno nativo | ninguno: el bucle es secuencial por su forma | fan-out/fan-in de primera clase |
| Contexto | una sola ventana, crece sin límite | una ventana alrededor del ciclo | un contexto limpio por nodo |
| Cómo depuras | leyendo el transcript entero | leyendo el transcript de cada vuelta | leyendo el diagrama + el estado en cada arista |
| Costo de mantenimiento | bajo (solo el prompt) | medio (ciclo + condición de parada) | alto (N prompts + esquema de estado + enrutamiento) |
| Cuándo usar | tarea abierta, se ejecuta una vez | tarea repetible, basta con un agente | tarea repetible que necesita especialización/paralelismo real |
Conceptos clave
Resumen diario en los tres formatos
Abrir 1 tarea en N ramas
Cada nodo ve solo lo que necesita
Un fallo devuelve el proceso al escritor
✨ Descubre lo genuinamente nuevo que aporta el grafo
Son tres cosas concretas, no una sensación de «más avanzado». Primero: nodos paralelos especializados con contextos limpios y separados — el investigador no arrastra el vocabulario del revisor, el revisor no arrastra el ruido de la búsqueda. Segundo: fan-out y fan-in como movimiento de primera clase — abrir una tarea en N ramas, ejecutarlas al mismo tiempo y reunir el resultado. Tercero: flujo de control explícito y auditable — el camino es un diagrama que puedes leer, no algo que reconstruyes leyendo un transcript de 40 mil tokens.
Qué observar: los dos lados resuelven "hacer más cosas" de maneras opuestas. El loop crece para bajo — más vueltas en el mismo nodo. El grafo crece para afuera — más nodos ejecutándose al mismo tiempo. No se puede hacer un fan-out real dentro de un único loop; solo sabe repetir, no dividir.
Conceptos clave
Contexto limpio y separado
Volver a unir las N ramas
Diagrama que se puede leer, no reconstruir
El grafo crece hacia afuera; el loop, hacia abajo
💸 Descubre qué cuesta el grafo
Nada de esto es gratis. Pasas a mantener tres prompts en vez de uno — cada nodo tiene su propia instrucción, y las tres tienen que evolucionar juntas sin romper las aristas entre ellas. Necesitas definir un esquema de estado: el formato exacto de lo que el investigador le entrega al escritor y de lo que el escritor le entrega al revisor. Sin este contrato escrito, los nodos empiezan a discrepar sobre qué significan «notas» o «borrador».
⚠️ Modos de falla que solo existen en el grafo
- Merge que se traga una fuente en silencio — el fan-in junta 5 ramas, una falló y nadie se dio cuenta de que faltaba una fuente en el resumen final.
- Enrutamiento que va y vuelve para siempre — la arista «reprobado» devuelve al escritor, que vuelve a escribir y vuelve a ser reprobado, sin límite de intentos.
- Estado que se filtra de un nodo a otro — el contexto que debería estar limpio arrastra basura del nodo anterior porque no se respetó el state schema.
✓ La sobrecarga aporta calidad cuando
- ✓La tarea se ejecuta todos los días: el costo fijo de armar el grafo se compensa con las repeticiones
- ✓Hay paralelismo real que aprovechar (N fuentes, N ramas)
- ✓Especializar cada nodo realmente mejora el resultado (revisor con criterio propio)
✗ La sobrecarga es un puro impuesto cuando
- ✗La tarea se ejecuta una vez: nunca recuperas el costo de armar tres prompts
- ✗No hay nada que paralelizar — es un proceso genuinamente secuencial
- ✗Un solo nodo, con todas las herramientas y todas las instrucciones: eso es un loop reinventado; la estructura de grafo no está haciendo nada
🧪 Ejemplo práctico: grafo degenerado vs. grafo de verdad
Objetivo: comparar lo mismo grafo.json del daily brief en dos formatos —el «grafo de un solo nodo» (nombre de grafo, cuerpo de loop) y el de tres nodos (grafo de verdad)— y ver la diferencia en el propio archivo.
// grafo.json — VERSAO DEGENERADA (1 no, todas as ferramentas, todas as instrucoes)
{
  "nodes": [
    { "id": "faz-tudo", "model": "<seu-modelo>",
      "tools": ["buscar", "escrever", "revisar"],
      "prompt": "Busque as fontes, escreva o resumo e revise ate ficar bom." }
  ],
  "edges": []
}
// isto NAO e um grafo funcional — e um loop com nome de grafo.
// zero arestas = zero coisa que a estrutura de grafo esta fazendo.

// grafo.json — VERSAO DE TRES NOS (grafo de verdade)
{
  "nodes": [
    { "id": "pesquisador", "model": "<modelo-rapido>", "tools": ["buscar"],
      "prompt": "Para cada fonte em paralelo, extraia so os fatos relevantes ao tema." },
    { "id": "escritor", "model": "<modelo-de-escrita>", "tools": [],
      "prompt": "Com base APENAS nas notas recebidas, escreva um resumo de 1 pagina." },
    { "id": "revisor", "model": "<modelo-critico>", "tools": [],
      "prompt": "Compare o rascunho com as notas originais. Aprove ou reprove com criticas especificas." }
  ],
  "edges": [
    { "from": "pesquisador", "to": "escritor", "carrega": "notas" },
    { "from": "escritor", "to": "revisor", "carrega": "rascunho" },
    { "from": "revisor", "to": "escritor", "quando": "reprovado", "carrega": "criticas", "limite_voltas": 2 }
  ]
}
Cómo verificar: cuenta los edges.
Si la versión «grafo» de tu proyecto tiene cero aristas o un único nodo con todas las herramientas, es la versión degenerada: un bucle disfrazado. Si tiene aristas con carrega definido (lo que pasa de un nodo al otro),
es un grafo de verdad.
Prueba de sesgo: pídele a Claude Code que evalúe una tarea tuya
y diga si merece agentic, loop o graph — exigiéndole que justifique por qué las otras dos no sirven.
Si responde «grafo» a una tarea que se ejecuta <uma vez so>, eso es sesgo por la moda.
Pide el costo de mantenimiento: cuántos prompts, qué esquema de estado, qué nuevo modo de falla está suponiendo.
Verificación rápida (no bloquea nada): tienes un grafo con UN solo nodo que tiene todas las herramientas y todas las instrucciones del proceso. ¿Qué es realmente?
Conceptos clave
El contrato entre nosotros
Uno por nodo, evolucionando juntos
Merge, bucle de enrutamiento, fuga
1 nodo con todo = ciclo disfrazado
📌 Resumen del módulo
Próximo módulo:
3.3 — Mito y realidad: separando lo que promete el graph engineering de lo que realmente ofrece.