🏛️ Separa el organigrama del trabajo
Dos grafos conviven en el mismo sistema de agentes, y no son el mismo grafo. El org graph y es la estructura que permanece: agentes de larga duración con roles definidos —investigador, escritor, validador, publicador—, cada uno a cargo de un dominio, con memoria acumulada y aristas estables que solo cambian cuando tú vuelve a desplegar el sistema.
Piensa en él como el organigrama de la empresa, solo que cada cuadro es un agente que ejecuta su propio loop. El org graph responde «quién existe y qué hace cada uno», no «qué estamos haciendo ahora». Esa segunda pregunta corresponde a otro grafo, que verás en el próximo tema.
🆕 ¿Nuevo aquí? Cuatro palabras antes de seguir
- Org graph: la estructura estable de agentes de larga duración: el organigrama. Solo cambia cuando vuelves a implementar el sistema.
- Work graph: el grafo armado para una tarea específica. Se crea, se ejecuta y se descarta.
- Redeploy: reimplementar — publicar una nueva versión del sistema. Es el único momento en que cambia el org graph.
- Determinista: mismo input, siempre el mismo output. Lo opuesto a «depende de la suerte del modelo ese día».
Qué observar: la línea divisoria punteada del medio no separa dos sistemas: separa dos perspectivas del mismo sistema. Fíjate en que «investigador» y «validador» aparecen en ambos lados: son los mismos agentes. A la izquierda, ves todas las relaciones posibles entre ellos (el organigrama). A la derecha, ves solo el recorrido específico que esta tarea de hoy realmente siguió: un subconjunto, armado en el momento.
✓ Es un org graph cuando
- ✓El agente tiene un nombre y un papel fijos, no cambia de tarea en tarea
- ✓Acumula memoria: sabe cosas que aprendió en ejecuciones anteriores
- ✓La arista representa «puede pedirle a» — una relación a largo plazo
✗ No es un grafo organizacional cuando
- ✗Estás diseñando los pasos de una única tarea: eso es work graph
- ✗La «estructura» cambia cada vez que llega una solicitud diferente
- ✗No hay memoria acumulada, solo el contexto de esa ejecución
Conceptos clave
El organigrama, estable
Agente con rol definido
Aprende entre ejecuciones
No cambia en runtime
📋 Construye el work graph del pedido de hoy
O work graph y es efímero: se arma para una tarea específica y se descarta después. Cambia con cada ejecución: hoy pide investigador y validador, mañana solo pide al escritor y después pide a los cuatro en fila. No existe «el» work graph del sistema; existe un work graph nuevo para cada solicitud que llega.
💡 La confusión más común de un sistema desordenado
Confundir los dos grafos es la causa más común de un sistema desordenado. Hay quienes recrean toda la organización en cada solicitud: crean un agente nuevo, redefinen los roles y rediseñan la estructura cada vez que llega un pedido. Y hay quienes hacen lo contrario: encasillan la tarea en el organigrama y tratan cada variación del pedido como si tuviera que convertirse en un agente nuevo y permanente.
- •Recrear la organización en cada solicitud = caro, lento, y pierdes la memoria acumulada que hacía bueno al agente.
- •Encorsetar la tarea en el organigrama = el sistema se vuelve rígido, incapaz de atender una solicitud que no siga el guion previsto.
Llega una solicitud
Un usuario o sistema externo activa una tarea. El work graph todavía no existe.
El enrutador elige quién participa
Revisa el org graph disponible y selecciona un subconjunto de agentes para esta tarea específica.
Work graph se ejecuta y termina
El camino específico de la tarea se ejecuta de principio a fin, entrega el resultado y se descarta.
Org graph permanece intacto
Los agentes que participaron siguen existiendo, listos para el próximo work graph, con la memoria que acumularon.
Conceptos clave
Efímero, uno por solicitud
Nace, se ejecuta, desaparece
Usa solo parte del grafo de la organización
Confundirlo con el organigrama
🛡️ Aplica zone defense
Zone defense y es el patrón que hace que el org graph valga la pena: cada agente está a cargo de un dominio, con contexto persistente. El de seguridad se ocupa de la autenticación, los permisos y los registros de auditoría. El de datos se ocupa del esquema, las migraciones y los patrones de consulta. El de API se ocupa de los endpoints, los límites de tasa y los contratos. El de frontend se ocupa de los componentes, el estado y los patrones de interfaz.
Cada uno ejecuta su propio loop dentro de la zona. Una solicitud de una zona a otra pasa por el work graph — nunca directamente. Ningún agente se filtra al contexto del otro. Eso es lo que hace que el agente de larga duración acumule valor de verdad: un agente de seguridad que ya revisó 300 cambios conoce implícitamente el modelo de amenazas de ese código, sin necesidad de volver a explicarlo en cada solicitud.
📊 Las cuatro zonas clásicas
- Seguridad — autenticación, permisos, registros de auditoría
- Datos — esquema, migraciones, patrones de consulta
- API — endpoints, límites de tasa, contratos
- Frontend — componentes, estado, patrones de interfaz
🆕 ¿Nuevo aquí? Defensa en zona
Zone defense: término tomado del deporte: cada jugador cubre una zona del campo, no a una persona específica del equipo adversario. En graph engineering, cada agente cubre un dominio del sistema, no una tarea específica. Defiende toda la zona, tarea tras tarea.
✓ La defensa por zonas funciona cuando
- ✓El dominio tiene una frontera clara (datos no es API, API no es frontend)
- ✓Los pasos entre zonas se convierten en una arista explícita en el work graph
- ✓Cada agente acumula contexto real (historial de decisiones, no solo instrucciones)
✗ La defensa por zonas falla cuando
- ✗Un agente lee o escribe directamente en el contexto de otra zona (filtración)
- ✗Las zonas se superponen: dos agentes «dueños» del mismo dominio
- ✗Una zona se queda sin dueño y se convierte en tierra de nadie
Conceptos clave
Un responsable por dominio
No se reinicia en cada tarea
Paso = arista explícita
La experiencia acumulada cuenta
🔀 Haz fan-out y fan-in de verdad
Fan-out y abrir una tarea en N ramas que se ejecutan al mismo tiempo. Fan-in y reunir los N resultados en uno solo. Es algo que un loop simplemente no hace, porque su forma es secuencial: un loop procesa una cosa a la vez, siempre.
La unión es donde reside el peligro. Una fusión mal hecha se traga una rama en silencio, y el resultado parece completo aunque le falte una parte. Por eso, toda unión necesita comprobar cardinalidad: ¿recibí los N que despaché?
🆕 ¿Nuevo aquí? Fan-out, fan-in, cardinalidad
- Fan-out: un nodo envía trabajo a varias ramas paralelas al mismo tiempo.
- Fan-in: las ramas paralelas convergen de nuevo en un único nodo de unión.
- Cardinalidad: el conteo: cuántos elementos salieron y cuántos volvieron. Si enviaste 5 y recibiste 4, la cardinalidad no coincide.
Qué observar: cuatro ramas pulsantes llegan limpias a la unión; la quinta, marcada con una X roja, nunca llega. Si la unión no cuenta cuántas ramas se enviaron y cuántas se recibieron, aceptará «recibí 4 de 5» como si fuera un resultado completo. Eso es la combinación que se traga una fuente — el resultado parece listo y nadie se da cuenta de que falta una parte.
⚠️ Atención: unión sin verificación de cardinalidad
Cada vez que escribas una convergencia, pregúntate explícitamente «¿cuántos esperaba?» antes de seguir. Si la respuesta no coincide con lo que llegó, detente y resuelve el caso: no dejes que el grafo de trabajo siga como si estuviera completo. Una rama que falla en silencio es peor que una rama que falla haciendo ruido.
Conceptos clave
Un nodo se convierte en N ramas
N ramas se convierten en un nodo
¿Recibí los N que envié?
Merge que se traga algo en silencio
🚦 Enruta según la condición
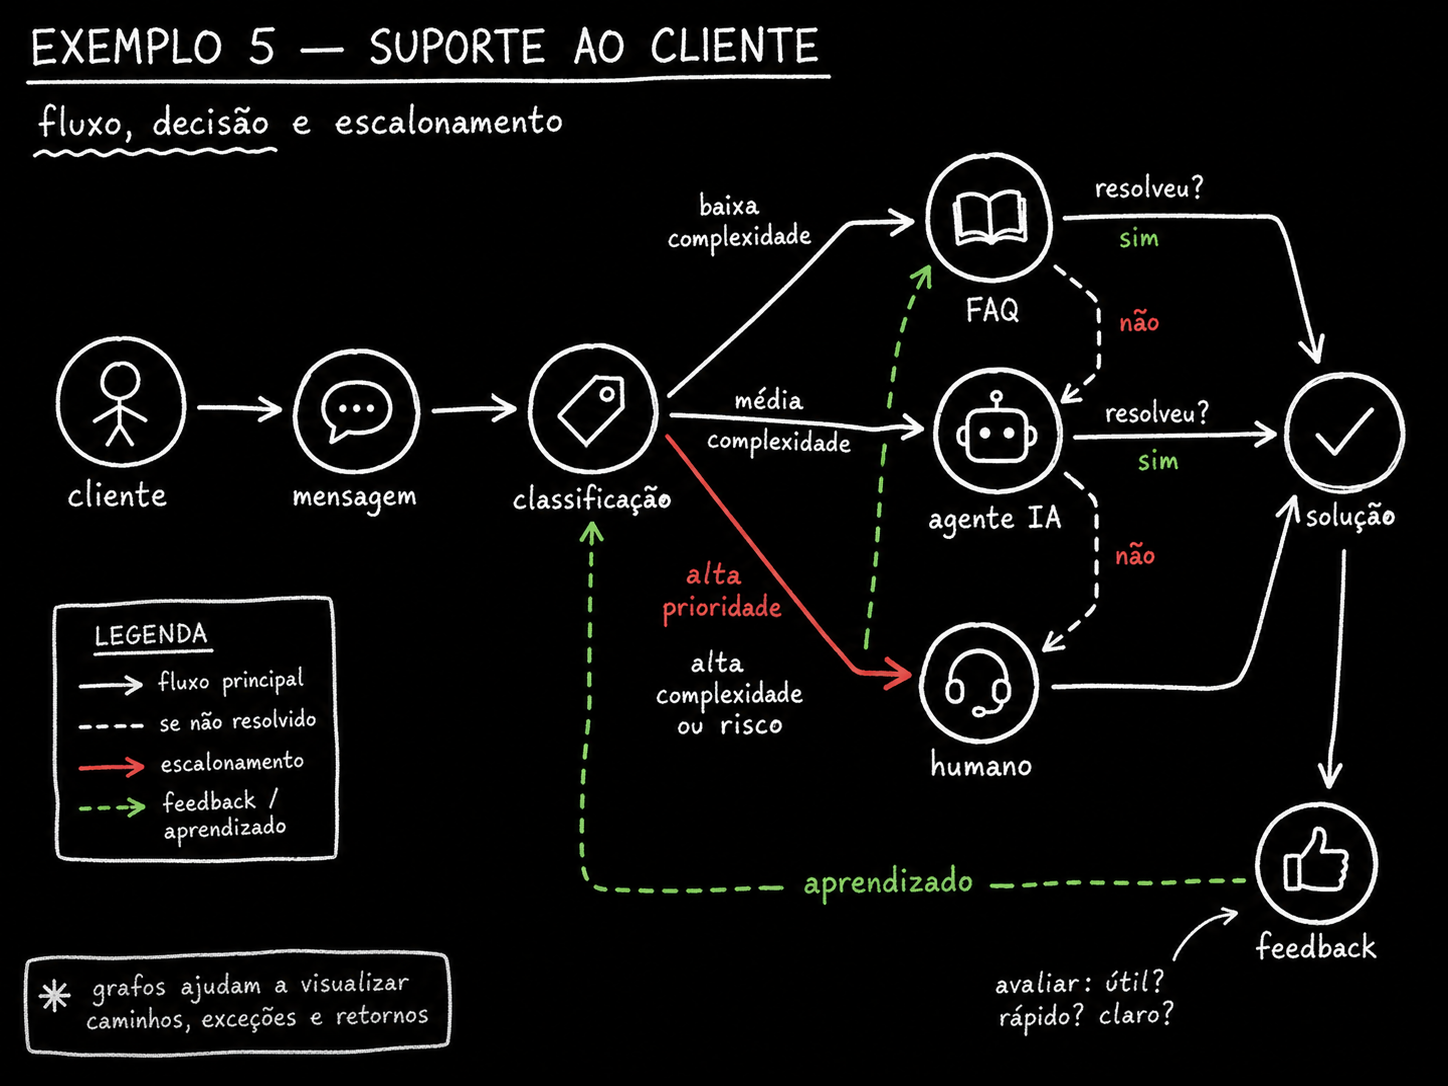
En el enrutamiento por condición, la arista elige el destino según el resultado del nodo anterior. Es el mecanismo que hace que el work graph «decida» sin que un agente tenga que interpretar todo de nuevo en cada paso. El ejemplo clásico es el soporte al cliente.
La complejidad baja va a la base de respuestas preparadas (FAQ). La complejidad media va al agente de IA. La complejidad alta o arriesgada se escala directamente al humano. También están la arista «no lo resolvió» (devuelve al siguiente nivel) y la arista de aprendizaje (vuelve al clasificador con los comentarios).
🎯 Por qué la arista de aprendizaje importa más de lo que parece
Las tres primeras aristas (principal, si-no-se-resuelve, escalamiento) hacen que el sistema funcionar hoy. Solo la arista verde hace funcionar el sistema mejor mañana — porque es la única que devuelve información al nodo que decide. Sin ella, el clasificador se equivoca siempre de la misma manera; con ella, cada corrección humana se convierte en una señal para el siguiente enrutamiento.
Conceptos clave
La arista elige según el resultado
El riesgo alto va directamente a una persona
Sube al siguiente nivel
Única arista que cierra el ciclo
⚙️ Deja que el código decida lo que es previsible
El modelo enruta lo que un if resolverlo es caro, lento y no determinista.
La división que funciona: el código controla el enrutamiento predecible; el modelo se encarga de los pasos que requieren interpretación
o criterio. Cada arista que puedas convertir en una regla escrita es una arista que deja de costar tokens
y de variar entre ejecuciones.
✓ Déjaselo al código
- ✓"Si complejidad == baja, va a FAQ" — regla explícita, sin ambigüedad
- ✓"Si la cardinalidad no coincide, detente y alerta" — comprobación mecánica
- ✓"Si categoría == pago, va al agente financiero" — mapeo fijo
✗ Déjaselo al modelo
- ✗"¿El tono del mensaje sugiere frustración?" — requiere interpretación, no una regla
- ✗"¿Esta respuesta realmente responde la pregunta?" — evaluación de calidad
- ✗"¿Cuál es la intención real detrás de esta frase ambigua?" — interpretación
🧪 Ejemplo práctico: grafo de enrutamiento de soporte en JSON
Objetivo: escribir el grafo de enrutamiento del soporte con aristas condicionales explícitas, una arista de escalamiento, otra para los casos no resueltos y otra de aprendizaje — y una unión que compruebe la cardinalidad. Ejecútalo en la consola del navegador (F12 → Console) o en Node.
// 1) O grafo de roteamento: cada aresta tem uma condicao explicita
const roteador = {
  "classificacao": [
    { "para": "faq",         "quando": "complexidade == 'baixa'" },
    { "para": "agente_ia",   "quando": "complexidade == 'media'" },
    { "para": "humano",      "quando": "complexidade == 'alta' || risco == 'alto'" }
  ],
  "faq":        [ { "para": "agente_ia", "quando": "resolvido == false" } ],
  "agente_ia":  [ { "para": "humano",    "quando": "resolvido == false" } ],
  "humano":     [ { "para": "classificacao", "quando": "feedback_dado == true", "tipo": "aprendizado" } ]
};

// 2) Juncao com checagem de cardinalidade (fan-in de N tickets em lote)
function fanIn(despachados, recebidos) {
  if (recebidos.length !== despachados.length) {
    throw new Error(`cardinalidade nao bate: recebi ${recebidos.length} de ${despachados.length}`);
  }
  return recebidos;
}

// 3) Rota um ticket de exemplo
function roteia(no, ctx) {
  const arestas = roteador[no] || [];
  for (const a of arestas) {
    // avaliacao simplificada da condicao 'quando' contra o contexto
    if (eval(a.quando.replace(/complexidade/g, `'${ctx.complexidade}'`).replace(/risco/g, `'${ctx.risco}'`).replace(/resolvido/g, ctx.resolvido).replace(/feedback_dado/g, ctx.feedback_dado))) {
      return a.para;
    }
  }
  return null; // nenhuma condicao casou -- pedido some, ver "como verificar"
}

console.log(roteia("classificacao", { complexidade: "media", risco: "baixo" })); // "agente_ia"
Cómo verificar:
- 1. Toda arista que sale de un nodo de decisión (
classificacao) tienequando— ninguna arista «cambia» sin una condición escrita. - 2. Las condiciones cubren todos los casos: prueba
roteia("classificacao", <contexto sem match>); si devuelvenull, existe una entrada que no coincide con ninguna condición y la solicitud desaparece en silencio. - 3. Hay un camino hasta la persona a partir de cualquier nodo: sigue las aristas de
faqeagente_iay confirma que ambas llegan ahumanocuandoresolvido == false.
Ahora cámbialo por el tuyo: reemplaza los nodos por
<etapas do seu suporte> y las condiciones por
<campos reais do seu ticket>. Ejecuta la prueba del punto 2 antes de pasar a producción.
Verificación rápida (no bloquea nada): un fan-in recibió 3 respuestas de un fan-out que despachó 5 ramas y siguió como si estuviera completo. ¿Cuál fue el error?
Conceptos clave
Lo que es una regla se convierte en `if`
Lo que exige interpretación
Toda entrada tiene un destino
Una regla escrita no consume tokens
📌 Resumen del módulo
Próximo módulo:
4.3 — Fallas, harness y observabilidad: merge que se traga la fuente, enrutamiento que no converge, monitor de quién ejecutó qué.