E1 · Evaluar 10 episodios
15 minInstala lerobot[pusht] y corre el lerobot-eval del cuadro (cpu o cuda).
Listo cuando: la terminal muestra pc_success y n_episodes: 10, y existe outputs/eval/act_200/eval_info.json.
Clase 6 · 16 min
Probar en el robot real cuesta tiempo, piezas y paciencia. El simulador te deja equivocarte mil veces gratis y te da un número: la tasa de éxito. Pero el número solo vale si la prueba es lo bastante difícil y si el mundo simulado se parece al real.
Comenzar la lección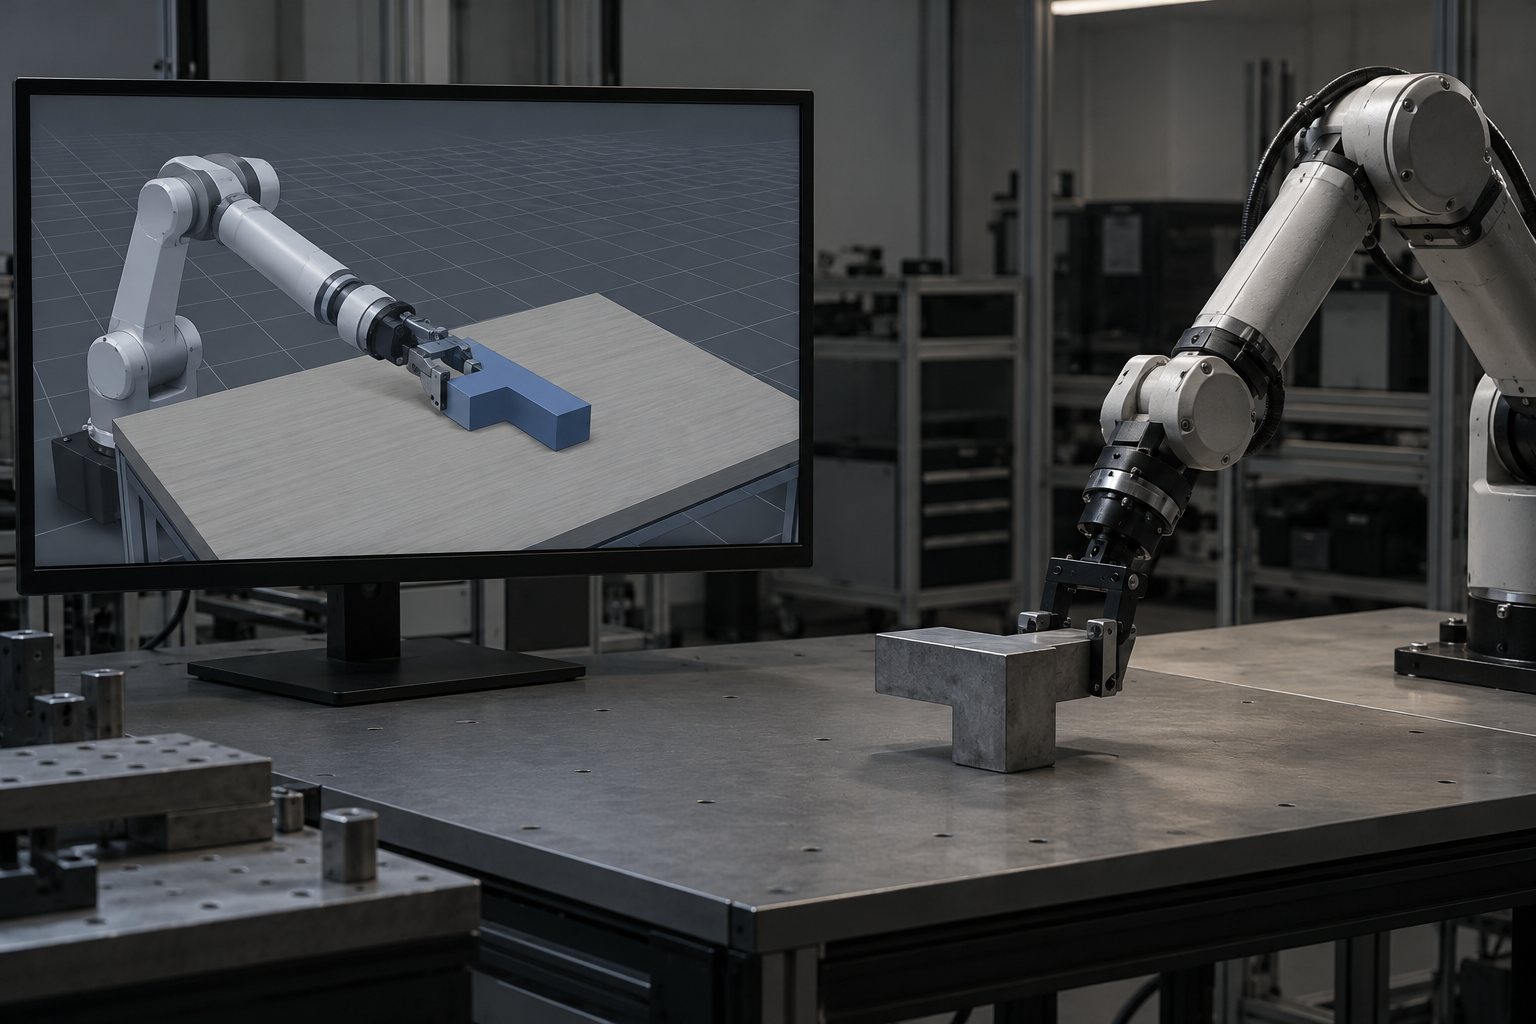
Objetivo: evaluar una política en simulación y saber por qué LIBERO solo ya no basta.
Haz clic en cada paso.
Simulación para equivocarte barato; benchmark para comparar; mundo real para decidir.
Haz clic en cada una.
En 2026 varios modelos pasan del 97% en LIBERO: OpenVLA-OFT 97,1%, X-VLA 98,1%, MolmoAct 2-Think 98,1%. Cuando todos sacan la nota máxima, la prueba no separa a nadie.
Por eso aparecen pruebas más duras (LIBERO-plus, RoboTwin 2.0) y evaluación real (RoboArena, MolmoBot).
En lugar de un simulador perfecto, varías a propósito color, luz, fricción, masa y posición de la cámara en cada episodio.
La política que aprende con tanta variación trata el mundo real como una variación más.
Mides el robot real (masa, fricción, retraso de los motores) y ajustas el simulador para que coincida.
MuJoCo 3.5.0 (feb/2026) trajo una caja de herramientas en Python para esto, además de retrasos de actuador y sensor.
Usa las dos juntas: mide lo que se pueda medir y randomiza el resto.
Instala el entorno simulado y corre la política que entrenaste en la clase 5.
pip install "lerobot[pusht]==0.6.1"
lerobot-eval \
  --policy.path=outputs/train/act_pusht_teste/checkpoints/last/pretrained_model \
  --env.type=pusht \
  --eval.n_episodes=10 \
  --eval.batch_size=10 \
  --eval.use_async_envs=false \
  --policy.device=cuda \
  --output_dir=outputs/eval/act_200
python -c "import json; d = json.load(open('outputs/eval/act_200/eval_info.json')); print(d['overall'])"
ls outputs/eval/act_200/videos/pusht_0/INFO ... Overall Aggregated Metrics:
INFO ... {'avg_sum_reward': 11.107..., 'avg_max_reward': 0.0824..., 'pc_success': 0.0, 'n_episodes': 10, 'eval_s': 9.46...}
INFO ... End of eval
# misma evaluación con el checkpoint de 5000 pasos (E3 de la clase 5), 20 episodios:
{'avg_sum_reward': 19.45..., 'avg_max_reward': 0.275..., 'pc_success': 0.0, 'n_episodes': 20, 'eval_s': 14.0...}LeRobot 0.6.1. Con 200 pasos: 13 s en total, tanto en GPU como solo en CPU (la evaluación es liviana). pc_success es la tasa de éxito en %; avg_max_reward muestra qué tan cerca llegó la política del objetivo (mayor es mejor). Los dos entrenamientos cortos dan 0% de éxito: la política aún no empuja la T hasta el objetivo, pero con 5000 pasos llega más cerca (0,08 → 0,28).
--eval.use_async_envs=false lo resolvió.lerobot/diffusion_pusht pide migración de formato en la 0.6 y no corre directo. Evalúa el tuyo.SDL_VIDEODRIVER=dummy antes del comando.Usa el checkpoint de la clase 5.
Instala lerobot[pusht] y corre el lerobot-eval del cuadro (cpu o cuda).
Listo cuando: la terminal muestra pc_success y n_episodes: 10, y existe outputs/eval/act_200/eval_info.json.
Abre dos videos en outputs/eval/act_200/videos/pusht_0/ y describe en una frase qué hace mal la política.
Listo cuando: tu frase dice dónde falla (no llega al bloque, empuja hacia el lado equivocado, se detiene a mitad de camino).
Si hiciste el entrenamiento de 5000 pasos, evalúa también (cambia el --policy.path y el --output_dir) y compara avg_max_reward.
Listo cuando: tienes los dos números lado a lado y sabes decir cuál política llegó más cerca del objetivo.
La explicación aparece después de tu respuesta.
Pregunta 1 de 4
¿Qué mide el pc_success de lerobot-eval?competencia
Pregunta 2 de 4
¿Por qué LIBERO por sí solo ya no sirve para comparar VLAs?
Pregunta 3 de 4
Variar a propósito la luz, la fricción y la masa en el simulador en cada episodio es…
Pregunta 4 de 4
Tu política tuvo 0% de éxito y avg_max_reward subió de 0,08 a 0,28 con más entrenamiento. ¿Qué concluyes?
Elige una alternativa. La explicación aparece después de tu intento.