Pregunta 10 · 🛡️ Pruebas de seguridad
¿Ejecuto el modelo en mi máquina, con un proveedor o en un servicio como RunPod?
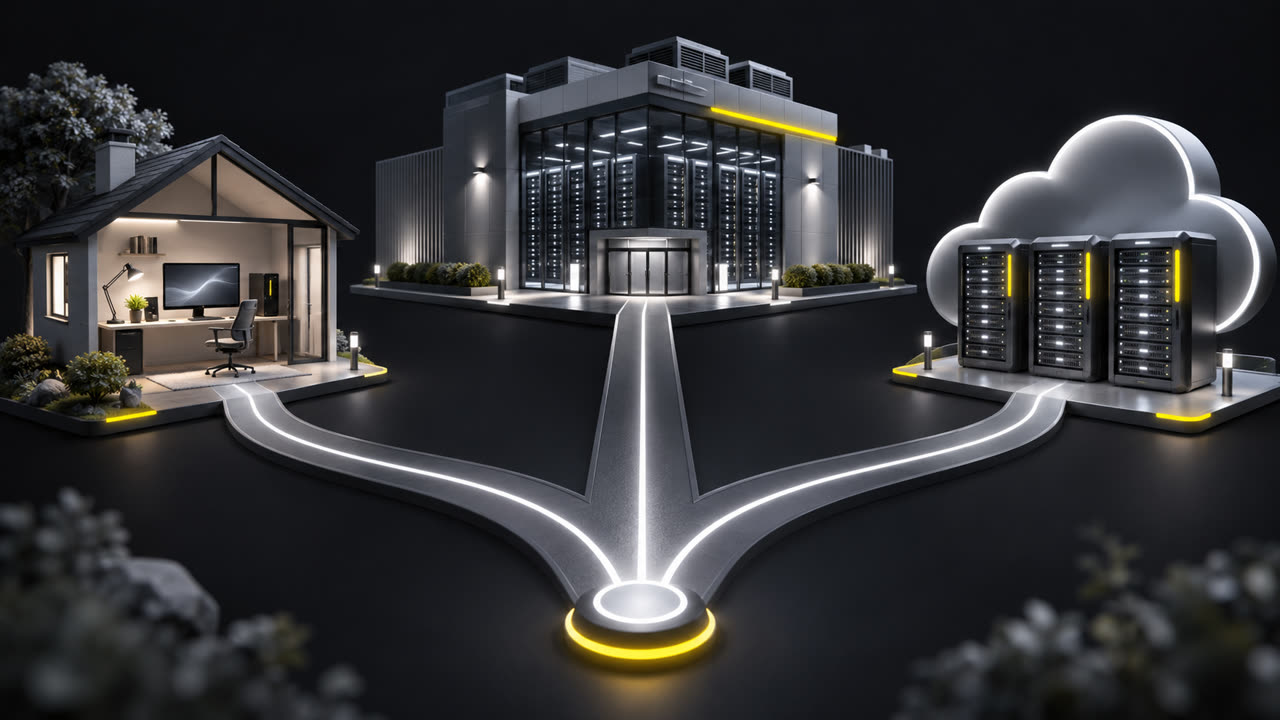
El lugar donde se ejecuta el modelo afecta el costo, la privacidad, la velocidad y el trabajo de mantenimiento. No hay una opción correcta para todos; existe una que se ajusta a tus datos, tu hardware y tu volumen de uso.
Ejecutarlo por tu cuenta te da más control sobre la configuración. Un servicio alojado se encarga de la infraestructura y cobra por esa comodidad. RunPod, un servicio que alquila por hora computadoras con una tarjeta gráfica (GPU) potente, es una opción para alojar el modelo cuando tu máquina no puede con la tarea.
Distingue dónde se ejecuta el modelo de dónde se ejecutan las herramientas. Llevar el modelo a la nube no traslada automáticamente el resto del flujo de pruebas.
Y siempre: realiza pruebas solo con permiso del dueño del sistema y con el alcance (qué se puede y qué no se puede probar) acordado por escrito antes de empezar.
En tu computadora
Herramientas como Ollama, o MLX en las Mac con chip de Apple, ejecutan modelos abiertos en tu computadora. Los datos no salen de ahí y tú controlas la versión y la configuración. El límite es el hardware: los modelos grandes piden mucha memoria y una GPU (tarjeta gráfica usada para cálculos de IA) potente. Por eso, en computadoras comunes, suelen ejecutarse solo modelos más pequeños.
A través de un proveedor
Servicios como Claude o Codex ofrecen modelos de punta listos para usar, mediante suscripción o API. No tienes que ocuparte del servidor, las actualizaciones ni la capacidad. A cambio, los datos pasan por el proveedor, sus reglas de uso se aplican y el modelo puede cambiar sin aviso. Lee la política de datos y las reglas de uso antes de enviar información sensible o hacer pruebas de seguridad.
GPU alquilada
Servicios como RunPod alquilan por hora una computadora con una GPU potente. Puedes ejecutar modelos abiertos más grandes sin comprar hardware, pero instalas, configuras y apagas todo por tu cuenta. Una computadora que se queda encendida sigue generando cargos. Funciona bien para usos por períodos: una prueba de unos días, un lote de procesamiento o una comparación entre modelos.
Modelo y herramientas
El modelo puede estar en la nube mientras las herramientas de prueba se ejecutan en tu red, o al revés. Decide dónde estará cada parte según lo que debe alcanzar y los datos que utiliza. Protege la conexión entre ambas partes para no exponer la GPU alquilada ni el tráfico de la prueba. Haz pruebas solo con autorización y alcance por escrito.
En tu máquina
- Control total
- Depende de tu hardware
Proveedor
- Ellos se encargan de la infraestructura
- Pagas por la comodidad
Nube alquilada
- GPU bajo demanda
- Tú lo configuras
- Clasifica los datos: cuáles pueden salir de tu red y cuáles no.
- Comprueba si tu hardware puede ejecutar el modelo que necesitas.
- Calcula cuántas horas de uso tendrás al mes.
- Elige por separado dónde se ejecutan el modelo y las herramientas.
- Protege la conexión entre ambas partes y apaga lo que alquiles al terminar.
- Acorda por escrito el alcance de cualquier prueba antes de empezar.
- Enviar datos sensibles a un proveedor sin leer la política de datos.
- Olvidar una GPU alquilada encendida y pagar por horas sin uso.
- Creer que al poner el modelo en la nube todo el resto del proceso también se traslada.
- Local = control.
- Proveedor = comodidad con costo.
- El modelo y las herramientas pueden estar en lugares distintos.
- CursoKit Local — el laboratorio localEjecuta modelos en tu máquina con Ollama: qué cabe en cada configuración.
- ProyectoQué modelo de IA usarEl modelo adecuado para cada tarea, con reglas sencillas para elegir.
- CursoCCOpen — Claude Code gratis o por casi nadaCambia el modelo por uno local o por uno de un proveedor económico.
Algunos de estos materiales están en portugués.