Pergunta 10 · 🛡️ Testes de segurança
Rodar o modelo na minha máquina, por um provedor ou num serviço como o RunPod?
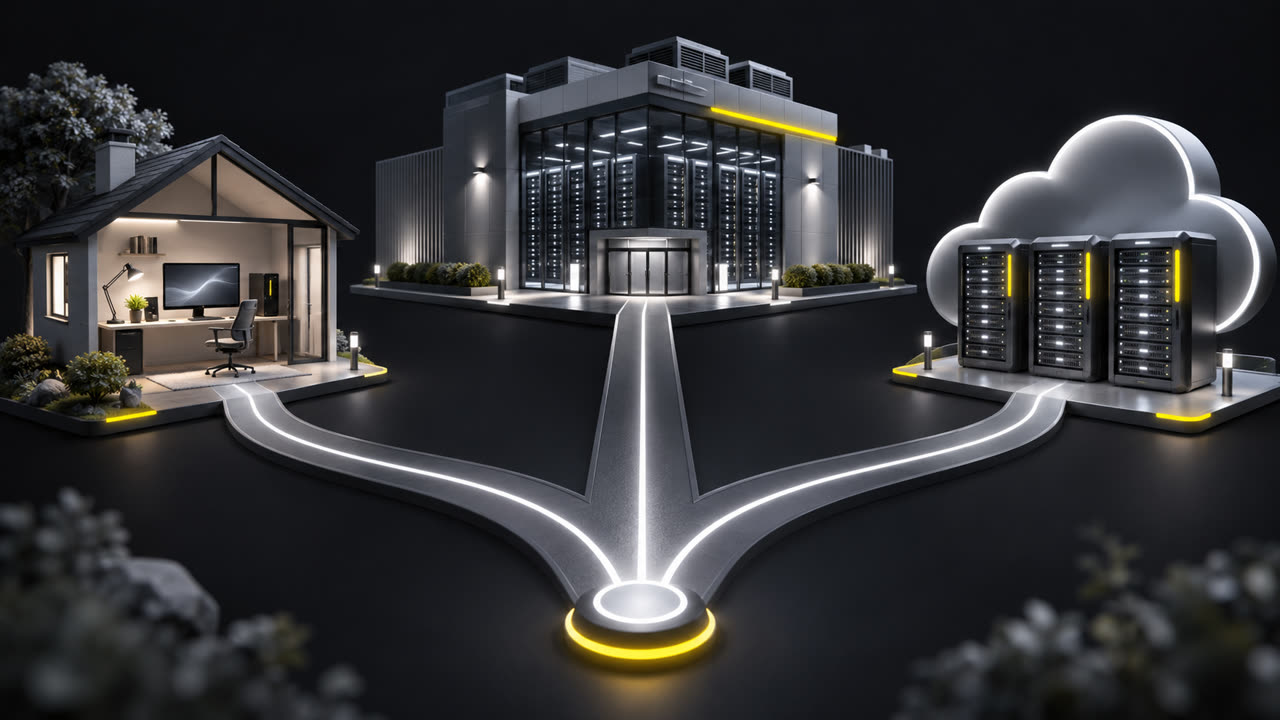
Onde o modelo roda afeta custo, privacidade, velocidade e trabalho de manutenção. Não existe opção certa para todos; existe a que combina com seus dados, seu hardware e seu volume de uso.
Rodar por conta própria dá mais controle sobre a configuração. Um serviço hospedado cuida da infraestrutura e cobra por essa comodidade. O RunPod, um serviço que aluga por hora computadores com placa de vídeo (GPU) potente, é uma opção para hospedar o modelo quando sua máquina não dá conta.
Separe onde o modelo roda de onde as ferramentas rodam. Pôr o modelo na nuvem não leva automaticamente o resto do fluxo de testes junto.
E sempre: testes só com permissão do dono do sistema e com o escopo (o que pode e o que não pode ser testado) combinado por escrito antes de começar.
Na sua máquina
Ferramentas como Ollama, ou MLX nos Macs com chip Apple, rodam modelos abertos no seu computador. Os dados não saem dali e você controla a versão e a configuração. O limite é o hardware: modelos grandes pedem muita memória e uma GPU (placa de vídeo usada para cálculos de IA) forte. Por isso, em máquinas comuns, costumam rodar só modelos menores.
Por um provedor
Serviços como Claude ou Codex entregam modelos de ponta prontos, por assinatura ou por API. Você não cuida de servidor, atualização nem capacidade. Em troca, os dados passam pelo provedor, as regras de uso são dele e o modelo pode mudar sem aviso. Leia a política de dados e as regras de uso antes de enviar informação sensível ou fazer testes de segurança.
GPU alugada
Serviços como o RunPod alugam por hora uma máquina com GPU potente. Você roda modelos abertos maiores sem comprar hardware, mas instala, configura e desliga tudo sozinho. Máquina esquecida ligada continua cobrando. Funciona bem para uso em blocos: um teste de alguns dias, um lote de processamento, uma comparação entre modelos.
Modelo e ferramentas
O modelo pode estar na nuvem enquanto as ferramentas de teste rodam na sua rede, ou o contrário. Decida onde cada parte fica conforme o que ela precisa alcançar e quais dados ela toca. E proteja a conexão entre as duas partes, para não expor a GPU alugada nem o tráfego do teste. Testes, sempre só com autorização e escopo por escrito.
Na sua máquina
- Controle total
- Depende do seu hardware
Provedor
- Infra cuidada por eles
- Paga a conveniência
Nuvem alugada
- GPU sob demanda
- Você configura
- Classifique os dados: o que pode e o que não pode sair da sua rede.
- Confira se seu hardware roda o modelo que você precisa.
- Estime quantas horas de uso por mês você terá.
- Escolha onde o modelo roda e, separadamente, onde as ferramentas rodam.
- Proteja a conexão entre as partes e desligue o que for alugado ao terminar.
- Combine por escrito o escopo de qualquer teste antes de começar.
- Mandar dados sensíveis a um provedor sem ler a política de dados.
- Esquecer uma GPU alugada ligada e pagar por horas paradas.
- Achar que pôr o modelo na nuvem leva o resto do fluxo junto.
- Local = controle.
- Provedor = conveniência paga.
- Modelo e ferramentas podem morar em lugares diferentes.
- CursoKit Local — o laboratório localRodar modelos na sua máquina com Ollama: o que cabe em cada configuração.
- ProjetoQual modelo de IA usarO modelo certo para cada tarefa, com regras simples de escolha.
- CursoCCOpen — Claude Code de graça ou por quase nadaTrocar o modelo por um local ou por um provedor barato.